- #1
Claude Haiku 5.5
Anthropic | 1 000 000 tokens kontext | $0.10/M input, $0.50/M output. Claude Haiku 5.5 är Anthropics lilla, snabba modell för högvolyms- och kostnadskänsligt arbete som sammanfattning, underagenter och webbläsaranvändning. Den efterträder…Anthropic | 1 000 000 tokens kontext | $0.10/M input, $0.50/M output. Claude Haiku 5.5 är Anthropics lilla, snabba modell för högvolyms- och kostnadskänsligt arbete som sammanfattning, underagenter och webbläsaranvändning. Den efterträder Claude Haiku 4.5 med starkare kodning, datoranvändning och kunskapsarbete, och accepterar text- och bildindata med ett kontextfönster på 1 miljon tokens. Det är den första Haiku-modellen med justerbar ansträngning. Tänkandet är adaptivt och på som standard, med ansträngning som huvudreglage för att balansera djup, latens och kostnad; det kan stängas av vid låg, medium och hög ansträngning.
- #2
Qwen3.6 35B A3B
Qwen | 262,144 token context | $0.15/M input, $1.00/M output. Qwen3.6-35B-A3B is an open-weight multimodal model from Alibaba Cloud with 35 billion total parameters and 3 billion active parameters per token. It uses a hybrid sparse…Qwen | 262,144 token context | $0.15/M input, $1.00/M output. Qwen3.6-35B-A3B is an open-weight multimodal model from Alibaba Cloud with 35 billion total parameters and 3 billion active parameters per token. It uses a hybrid sparse mixture-of-experts architecture combining Gated DeltaNet linear attention with standard gated attention layers, enabling efficient inference at a fraction of the compute cost. The model supports a 262K token native context window (extensible to 1M via YaRN) and accepts text, image, and video inputs. It includes integrated thinking mode with reasoning traces preserved across multi-turn conversations, function calling, and structured output. Released under the Apache 2.0 license.
- #3
Claude Opus 5.5
Anthropic | 1 000 000 tokens kontext | $4.00/M input, $20.00/M output. Claude Opus 5.5 är Anthropics flaggskeppsmodell för krävande resonemang, kodning och långsiktigt agentarbete, efterföljare till Claude Opus 5. Den är särskilt stark vid…Anthropic | 1 000 000 tokens kontext | $4.00/M input, $20.00/M output. Claude Opus 5.5 är Anthropics flaggskeppsmodell för krävande resonemang, kodning och långsiktigt agentarbete, efterföljare till Claude Opus 5. Den är särskilt stark vid flerstegsändringar i stora kodbaser, kodgranskning och buggfinnande, finansiell och vetenskaplig analys samt läsning av täta diagram, scheman och skärmdumpar, och är mer försiktig än sin föregångare med att endast ange siffror och citera källor den kan styrka. Modellen slutför jämförbara uppgifter med färre steg och färre tokens än Opus 5, och rapporterar sitt arbete i enklare språk med tydliga uppdateringar om vad den gjorde, vad den fann och vad den behöver från användaren. Tänkande är alltid adaptivt, så ansträngning är huvudreglaget för att balansera djup, latens och kostnad, och lägre ansträngningsinställningar förblir effektiva för latenskänsliga arbetsbelastningar.
- #4
Qwen Image 2.1 Restore LoRA
By AusBoss - A LoRA that softens the harsh upscale Qwen Image 2.1 does by itself: the result is a little softer, still detailed, makes up less, and stays true to your picture. Qwen Image 2.1 can upscale a small or worn picture without this…By AusBoss - A LoRA that softens the harsh upscale Qwen Image 2.1 does by itself: the result is a little softer, still detailed, makes up less, and stays true to your picture. Qwen Image 2.1 can upscale a small or worn picture without this LoRA, but it overdoes it. Skin turns gritty, pores and freckles show up that were not there, faces look older, and the picture shifts a few pixels. With this LoRA the result stays on your picture. Blurry photos need a lower strength. If your picture is out of focus, shaky, or a frame from a video, set the LoRA to 0.5. At 1.0 it stays true to the blur and the result comes back soft. A small or compressed picture that is in focus is fine at 1.0. No trigger word. Start at strength 1.0, enlarge your picture to about 2 megapixels, give it as image 1, and ask: Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors. For scratched or faded prints: Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people. On an old print it takes out scratches, dust and grain and brings back most of the color.
- #5
Solar Mini 4
Upstage | 524 288 tokens kontext | $0.05/M input, $0.20/M output. Solar Mini 4 är Upstages kompakta, kostnadseffektiva språkmodell, en 35 miljarder parameter mixture-of-experts med 3 miljarder aktiva parametrar och ett kontextfönster på…Upstage | 524 288 tokens kontext | $0.05/M input, $0.20/M output. Solar Mini 4 är Upstages kompakta, kostnadseffektiva språkmodell, en 35 miljarder parameter mixture-of-experts med 3 miljarder aktiva parametrar och ett kontextfönster på 524K. Den är byggd för agentbaserade användningsfall där svarshastighet och kostnad är viktiga, med flytande koreanska samt stark engelska och japanska, och stöd för långkontextarbetsflöden. Vid användning av BYOK med ZDR-krav måste Console API-nyckeln tillhöra en ZDR-aktiverad Upstage-organisation. Kontakta Upstage för att aktivera ZDR på din organisation.
- #6
GPT 6.1 Sol
OpenAI | 1 050 000 tokens kontext | $2.00/M input, $10.00/M output. GPT-6.1 Sol är en uppgradering av GPT-6 Sol från OpenAI, placerad under flaggskeppet GPT-6 Astra i GPT-6-serien. Den är lämpad för agentbaserad kodning, datoranvändning,…OpenAI | 1 050 000 tokens kontext | $2.00/M input, $10.00/M output. GPT-6.1 Sol är en uppgradering av GPT-6 Sol från OpenAI, placerad under flaggskeppet GPT-6 Astra i GPT-6-serien. Den är lämpad för agentbaserad kodning, datoranvändning, dokumentintensivt professionellt arbete och flerstegs affärsautomatisering, och når Astra-nivåresultat i dessa uppgifter till en mycket lägre kostnad. Jämfört med GPT-6 Sol gör den färre faktamissar och är mer pålitlig när det gäller att respektera uttryckliga begränsningar och användarens avsikt under agentuppgifter.
- #7
Mistral Large 4
Mistral | 1 048 576 tokens kontext | $0.68/M indata, $2.09/M utdata. Mistral Large 4 är en toppmodern multimodal (text- och bildindata) modell från Mistral AI byggd för resonemang, kodning och agentuppgifter. Den erbjuder ett 1M-token…Mistral | 1 048 576 tokens kontext | $0.68/M indata, $2.09/M utdata. Mistral Large 4 är en toppmodern multimodal (text- och bildindata) modell från Mistral AI byggd för resonemang, kodning och agentuppgifter. Den erbjuder ett 1M-token kontextfönster med upp till 256K output tokens och stödjer verktygsanrop och strukturerade utdata.
- #8
Claude Sonnet 5.5
Anthropic | 1 000 000 tokens kontext | $2.00/M input, $10.00/M output. Claude Sonnet 5.5 är Anthropics Sonnet-klassmodell för välavgränsat vardagsarbete, efterföljare till Claude Sonnet 5 som en direkt uppgradering. Den är särskilt stark…Anthropic | 1 000 000 tokens kontext | $2.00/M input, $10.00/M output. Claude Sonnet 5.5 är Anthropics Sonnet-klassmodell för välavgränsat vardagsarbete, efterföljare till Claude Sonnet 5 som en direkt uppgradering. Den är särskilt stark vid funktionsbyggande, buggfixning och produktion av polerade dokument, presentationer och kalkylblad, och den skriver och kommunicerar tydligare än sin föregångare. Tänkande är alltid på, så ansträngning är huvudreglaget för att balansera djup, latens och kostnad, och lägre ansträngningsinställningar håller den responsiv för vardagliga agentloopar.
- #9
Nemotron 3 Super
NVIDIA | 262 144 tokens kontext | $0.08/M input, $0.45/M output. NVIDIA Nemotron 3 Super är en 120 miljarder parameter öppen hybrid MoE-modell som aktiverar endast 12 miljarder parametrar för maximal beräkningseffektivitet och noggrannhet…NVIDIA | 262 144 tokens kontext | $0.08/M input, $0.45/M output. NVIDIA Nemotron 3 Super är en 120 miljarder parameter öppen hybrid MoE-modell som aktiverar endast 12 miljarder parametrar för maximal beräkningseffektivitet och noggrannhet i komplexa multi-agent-applikationer. Byggd på en hybrid Mamba-Transformer Mixture-of-Experts-arkitektur med multi-token-prediktion (MTP), levererar den över 50 % högre tokengenerering jämfört med ledande öppna modeller. Modellen har ett kontextfönster på 1 miljon tokens för långsiktig agentkoherens, tvärdokumentresonemang och flerstegsplanering. Latent MoE möjliggör anrop av 4 experter till kostnaden av endast en, vilket förbättrar intelligens och generalisering. Multi-miljö RL-träning över 10+ miljöer ger ledande noggrannhet på benchmarks inklusive AIME 2025, TerminalBench och SWE-Bench Verified. Fullt öppen med vikter, dataset och recept under NVIDIA Open License, Nemotron 3 Super möjliggör enkel anpassning och säker distribution var som helst – från arbetsstation till moln.
- #10
GLM 5.3
Z.ai | 1 048 576 tokens kontext | $0.08/M input, $4.80/M output. GLM-5.3 är en storskalig resonemangsmodell från Z.ai, byggd för komplex mjukvaruutveckling och långsiktiga agentuppgifter. Den stödjer textinmatning och -utmatning med ett…Z.ai | 1 048 576 tokens kontext | $0.08/M input, $4.80/M output. GLM-5.3 är en storskalig resonemangsmodell från Z.ai, byggd för komplex mjukvaruutveckling och långsiktiga agentuppgifter. Den stödjer textinmatning och -utmatning med ett kontextfönster på 1 miljon tokens, och förbättrar GLM-5.2 inom kodning och balansen mellan prestanda och token-effektivitet. Resonemang är alltid aktiverat och kan inte stängas av. Resonemangsnivåer low, high och max stöds; max är standard.
- #11
Nemotron 3.5 Lightning
NVIDIA | 262 144 tokens kontext | $0.07/M input, $0.20/M output. NVIDIA Nemotron 3.5 Lightning är en öppen mixture-of-experts-modell från NVIDIA, med 3 miljarder aktiva parametrar av totalt 30 miljarder. Den är lämpad för höggenomströmning…NVIDIA | 262 144 tokens kontext | $0.07/M input, $0.20/M output. NVIDIA Nemotron 3.5 Lightning är en öppen mixture-of-experts-modell från NVIDIA, med 3 miljarder aktiva parametrar av totalt 30 miljarder. Den är lämpad för höggenomströmning agentbaserade arbetsuppgifter och specialiserade uppgifter som gynnas av domänspecifik anpassning.
- #12
Ling 3.1 Flash
inclusionAI | 262,144 token context | $0.07/M input, $0.22/M output. Ling 3.1 Flash is a hybrid reasoning mixture-of-experts model from inclusionAI, with 25B active parameters out of 560B total. - #13
Gemma 4 26B A4B
Google | 262 144 tokens kontext | $0.09/M input, $0.30/M output. Gemma 4 26B A4B IT är en instruktionsfinjusterad Mixture-of-Experts (MoE) modell från Google DeepMind. Trots 25,2 miljarder totala parametrar aktiveras endast 3,8 miljarder…Google | 262 144 tokens kontext | $0.09/M input, $0.30/M output. Gemma 4 26B A4B IT är en instruktionsfinjusterad Mixture-of-Experts (MoE) modell från Google DeepMind. Trots 25,2 miljarder totala parametrar aktiveras endast 3,8 miljarder per token under inferens – vilket levererar nästan 31 miljarder kvalitetsnivå till en bråkdel av beräkningskostnaden. Stöder multimodal input inklusive text, bilder och video (upp till 60 sekunder vid 1 fps). Har ett kontextfönster på 256K tokens, inbyggda funktionsanrop, konfigurerbart tänkande/resonemangs-läge och stöd för strukturerad output. Släppt under Apache 2.0.
- #14
MiMo V2.6 Pro
Xiaomi | 1 050 000 tokens kontext | $0.43/M input, $0.87/M output. MiMo-V2.6-Pro är Xiaomis flaggskeppsgrundmodell. Byggd med över 1 biljon parametrar, är den designad för att tänja på gränserna för kapacitet vid de mest krävande…Xiaomi | 1 050 000 tokens kontext | $0.43/M input, $0.87/M output. MiMo-V2.6-Pro är Xiaomis flaggskeppsgrundmodell. Byggd med över 1 biljon parametrar, är den designad för att tänja på gränserna för kapacitet vid de mest krävande arbetsuppgifterna. Modellen har ett kontextfönster på 1 miljon tokens och inbyggda multimodala funktioner. Optimerad för agentbaserade arbetsflöden levererar den topprestanda inom kodning, visuella, generella och forskningsscenarier, och utmärker sig vid komplexa, långsiktiga uppgifter med robust generalisering över en mångfald av agentplattformar.
- #15
Muse Spark 1.3 Contributor
Meta | 1 048 576 tokens kontext | $0.10/M input, $0.20/M output. Muse Spark 1.3 Contributor är den kostnadseffektiva bidragsnivån i Metas multimodala resonemangsmodell för experiment, lärande och tidiga agent-, multi-agent- och…Meta | 1 048 576 tokens kontext | $0.10/M input, $0.20/M output. Muse Spark 1.3 Contributor är den kostnadseffektiva bidragsnivån i Metas multimodala resonemangsmodell för experiment, lärande och tidiga agent-, multi-agent- och kodningsarbetsflöden. Den är designad för att följa information över utökade uppgifter, arbeta igenom motstridiga indata och begära förtydliganden eller bekräftelser vid behov. Prompter och utdata kan användas för att förbättra Metas produkter.
- #16
GPT 6 Luna
OpenAI | 1 050 000 tokens kontext | $0.10/M input, $0.50/M output. GPT-6 Luna är den snabba och kostnadseffektiva modellen i OpenAI:s GPT-6-serie, placerad under GPT-6 Sol. Den är lämpad för högvolyms- och latenskänsliga arbetsbelastningar…OpenAI | 1 050 000 tokens kontext | $0.10/M input, $0.50/M output. GPT-6 Luna är den snabba och kostnadseffektiva modellen i OpenAI:s GPT-6-serie, placerad under GPT-6 Sol. Den är lämpad för högvolyms- och latenskänsliga arbetsbelastningar som chatt, klassificering och lätta agentuppgifter, och vid högre resonemangsnivå kan den hantera komplex mjukvaruutveckling och datoranvändningsuppgifter som tidigare krävde en Sol-nivåmodell. Den delar GPT-6-familjens förbättringar i faktuell tillförlitlighet och dess tydligare, mer koncisa kommunikationsstil.
- #17
MiMo V2.6 Flash
Xiaomi | 1 050 000 tokens kontext | $0.14/M input, $0.28/M output. MiMo-V2.6-Flash är en öppen källkodsbaserad grundmodell utvecklad av Xiaomi. Byggd på en Mixture-of-Experts-arkitektur med totalt 309 miljarder parametrar och 15 miljarder…Xiaomi | 1 050 000 tokens kontext | $0.14/M input, $0.28/M output. MiMo-V2.6-Flash är en öppen källkodsbaserad grundmodell utvecklad av Xiaomi. Byggd på en Mixture-of-Experts-arkitektur med totalt 309 miljarder parametrar och 15 miljarder aktiverade per token, använder den en hybrid uppmärksamhetsmekanism för större beräknings-effektivitet. Modellen har ett kontextfönster på 1 miljon tokens och inbyggda multimodala möjligheter. Optimerad för agentbaserade arbetsflöden levererar den stark prestanda inom kodning, visuella, generella och forskningsscenarier, och utmärker sig i komplexa, långsiktiga uppgifter med robust generalisering över ett brett spektrum av agentramverk.
- #18

DeepSeek V4.1 Flash
DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B…DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B parameters on input and 16B on output from a 552B-parameter backbone, an asymmetric split that keeps per-token compute low relative to the model's total size. Image understanding is native to the architecture, with visual and text embeddings trained jointly from the start of pre-training rather than added afterward as in the earlier experimental V4 Flash Vision ExpOpens in new tab. It is suited for coding, terminal, and computer-use agents, along with long-horizon tasks that must run to completion across many steps and long-context analysis. Compressed KV caching cuts cache memory to roughly a quarter of the previous Flash generation, significantly reducing costs on agentic workloads. DeepSeek positions it as the cost-efficient tier of the V4.1 family and reports that it exceeds V4 ProOpens in new tab on performance, speed, and task completion time.
- #19
Qwen3.8 Flash
Qwen | 1 000 000 tokens kontext | $0.15/M input, $0.47/M output. Qwen3.8 Flash är en multimodal resonemangsmodell från Alibaba. Den är lämpad för kodningsassistans, agentbaserade arbetsflöden, visuell förståelse, dokument- och…Qwen | 1 000 000 tokens kontext | $0.15/M input, $0.47/M output. Qwen3.8 Flash är en multimodal resonemangsmodell från Alibaba. Den är lämpad för kodningsassistans, agentbaserade arbetsflöden, visuell förståelse, dokument- och kodbasanalys, skrivbordsinteraktion, diagramanalys och långvideanalys.
- #20
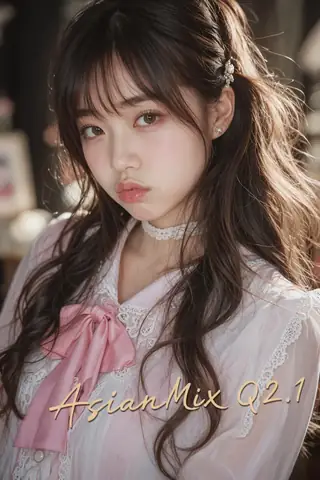
[Qwen Image] Asian Mix Lora
by hinablue - [Qwen Image] Asian Mix Lora - v3.0 - Q21 - rank64 Trained using a custom-built trainer with a dataset of 6,000 images, using Rank 64, and merged with v2.0 via SVD to create this LoRA. It is more stable at a weight below 0.8.…by hinablue - [Qwen Image] Asian Mix Lora - v3.0 - Q21 - rank64 Trained using a custom-built trainer with a dataset of 6,000 images, using Rank 64, and merged with v2.0 via SVD to create this LoRA. It is more stable at a weight below 0.8. Limb/anatomy issues may still occasionally occur, so please use at your own discretion.
- #21
Qwen3.8 27B
Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent…Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent tasks, with flexible thinking that can be enabled or disabled.
- #22
Claude Fable 5.1
Anthropic | 1 000 000 tokens kontext | $10.00/M input, $50.00/M output. Claude Fable 5.1 förbättrar Claude Fable 5 på alla områden, med de största vinsterna inom agentkodning, långvariga agentarbetsflöden och kunskapsarbete: långa…Anthropic | 1 000 000 tokens kontext | $10.00/M input, $50.00/M output. Claude Fable 5.1 förbättrar Claude Fable 5 på alla områden, med de största vinsterna inom agentkodning, långvariga agentarbetsflöden och kunskapsarbete: långa kodrefaktorer, front-end och visuell kodgenerering samt särskilt finans- och analystjänster. Den tenderar också att vara mer koncis än Fable 5 i sina planer och sammanfattningar. Vi rekommenderar att testa den som en direkt uppgradering där du använder Fable 5 idag, och tillsammans med Opus 5 vid resonemangsintensiva uppgifter.
- #23
Hy3
Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production…Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production use. It supports a configurable reasoning effort: a direct no-think mode by default, plus low and high chain-of-thought modes for complex math, coding, and multi-step problems. With a 256K context window, Hy3 targets long-horizon tasks, including improved coreference resolution, multi-turn constraint tracking, and stable tool-calling that generalizes across agent scaffoldings. Tencent positions it as a reliable, cost-effective option across coding, document processing, financial analysis, game development, and frontend design, with a strong emphasis on grounded, anti-hallucination behavior that answers when grounded and flags when evidence is missing rather than fabricating.
- #24
Gemma 4 31B
Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable…Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable thinking/reasoning mode, native function calling, and multilingual support across 140+ languages. Strong on coding, reasoning, and document understanding tasks. Apache 2.0 license.
- #25
gpt oss 120b
OpenAI | 131 072 tokens kontext | $0.15/M input, $0.60/M output. gpt-oss-120b är en öppen vikt, 117 miljarder parameter Mixture-of-Experts (MoE) språkmodell från OpenAI designad för högresonemang, agentbaserade och allmänna…OpenAI | 131 072 tokens kontext | $0.15/M input, $0.60/M output. gpt-oss-120b är en öppen vikt, 117 miljarder parameter Mixture-of-Experts (MoE) språkmodell från OpenAI designad för högresonemang, agentbaserade och allmänna produktionsanvändningsfall. Den aktiverar 5,1 miljarder parametrar per framåtpass och är optimerad för att köras på en enda H100 GPU med inbyggd MXFP4-kvantisering. Modellen stödjer konfigurerbar resonemangsdjup, full kedja-av-tanke-åtkomst och inbyggd verktygsanvändning, inklusive funktionsanrop, webbläsning och strukturerad outputgenerering.
- #26
Space Bunny Alpha
stealth | 1 000 000 tokens kontext | gratis att använda. Space Bunny Alpha är en anonym stor modell med blixtsnabb inferens, starka kodningsförmågor och inbyggt multimodalt stöd för inmatning. Den erbjuder justerbar resonemangsansträngning…stealth | 1 000 000 tokens kontext | gratis att använda. Space Bunny Alpha är en anonym stor modell med blixtsnabb inferens, starka kodningsförmågor och inbyggt multimodalt stöd för inmatning. Den erbjuder justerbar resonemangsansträngning och ett kontextfönster på 1 miljon tokens. Space...
- #27
GPT 6 Luna Pro
OpenAI | 1 050 000 tokens kontext | $0.10/M indata, $0.50/M utdata. GPT-6 Luna Pro är samma underliggande modell som GPT-6 Luna, serverad med reasoning.mode satt till pro för högre kvalitet på svar vid komplexa uppgifter. Kostnadsnotering:…OpenAI | 1 050 000 tokens kontext | $0.10/M indata, $0.50/M utdata. GPT-6 Luna Pro är samma underliggande modell som GPT-6 Luna, serverad med reasoning.mode satt till pro för högre kvalitet på svar vid komplexa uppgifter. Kostnadsnotering: pro-läget använder betydligt fler resonemangstokens per förfrågan, så en typisk förfrågan kostar flera gånger mer än samma förfrågan på GPT-6 Luna och tar mycket längre tid att slutföra. Den är avsedd för svåra, höginsatsproblem där extra noggrannhet motiverar kostnaden. För vardaglig kodning, agent- och chattuppgifter, använd istället GPT-6 Luna. Läs mer i OpenAIs dokumentation: https://developers.openai.com/api/docs/guides/reasoning#reasoning-mode
- #28
Qwen Image 2.1 Outfit Swap Consistency LoRA
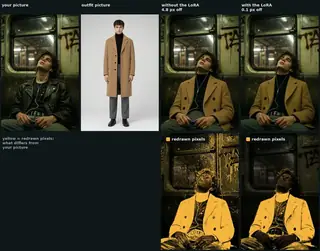
by AusBoss - Qwen Image 2.1 Outfit Swap Consistency LoRA - Qwen Image 2.1 can already dress a person in the outfit from another picture. The result comes back a few pixels off, the face a little softer, the background repainted. With this…by AusBoss - Qwen Image 2.1 Outfit Swap Consistency LoRA - Qwen Image 2.1 can already dress a person in the outfit from another picture. The result comes back a few pixels off, the face a little softer, the background repainted. With this LoRA only the clothes change. No trigger word. Load it at strength 1.0, give the person as image 1 and the outfit as image 2, and ask for the swap
- #29
Hy4 preview
Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows,…Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows, and productivity tasks that require planning, context continuity, and sustained multi-step execution.
- #30
GPT 6 Sol
OpenAI | 1 050 000 tokens kontext | $2.00/M input, $10.00/M output. GPT-6 Sol är den kostnadseffektiva högpresterande modellen i OpenAIs GPT-6-serie, placerad under flaggskeppet GPT-6 Astra och över den snabba GPT-6 Luna-nivån. Den är…OpenAI | 1 050 000 tokens kontext | $2.00/M input, $10.00/M output. GPT-6 Sol är den kostnadseffektiva högpresterande modellen i OpenAIs GPT-6-serie, placerad under flaggskeppet GPT-6 Astra och över den snabba GPT-6 Luna-nivån. Den är lämpad för krävande professionellt arbete, agentbaserad kodning, affärsautomatisering och datoranvändning, och är särskilt stark vid långsiktiga mjukvarutekniska uppgifter i verkliga kodbaser. Den når Astra-nivå i faktamässig tillförlitlighet till en mycket lägre kostnad och delar Astras tydligare och mer koncisa kommunikationsstil i tekniska och kodningssamtal.
- #31
MiniMax M3
MiniMax | 1 048 576 tokens kontext | $0.30/M input, $1.20/M output. MiniMax-M3 är en multimodal grundmodell från MiniMax. Den stödjer text-, bild- och videoinmatningar med textutmatning, ett kontextfönster på 1 miljon tokens och är lämpad…MiniMax | 1 048 576 tokens kontext | $0.30/M input, $1.20/M output. MiniMax-M3 är en multimodal grundmodell från MiniMax. Den stödjer text-, bild- och videoinmatningar med textutmatning, ett kontextfönster på 1 miljon tokens och är lämpad för långsiktigt agentarbete, kodning och verktygsanvändning. Den bygger på MiniMax Sparse Attention (MSA), som ersätter full uppmärksamhet med KV-blockval för att minska beräkningen per token vid lång kontext – ungefär 1/20 av kostnaden för föregående generation vid 1 miljon tokens, med avsevärt snabbare förfyllning och avkodning samtidigt som kvaliteten bibehålls över de flesta uppgifter. Tränad som en inbyggd multimodal modell på sammanflätade data och finjusterad för flerstegs, produktionslikt samarbete via ett interaktivt användarsimuleringsramverk, är modellen inriktad på uthålliga, flerstegsuppgifter snarare än enkelstegsutförande.
- #32
DeepSeek V4 Pro 0813
DeepSeek | 1,048,576 token context | $1.32/M input, $3.96/M output. DeepSeek V4 Pro 0813 is a large-scale mixture-of-experts model from DeepSeek. This is the GA release of DeepSeek V4 Pro. - #33
Grok 4.7
SpaceXAI | 500 000 tokens kontext | $2.00/M indata, $6.00/M utdata. Grok 4.7 är SpaceXAI:s flaggskeppsmodell för kodning, agentuppgifter och kunskapsarbete, efterföljare till Grok 4.6. Den är särskilt stark vid långvariga…SpaceXAI | 500 000 tokens kontext | $2.00/M indata, $6.00/M utdata. Grok 4.7 är SpaceXAI:s flaggskeppsmodell för kodning, agentuppgifter och kunskapsarbete, efterföljare till Grok 4.6. Den är särskilt stark vid långvariga mjukvaruutvecklingsuppgifter, verifierar sitt eget arbete och hanterar lång kontext, och förbättrar sin föregångare inom professionellt kunskapsarbete såsom att utarbeta dokument och presentationer. Modellen tränades med en längre förstärkningsinlärningsperiod viktad mot problem som tar många timmar att slutföra, och förstår nativt Grok Bot-hanteringen för konversationella uppgifter. Den levereras med en ny säkerhetsstack som kombinerar starkt jailbreak-skydd med låga avvisningsfrekvenser för legitimt cybersäkerhets- och biologiarbete. SpaceXAI:s rapporterade benchmarkresultat använder xhigh resonemangsinsats.
- #34
Gemini 3.1 Flash Lite
Google | 1 048 576 tokens kontext | $0.25/M input, $1.50/M output. Gemini 3.1 Flash Lite är Googles GA hög-effektivitets multimodala modell optimerad för låg latens och hög volym. Den stödjer text-, bild-, video-, ljud- och PDF-indata och…Google | 1 048 576 tokens kontext | $0.25/M input, $1.50/M output. Gemini 3.1 Flash Lite är Googles GA hög-effektivitets multimodala modell optimerad för låg latens och hög volym. Den stödjer text-, bild-, video-, ljud- och PDF-indata och är designad för lätta agentbaserade arbetsflöden, enkel datautvinning och applikationer där responsivitet och API-kostnad är de främsta begränsningarna. Stöder fulla tänkenivåer (minimal, låg, medium, hög) för finjusterade kostnads-/prestandaavvägningar. Prissatt till halva kostnaden av Gemini 3 Flash.
- #35
Gemini 2.5 Flash Lite
Google | 1 048 576 tokens kontext | $0.10/M input, $0.40/M output. Gemini 2.5 Flash-Lite är en lättviktsresonemangsmodell i Gemini 2.5-familjen, optimerad för ultralåg latens och kostnadseffektivitet. Den erbjuder förbättrad…Google | 1 048 576 tokens kontext | $0.10/M input, $0.40/M output. Gemini 2.5 Flash-Lite är en lättviktsresonemangsmodell i Gemini 2.5-familjen, optimerad för ultralåg latens och kostnadseffektivitet. Den erbjuder förbättrad genomströmning, snabbare token-generering och bättre prestanda över vanliga benchmarks jämfört med tidigare Flash-modeller. Som standard är "tänkande" (dvs. flergångsresonemang) inaktiverat för att prioritera hastighet, men utvecklare kan aktivera det via Reasoning API-parametern för att selektivt byta kostnad mot intelligens.
- #36
Gemini 3.7 Flash
Google | 1 048 576 tokens kontext | $0.75/M input, $3.75/M output. Gemini 3.7 Flash är en multimodal modell från Google för snabba agentbaserade arbetsflöden, kodning och komplex flerstegsresonemang. Den är designad för uppgifter som…Google | 1 048 576 tokens kontext | $0.75/M input, $3.75/M output. Gemini 3.7 Flash är en multimodal modell från Google för snabba agentbaserade arbetsflöden, kodning och komplex flerstegsresonemang. Den är designad för uppgifter som kräver responsiv prestanda och pålitlig flerstegsproblemlösning.
- #37
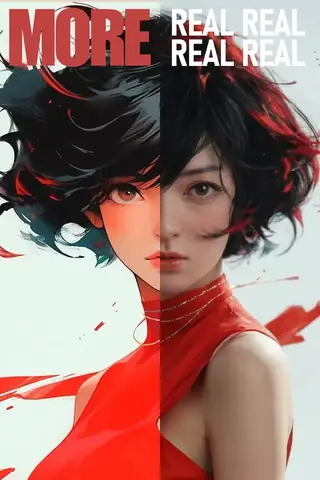
MoreReal
by NO8D - MoreReal - It is a A2R LoRA capable of converting any image into a photorealistic photograph. Weight : 0.6~0.9. Steps : 30/40 - #38
GLM 5.3 Flash
Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture…Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture maintains accurate long-context behavior while reducing compute overhead. Yes, the stealth model Ox Alpha was revealed to be ZAI's new model, GLM-5.3 Flash.
- #39
Laguna S 2.1
Poolside | 1 048 576 tokens kontext | $0.09/M input, $0.18/M output. Laguna S 2.1 är den senaste kodningsagentmodellen från PoolsideOpens in new tab. Laguna S 2.1 är en modell med totalt 118 miljarder parametrar och 8 miljarder aktiva…Poolside | 1 048 576 tokens kontext | $0.09/M input, $0.18/M output. Laguna S 2.1 är den senaste kodningsagentmodellen från PoolsideOpens in new tab. Laguna S 2.1 är en modell med totalt 118 miljarder parametrar och 8 miljarder aktiva parametrar, som når 70,2 % på Terminal-Bench 2.1 och 40,4 % på DeepSWE, vilket gör den till en av de starkaste kodningsmodellerna i sin kategori. Öppna vikter under OpenMDW-1.1-licensen. Laguna S 2.1 är designad för mjukvaruutveckling och agentbaserade kodningsanvändningsfall, och du ansvarar för att bekräfta att den är lämplig för din avsedda användning. Laguna S 2.1 omfattas av OpenMDW-1.1-licensenOpens in new tab och bör användas i enlighet med Poolsides Acceptable Use PolicyOpens in new tab. Vi avråder från att kringgå Laguna S 2.1:s säkerhetsspärrar utan att implementera väsentligt likvärdiga åtgärder som är lämpliga för ditt användningsfall. Rapportera säkerhetsbrister eller säkerhetsproblem till [email protected]. Om du använder Laguna S 2.1 gratis kan vi använda dina in- och utdata för att träna och förbättra våra modeller.
- #40
Gemini 3.8 Flash
Google | 1,048,576 token context | $0.83/M input, $4.12/M output. Gemini 3.8 Flash is Google's most intelligent Flash model with significant gains from 3.7 Flash across software engineering, agentic tasks, and multi-step reasoning. - #41
GLM 5.3 FlashX
Z.ai | 1 048 576 tokens kontext | $0.37/M indata, $1.25/M utdata. GLM-5.3-FlashX är högpresterande varianten av Z.ais GLM-5.3-Flash, en inbyggd multimodal modell som levererar inferenshastigheter på upp till 200 tokens/s. Byggd på samma…Z.ai | 1 048 576 tokens kontext | $0.37/M indata, $1.25/M utdata. GLM-5.3-FlashX är högpresterande varianten av Z.ais GLM-5.3-Flash, en inbyggd multimodal modell som levererar inferenshastigheter på upp till 200 tokens/s. Byggd på samma hybridarkitektur med sparsam och linjär uppmärksamhet (320B totala parametrar, 18B aktiva), är den lämpad för effektiv kodning, visuell förståelse och långsiktiga agentuppgifter med ett 1M-token kontextfönster.
- #42
Qwen Image 2.1 Consistency LoRA
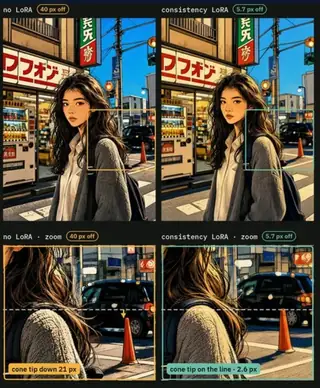
by AusBoss - Qwen Image 2.1 Consistency LoRA - Ask Qwen Image 2.1 for a watercolor, a comic or an anime version of a picture and it comes back a few percent taller, sometimes nudged sideways, different for every seed. A waistband lands 40…by AusBoss - Qwen Image 2.1 Consistency LoRA - Ask Qwen Image 2.1 for a watercolor, a comic or an anime version of a picture and it comes back a few percent taller, sometimes nudged sideways, different for every seed. A waistband lands 40 px lower, a horizon jumps 25 px, a face no longer lines up with the original. On a local edit ("make the cardigan navy") it also repaints things you didn't ask about: hair strands, signs, texture. That breaks anything that stacks the edit on the original: masks, stitching, before/after sliders, video frames. With this LoRA the same prompt makes the same edit, on the original's frame. No trigger word: load it and write your edit instruction as usual
- #43
DeepSeek V4 Flash 0423
DeepSeek | 1 048 576 tokens kontext | $0.09/M input, $0.18/M output. DeepSeek V4 Flash är en effektivitetoptimerad Mixture-of-Experts-modell från DeepSeek med totalt 284 miljarder parametrar och 13 miljarder aktiverade parametrar, som…DeepSeek | 1 048 576 tokens kontext | $0.09/M input, $0.18/M output. DeepSeek V4 Flash är en effektivitetoptimerad Mixture-of-Experts-modell från DeepSeek med totalt 284 miljarder parametrar och 13 miljarder aktiverade parametrar, som stödjer ett kontextfönster på 1 miljon tokens. Den är designad för snabb inferens och hög genomströmning, samtidigt som den bibehåller stark prestanda inom resonemang och kodning. Modellen inkluderar hybrid uppmärksamhet för effektiv långkontextbearbetning. Resonemangsnivåer high och xhigh stöds; xhigh motsvarar max resonemang. Den är väl lämpad för applikationer som kodningsassistenter, chatt-system och agentarbetsflöden där responsivitet och kostnadseffektivitet är viktiga.
- #44
Kimi K3
MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic…MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic workflows, and is particularly strong at navigating large repositories, using tools, debugging, and iterating against images, logs, tests, and runtime feedback. Its architecture uses KDA and Attention Residuals for computational efficiency.
- #45
Gemini 3 Flash Preview
Google | 1 048 576 tokens kontext | $0.50/M input, $3.00/M output. Gemini 3 Flash Preview är en snabb och värdefull tänkarmodell designad för agentbaserade arbetsflöden, flerstegs-chattar och kodningsassistans. Den levererar nästan…Google | 1 048 576 tokens kontext | $0.50/M input, $3.00/M output. Gemini 3 Flash Preview är en snabb och värdefull tänkarmodell designad för agentbaserade arbetsflöden, flerstegs-chattar och kodningsassistans. Den levererar nästan Pro-nivå i resonemang och verktygsanvändning med avsevärt lägre latens än större Gemini-varianter, vilket gör den väl lämpad för interaktiv utveckling, långvariga agentloopar och samarbetskodning. Jämfört med Gemini 2.5 Flash erbjuder den breda kvalitetsförbättringar inom resonemang, multimodal förståelse och tillförlitlighet. Modellen stödjer ett kontextfönster på 1 miljon tokens och multimodala indata inklusive text, bilder, ljud, video och PDF:er, med textutdata. Den inkluderar konfigurerbart resonemang via tänkenivåer (minimal, låg, medium, hög), strukturerad output, verktygsanvändning och automatisk kontextcache. Gemini 3 Flash Preview är optimerad för användare som vill ha starkt resonemang och agentbeteende utan kostnaden eller latensen från fullskaliga toppmodeller.
- #46
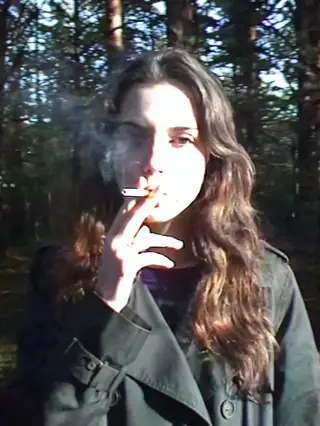
2000s Analog Core v1.0 Qwen2.1
by Danrisi - 2000s Analog Core - 0.7 strength, can be used with other loras - #47
Nemotron 3 Ultra
NVIDIA | 262 144 tokens kontext | $0.60/M input, $2.40/M output. NVIDIA Nemotron 3 Ultra är en öppen frontier-resonemangs- och orkestreringsmodell från NVIDIA med 55 miljarder aktiva parametrar av totalt 550 miljarder (MoE). Byggd på en…NVIDIA | 262 144 tokens kontext | $0.60/M input, $2.40/M output. NVIDIA Nemotron 3 Ultra är en öppen frontier-resonemangs- och orkestreringsmodell från NVIDIA med 55 miljarder aktiva parametrar av totalt 550 miljarder (MoE). Byggd på en hybrid Transformer-Mamba mixture-of-experts-arkitektur, stödjer den textinmatning och -utmatning med ett kontextfönster på upp till 1 miljon tokens. Den är lämpad för långvariga agentbaserade arbetsflöden, inklusive agentorkestrering, kodningsagenter, djup forskning och komplexa företagsuppgifter. Den är särskilt stark vid flerstegsresonemang och planering, med hög genomströmning för inferens designad för agentpipelines med hög volym. Den är en del av NVIDIA Nemotron-familjen av öppna modeller för agentbaserad AI.
- #48
DeepSeek V4 Pro 0423
DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It…DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It is designed for advanced reasoning, coding, and long-horizon agent workflows, with strong performance across knowledge, math, and software engineering benchmarks. Built on the same architecture as DeepSeek V4 Flash, it introduces a hybrid attention system for efficient long-context processing. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is well suited for complex workloads such as full-codebase analysis, multi-step automation, and large-scale information synthesis, where both capability and efficiency are critical
- #49
Gemini 2.5 Flash
Google | 1 048 576 tokens kontext | $0.30/M input, $2.50/M output. Gemini 2.5 Flash är Googles toppmoderna arbetsmodell, specifikt designad för avancerat resonemang, kodning, matematik och vetenskapliga uppgifter. Den inkluderar inbyggda…Google | 1 048 576 tokens kontext | $0.30/M input, $2.50/M output. Gemini 2.5 Flash är Googles toppmoderna arbetsmodell, specifikt designad för avancerat resonemang, kodning, matematik och vetenskapliga uppgifter. Den inkluderar inbyggda "tänkande"-funktioner som gör att den kan ge svar med större noggrannhet och nyanserad kontexthantering. Dessutom är Gemini 2.5 Flash konfigurerbar via parametern "max tokens for reasoning", som beskrivs i dokumentationen (https://openrouter.ai/docs/use-cases/reasoning-tokens#max-tokens-for-reasoning).
- #50
GLM 5.2
Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows,…Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows, project-level software engineering, and complex multi-step automation. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is particularly strong at coding and tool use across long-running tasks, able to maintain engineering context and follow standards consistently through a full development workflow, from requirements to multi-platform deployment, in a single task.
Hetta är vår interna trendpoäng, från kall till 9999°. Den ändras dagligen utifrån användnings- och popularitetssignaler från communityn och tjänsterna kring varje modell. Rankningen täcker basmodeller, LoRA, embeddings och textmodeller över alla familjer i katalogen.
Bläddra efter modellfamilj