- #1
Claude Haiku 5.5
Anthropic | ngữ cảnh 1,000,000 token | $0.10/M đầu vào, $0.50/M đầu ra. Claude Haiku 5.5 là mô hình nhỏ, nhanh của Anthropic dành cho công việc khối lượng lớn, nhạy cảm với chi phí như tóm tắt, tác nhân phụ và sử dụng trình duyệt. Nó kế…Anthropic | ngữ cảnh 1,000,000 token | $0.10/M đầu vào, $0.50/M đầu ra. Claude Haiku 5.5 là mô hình nhỏ, nhanh của Anthropic dành cho công việc khối lượng lớn, nhạy cảm với chi phí như tóm tắt, tác nhân phụ và sử dụng trình duyệt. Nó kế nhiệm Claude Haiku 4.5 với khả năng lập trình, sử dụng máy tính và công việc kiến thức mạnh hơn, chấp nhận đầu vào văn bản và hình ảnh với cửa sổ ngữ cảnh 1M token. Đây là mô hình Haiku đầu tiên có nỗ lực điều chỉnh được. Tư duy thích ứng và mặc định bật, với nỗ lực là đòn bẩy chính để đánh đổi độ sâu, độ trễ và chi phí; có thể tắt ở các mức nỗ lực thấp, trung bình và cao.
- #2
Qwen3.6 35B A3B
Qwen | 262,144 token context | $0.15/M input, $1.00/M output. Qwen3.6-35B-A3B is an open-weight multimodal model from Alibaba Cloud with 35 billion total parameters and 3 billion active parameters per token. It uses a hybrid sparse…Qwen | 262,144 token context | $0.15/M input, $1.00/M output. Qwen3.6-35B-A3B is an open-weight multimodal model from Alibaba Cloud with 35 billion total parameters and 3 billion active parameters per token. It uses a hybrid sparse mixture-of-experts architecture combining Gated DeltaNet linear attention with standard gated attention layers, enabling efficient inference at a fraction of the compute cost. The model supports a 262K token native context window (extensible to 1M via YaRN) and accepts text, image, and video inputs. It includes integrated thinking mode with reasoning traces preserved across multi-turn conversations, function calling, and structured output. Released under the Apache 2.0 license.
- #3
Claude Opus 5.5
Anthropic | ngữ cảnh 1.000.000 token | $4.00/M đầu vào, $20.00/M đầu ra. Claude Opus 5.5 là mô hình chủ lực của Anthropic cho suy luận đòi hỏi cao, lập trình và công việc agentic dài hạn, kế nhiệm Claude Opus 5. Nó đặc biệt mạnh trong các…Anthropic | ngữ cảnh 1.000.000 token | $4.00/M đầu vào, $20.00/M đầu ra. Claude Opus 5.5 là mô hình chủ lực của Anthropic cho suy luận đòi hỏi cao, lập trình và công việc agentic dài hạn, kế nhiệm Claude Opus 5. Nó đặc biệt mạnh trong các thay đổi đa bước trên cơ sở mã lớn, rà soát mã và tìm lỗi, phân tích tài chính và khoa học, đọc biểu đồ, sơ đồ và ảnh chụp màn hình dày đặc, và cẩn trọng hơn người tiền nhiệm trong việc chỉ nêu số liệu và trích dẫn nguồn có thể xác minh. Mô hình hoàn thành các tác vụ tương đương trong ít bước và ít token hơn Opus 5, và báo cáo công việc bằng ngôn ngữ đơn giản hơn, với cập nhật rõ ràng về những gì nó làm, phát hiện và cần từ người dùng. Suy nghĩ luôn thích ứng, nên nỗ lực là đòn bẩy chính để cân bằng độ sâu, độ trễ và chi phí, và các thiết lập nỗ lực thấp vẫn hiệu quả cho các khối lượng công việc nhạy cảm về độ trễ.
- #4
Qwen Image 2.1 Restore LoRA
By AusBoss - A LoRA that softens the harsh upscale Qwen Image 2.1 does by itself: the result is a little softer, still detailed, makes up less, and stays true to your picture. Qwen Image 2.1 can upscale a small or worn picture without this…By AusBoss - A LoRA that softens the harsh upscale Qwen Image 2.1 does by itself: the result is a little softer, still detailed, makes up less, and stays true to your picture. Qwen Image 2.1 can upscale a small or worn picture without this LoRA, but it overdoes it. Skin turns gritty, pores and freckles show up that were not there, faces look older, and the picture shifts a few pixels. With this LoRA the result stays on your picture. Blurry photos need a lower strength. If your picture is out of focus, shaky, or a frame from a video, set the LoRA to 0.5. At 1.0 it stays true to the blur and the result comes back soft. A small or compressed picture that is in focus is fine at 1.0. No trigger word. Start at strength 1.0, enlarge your picture to about 2 megapixels, give it as image 1, and ask: Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors. For scratched or faded prints: Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people. On an old print it takes out scratches, dust and grain and brings back most of the color.
- #5
Solar Mini 4
Upstage | ngữ cảnh 524,288 token | $0.05/M đầu vào, $0.20/M đầu ra. Solar Mini 4 là mô hình ngôn ngữ nhỏ gọn, tiết kiệm chi phí của Upstage, là mô hình hỗn hợp chuyên gia 35B tham số với 3B tham số kích hoạt và cửa sổ ngữ cảnh 524K. Nó…Upstage | ngữ cảnh 524,288 token | $0.05/M đầu vào, $0.20/M đầu ra. Solar Mini 4 là mô hình ngôn ngữ nhỏ gọn, tiết kiệm chi phí của Upstage, là mô hình hỗn hợp chuyên gia 35B tham số với 3B tham số kích hoạt và cửa sổ ngữ cảnh 524K. Nó được xây dựng cho các trường hợp sử dụng tác nhân nơi tốc độ phản hồi và chi phí quan trọng, với tiếng Hàn lưu loát cùng khả năng tiếng Anh và Nhật mạnh, và hỗ trợ các khối lượng công việc ngữ cảnh dài. Khi sử dụng BYOK với thực thi ZDR, khóa API Console phải thuộc tổ chức Upstage được bật ZDR. Liên hệ Upstage để kích hoạt ZDR cho tổ chức của bạn.
- #6
GPT 6.1 Sol
OpenAI | ngữ cảnh 1,050,000 token | $2.00/M đầu vào, $10.00/M đầu ra. GPT-6.1 Sol là bản nâng cấp của GPT-6 Sol từ OpenAI, nằm dưới mô hình hàng đầu GPT-6 Astra trong dòng GPT-6. Nó phù hợp cho lập trình tác nhân, sử dụng máy tính, công…OpenAI | ngữ cảnh 1,050,000 token | $2.00/M đầu vào, $10.00/M đầu ra. GPT-6.1 Sol là bản nâng cấp của GPT-6 Sol từ OpenAI, nằm dưới mô hình hàng đầu GPT-6 Astra trong dòng GPT-6. Nó phù hợp cho lập trình tác nhân, sử dụng máy tính, công việc chuyên nghiệp nhiều tài liệu và tự động hóa quy trình kinh doanh đa bước, đạt kết quả gần bằng Astra trên các nhiệm vụ này với chi phí thấp hơn nhiều. So với GPT-6 Sol, nó ít lỗi thực tế hơn và đáng tin cậy hơn trong việc tôn trọng các hạn chế rõ ràng và ý định người dùng trong các nhiệm vụ tác nhân.
- #7
Mistral Large 4
Mistral | ngữ cảnh 1.048.576 token | $0.68/M đầu vào, $2.09/M đầu ra. Mistral Large 4 là mô hình đa phương thức tiên phong (đầu vào văn bản và hình ảnh) từ Mistral AI, được xây dựng cho suy luận, lập trình và công việc tác nhân. Nó cung…Mistral | ngữ cảnh 1.048.576 token | $0.68/M đầu vào, $2.09/M đầu ra. Mistral Large 4 là mô hình đa phương thức tiên phong (đầu vào văn bản và hình ảnh) từ Mistral AI, được xây dựng cho suy luận, lập trình và công việc tác nhân. Nó cung cấp cửa sổ ngữ cảnh 1M token với tối đa 256K token đầu ra, và hỗ trợ gọi công cụ cùng đầu ra có cấu trúc.
- #8
Claude Sonnet 5.5
Anthropic | ngữ cảnh 1.000.000 token | $2.00/M đầu vào, $10.00/M đầu ra. Claude Sonnet 5.5 là mô hình Sonnet của Anthropic cho công việc hàng ngày có phạm vi rõ ràng, kế nhiệm Claude Sonnet 5 như một bản nâng cấp trực tiếp. Nó đặc biệt…Anthropic | ngữ cảnh 1.000.000 token | $2.00/M đầu vào, $10.00/M đầu ra. Claude Sonnet 5.5 là mô hình Sonnet của Anthropic cho công việc hàng ngày có phạm vi rõ ràng, kế nhiệm Claude Sonnet 5 như một bản nâng cấp trực tiếp. Nó đặc biệt mạnh trong xây dựng tính năng, sửa lỗi và tạo tài liệu, slide, bảng tính hoàn chỉnh, và viết lách, giao tiếp rõ ràng hơn người tiền nhiệm. Suy nghĩ luôn bật, nên nỗ lực là đòn bẩy chính để cân bằng độ sâu, độ trễ và chi phí, và các thiết lập nỗ lực thấp giữ cho nó phản hồi tốt trong các vòng agentic hàng ngày.
- #9
Nemotron 3 Super
NVIDIA | ngữ cảnh 262,144 token | $0.08/M đầu vào, $0.45/M đầu ra. NVIDIA Nemotron 3 Super là mô hình MoE lai mở 120B tham số, chỉ kích hoạt 12B tham số để tối đa hóa hiệu quả tính toán và độ chính xác trong các ứng dụng đa tác nhân phức…NVIDIA | ngữ cảnh 262,144 token | $0.08/M đầu vào, $0.45/M đầu ra. NVIDIA Nemotron 3 Super là mô hình MoE lai mở 120B tham số, chỉ kích hoạt 12B tham số để tối đa hóa hiệu quả tính toán và độ chính xác trong các ứng dụng đa tác nhân phức tạp. Xây dựng trên kiến trúc hỗn hợp Mamba-Transformer Mixture-of-Experts với dự đoán đa token (MTP), nó tạo token nhanh hơn hơn 50% so với các mô hình mở hàng đầu. Mô hình có cửa sổ ngữ cảnh 1M token cho sự nhất quán tác nhân dài hạn, suy luận xuyên tài liệu và lập kế hoạch nhiệm vụ đa bước. MoE tiềm ẩn cho phép gọi 4 chuyên gia với chi phí suy luận của chỉ một, cải thiện trí tuệ và khả năng tổng quát. Huấn luyện RL đa môi trường trên hơn 10 môi trường mang lại độ chính xác hàng đầu trên các chuẩn như AIME 2025, TerminalBench và SWE-Bench Verified. Hoàn toàn mở với trọng số, bộ dữ liệu và công thức theo Giấy phép Mở NVIDIA, Nemotron 3 Super cho phép tùy chỉnh dễ dàng và triển khai an toàn ở mọi nơi — từ máy trạm đến đám mây.
- #10
GLM 5.3
Z.ai | ngữ cảnh 1.048.576 token | $0.08/M đầu vào, $4.80/M đầu ra. GLM-5.3 là mô hình suy luận quy mô lớn từ Z.ai, xây dựng cho kỹ thuật phần mềm phức tạp và các tác vụ agent dài hạn. Nó hỗ trợ đầu vào và đầu ra văn bản với cửa sổ ngữ cảnh…Z.ai | ngữ cảnh 1.048.576 token | $0.08/M đầu vào, $4.80/M đầu ra. GLM-5.3 là mô hình suy luận quy mô lớn từ Z.ai, xây dựng cho kỹ thuật phần mềm phức tạp và các tác vụ agent dài hạn. Nó hỗ trợ đầu vào và đầu ra văn bản với cửa sổ ngữ cảnh 1 triệu token, và cải tiến so với GLM-5.2 về lập trình và cân bằng giữa hiệu suất và hiệu quả token. Suy luận luôn bật và không thể tắt. Hỗ trợ các mức nỗ lực suy luận thấp, cao và tối đa; tối đa là mặc định.
- #11
Nemotron 3.5 Lightning
NVIDIA | ngữ cảnh 262,144 token | $0.07/M đầu vào, $0.20/M đầu ra. NVIDIA Nemotron 3.5 Lightning là mô hình hỗn hợp chuyên gia mở từ NVIDIA, với 3B tham số kích hoạt trong tổng số 30B tham số. Nó phù hợp cho các khối lượng công việc tác…NVIDIA | ngữ cảnh 262,144 token | $0.07/M đầu vào, $0.20/M đầu ra. NVIDIA Nemotron 3.5 Lightning là mô hình hỗn hợp chuyên gia mở từ NVIDIA, với 3B tham số kích hoạt trong tổng số 30B tham số. Nó phù hợp cho các khối lượng công việc tác nhân có thông lượng cao và các nhiệm vụ chuyên biệt được hưởng lợi từ tùy chỉnh theo lĩnh vực.
- #12
Ling 3.1 Flash
inclusionAI | 262,144 token context | $0.07/M input, $0.22/M output. Ling 3.1 Flash is a hybrid reasoning mixture-of-experts model from inclusionAI, with 25B active parameters out of 560B total. - #13
Gemma 4 26B A4B
Google | ngữ cảnh 262,144 token | $0.09/M đầu vào, $0.30/M đầu ra. Gemma 4 26B A4B IT là mô hình Mixture-of-Experts (MoE) được tinh chỉnh theo hướng dẫn từ Google DeepMind. Mặc dù có tổng 25.2B tham số, chỉ 3.8B được kích hoạt mỗi token…Google | ngữ cảnh 262,144 token | $0.09/M đầu vào, $0.30/M đầu ra. Gemma 4 26B A4B IT là mô hình Mixture-of-Experts (MoE) được tinh chỉnh theo hướng dẫn từ Google DeepMind. Mặc dù có tổng 25.2B tham số, chỉ 3.8B được kích hoạt mỗi token trong suy luận — mang lại chất lượng gần 31B với chi phí tính toán chỉ bằng một phần nhỏ. Hỗ trợ đầu vào đa phương thức bao gồm văn bản, hình ảnh và video (tối đa 60 giây ở 1fps). Có cửa sổ ngữ cảnh 256K token, gọi hàm nguyên bản, chế độ tư duy/suy luận có thể cấu hình và hỗ trợ đầu ra có cấu trúc. Phát hành theo giấy phép Apache 2.0.
- #14
MiMo V2.6 Pro
Xiaomi | ngữ cảnh 1,050,000 token | $0.43/M đầu vào, $0.87/M đầu ra. MiMo-V2.6-Pro là mô hình nền tảng hàng đầu do Xiaomi phát triển. Được xây dựng với quy mô hơn 1T tham số, nó được thiết kế để nâng cao giới hạn khả năng cho các khối…Xiaomi | ngữ cảnh 1,050,000 token | $0.43/M đầu vào, $0.87/M đầu ra. MiMo-V2.6-Pro là mô hình nền tảng hàng đầu do Xiaomi phát triển. Được xây dựng với quy mô hơn 1T tham số, nó được thiết kế để nâng cao giới hạn khả năng cho các khối lượng công việc đòi hỏi cao nhất. Mô hình có cửa sổ ngữ cảnh 1M token và khả năng đa phương thức nguyên bản. Tối ưu cho các quy trình làm việc tác nhân, nó mang lại hiệu suất hàng đầu trong các kịch bản lập trình, hình ảnh, tổng quát và nghiên cứu, xuất sắc trong các nhiệm vụ phức tạp, dài hạn với khả năng tổng quát hóa mạnh mẽ trên nhiều loại tác nhân khác nhau.
- #15
Muse Spark 1.3 Contributor
Meta | ngữ cảnh 1.048.576 token | $0.10/M đầu vào, $0.20/M đầu ra. Muse Spark 1.3 Contributor là tầng đóng góp hiệu quả về chi phí của mô hình suy luận đa phương thức của Meta dành cho thử nghiệm, học tập và các quy trình agentic, đa agent…Meta | ngữ cảnh 1.048.576 token | $0.10/M đầu vào, $0.20/M đầu ra. Muse Spark 1.3 Contributor là tầng đóng góp hiệu quả về chi phí của mô hình suy luận đa phương thức của Meta dành cho thử nghiệm, học tập và các quy trình agentic, đa agent và lập trình giai đoạn đầu. Nó được thiết kế để theo dõi thông tin qua các nhiệm vụ kéo dài, xử lý các đầu vào mâu thuẫn và yêu cầu làm rõ hoặc xác nhận khi cần. Các prompt và đầu ra có thể được sử dụng để cải thiện sản phẩm của Meta.
- #16
GPT 6 Luna
OpenAI | ngữ cảnh 1.050.000 token | $0.10/M đầu vào, $0.50/M đầu ra. GPT-6 Luna là mô hình nhanh và hiệu quả về chi phí trong dòng GPT-6 của OpenAI, nằm dưới GPT-6 Sol. Nó phù hợp cho các khối lượng công việc lớn và nhạy cảm về độ trễ như…OpenAI | ngữ cảnh 1.050.000 token | $0.10/M đầu vào, $0.50/M đầu ra. GPT-6 Luna là mô hình nhanh và hiệu quả về chi phí trong dòng GPT-6 của OpenAI, nằm dưới GPT-6 Sol. Nó phù hợp cho các khối lượng công việc lớn và nhạy cảm về độ trễ như chat, phân loại và các tác vụ agentic nhẹ, và với nỗ lực suy luận cao hơn có thể đảm nhận các tác vụ kỹ thuật phần mềm phức tạp và sử dụng máy tính mà trước đây cần mô hình cấp Sol. Nó chia sẻ các cải tiến về độ tin cậy thực tế và phong cách giao tiếp rõ ràng, súc tích của dòng GPT-6.
- #17
MiMo V2.6 Flash
Xiaomi | ngữ cảnh 1.050.000 token | $0.14/M đầu vào, $0.28/M đầu ra. MiMo-V2.6-Flash là một mô hình nền tảng mã nguồn mở do Xiaomi phát triển. Xây dựng trên kiến trúc Mixture-of-Experts với tổng số 309 tỷ tham số và 15 tỷ tham số kích hoạt…Xiaomi | ngữ cảnh 1.050.000 token | $0.14/M đầu vào, $0.28/M đầu ra. MiMo-V2.6-Flash là một mô hình nền tảng mã nguồn mở do Xiaomi phát triển. Xây dựng trên kiến trúc Mixture-of-Experts với tổng số 309 tỷ tham số và 15 tỷ tham số kích hoạt mỗi token, nó sử dụng cơ chế chú ý kết hợp để tăng hiệu quả tính toán. Mô hình có cửa sổ ngữ cảnh 1 triệu token và khả năng đa phương thức gốc. Tối ưu cho các quy trình agentic, nó mang lại hiệu suất mạnh mẽ trong các kịch bản lập trình, hình ảnh, tổng quát và nghiên cứu, xuất sắc trong các nhiệm vụ phức tạp, dài hạn với khả năng tổng quát hóa vững chắc trên nhiều dạng agent khác nhau.
- #18

DeepSeek V4.1 Flash
DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B…DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B parameters on input and 16B on output from a 552B-parameter backbone, an asymmetric split that keeps per-token compute low relative to the model's total size. Image understanding is native to the architecture, with visual and text embeddings trained jointly from the start of pre-training rather than added afterward as in the earlier experimental V4 Flash Vision ExpOpens in new tab. It is suited for coding, terminal, and computer-use agents, along with long-horizon tasks that must run to completion across many steps and long-context analysis. Compressed KV caching cuts cache memory to roughly a quarter of the previous Flash generation, significantly reducing costs on agentic workloads. DeepSeek positions it as the cost-efficient tier of the V4.1 family and reports that it exceeds V4 ProOpens in new tab on performance, speed, and task completion time.
- #19
Qwen3.8 Flash
Qwen | ngữ cảnh 1,000,000 token | $0.15/M đầu vào, $0.47/M đầu ra. Qwen3.8 Flash là mô hình suy luận đa phương thức từ Alibaba. Nó phù hợp cho hỗ trợ lập trình, quy trình làm việc tác nhân, hiểu hình ảnh, phân tích tài liệu và mã nguồn,…Qwen | ngữ cảnh 1,000,000 token | $0.15/M đầu vào, $0.47/M đầu ra. Qwen3.8 Flash là mô hình suy luận đa phương thức từ Alibaba. Nó phù hợp cho hỗ trợ lập trình, quy trình làm việc tác nhân, hiểu hình ảnh, phân tích tài liệu và mã nguồn, tương tác máy tính để bàn, phân tích biểu đồ và phân tích video dài.
- #20
[Qwen Image] Asian Mix Lora
by hinablue - [Qwen Image] Asian Mix Lora - v3.0 - Q21 - rank64 Trained using a custom-built trainer with a dataset of 6,000 images, using Rank 64, and merged with v2.0 via SVD to create this LoRA. It is more stable at a weight below 0.8.…by hinablue - [Qwen Image] Asian Mix Lora - v3.0 - Q21 - rank64 Trained using a custom-built trainer with a dataset of 6,000 images, using Rank 64, and merged with v2.0 via SVD to create this LoRA. It is more stable at a weight below 0.8. Limb/anatomy issues may still occasionally occur, so please use at your own discretion.
- #21
Qwen3.8 27B
Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent…Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent tasks, with flexible thinking that can be enabled or disabled.
- #22
Claude Fable 5.1
Anthropic | ngữ cảnh 1,000,000 token | $10.00/M đầu vào, $50.00/M đầu ra. Claude Fable 5.1 cải tiến toàn diện so với Claude Fable 5, với bước tiến lớn nhất trong lập trình tác nhân, quy trình làm việc tác nhân dài hạn và công việc kiến…Anthropic | ngữ cảnh 1,000,000 token | $10.00/M đầu vào, $50.00/M đầu ra. Claude Fable 5.1 cải tiến toàn diện so với Claude Fable 5, với bước tiến lớn nhất trong lập trình tác nhân, quy trình làm việc tác nhân dài hạn và công việc kiến thức: tái cấu trúc mã dài, tạo mã giao diện và hình ảnh, cũng như các nhiệm vụ tài chính và phân tích. Nó cũng có xu hướng súc tích hơn Fable 5 trong kế hoạch và tóm tắt. Chúng tôi khuyến nghị thử nghiệm nó như một bản nâng cấp trực tiếp ở bất cứ đâu bạn đang dùng Fable 5 hôm nay, và kết hợp với Opus 5 trong các nhiệm vụ nặng về suy luận.
- #23
Hy3
Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production…Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production use. It supports a configurable reasoning effort: a direct no-think mode by default, plus low and high chain-of-thought modes for complex math, coding, and multi-step problems. With a 256K context window, Hy3 targets long-horizon tasks, including improved coreference resolution, multi-turn constraint tracking, and stable tool-calling that generalizes across agent scaffoldings. Tencent positions it as a reliable, cost-effective option across coding, document processing, financial analysis, game development, and frontend design, with a strong emphasis on grounded, anti-hallucination behavior that answers when grounded and flags when evidence is missing rather than fabricating.
- #24
Gemma 4 31B
Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable…Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable thinking/reasoning mode, native function calling, and multilingual support across 140+ languages. Strong on coding, reasoning, and document understanding tasks. Apache 2.0 license.
- #25
gpt oss 120b
OpenAI | ngữ cảnh 131,072 token | $0.15/M đầu vào, $0.60/M đầu ra. gpt-oss-120b là mô hình ngôn ngữ Mixture-of-Experts (MoE) 117B tham số trọng số mở từ OpenAI, được thiết kế cho các trường hợp sử dụng sản xuất đòi hỏi suy luận cao, tác…OpenAI | ngữ cảnh 131,072 token | $0.15/M đầu vào, $0.60/M đầu ra. gpt-oss-120b là mô hình ngôn ngữ Mixture-of-Experts (MoE) 117B tham số trọng số mở từ OpenAI, được thiết kế cho các trường hợp sử dụng sản xuất đòi hỏi suy luận cao, tác nhân và đa mục đích. Nó kích hoạt 5.1B tham số mỗi lần chạy và được tối ưu để chạy trên một GPU H100 với lượng tử hóa MXFP4 nguyên bản. Mô hình hỗ trợ độ sâu suy luận có thể cấu hình, truy cập chuỗi suy nghĩ đầy đủ và sử dụng công cụ nguyên bản, bao gồm gọi hàm, duyệt web và tạo đầu ra có cấu trúc.
- #26
Space Bunny Alpha
stealth | ngữ cảnh 1.000.000 token | miễn phí sử dụng. Space Bunny Alpha là mô hình lớn ẩn danh với suy luận cực nhanh, khả năng lập trình mạnh và hỗ trợ đầu vào đa phương thức gốc. Nó cung cấp mức nỗ lực suy luận điều chỉnh được, và cửa…stealth | ngữ cảnh 1.000.000 token | miễn phí sử dụng. Space Bunny Alpha là mô hình lớn ẩn danh với suy luận cực nhanh, khả năng lập trình mạnh và hỗ trợ đầu vào đa phương thức gốc. Nó cung cấp mức nỗ lực suy luận điều chỉnh được, và cửa sổ ngữ cảnh 1 triệu token. Space...
- #27
GPT 6 Luna Pro
OpenAI | ngữ cảnh 1.050.000 token | $0.10/M đầu vào, $0.50/M đầu ra. GPT-6 Luna Pro là cùng mô hình nền tảng với GPT-6 LunaOpens in new tab, được phục vụ với chế độ reasoning.mode đặt là pro để có phản hồi chất lượng cao hơn trên các tác…OpenAI | ngữ cảnh 1.050.000 token | $0.10/M đầu vào, $0.50/M đầu ra. GPT-6 Luna Pro là cùng mô hình nền tảng với GPT-6 LunaOpens in new tab, được phục vụ với chế độ reasoning.mode đặt là pro để có phản hồi chất lượng cao hơn trên các tác vụ phức tạp. Lưu ý chi phí: chế độ pro tiêu thụ nhiều token suy luận hơn mỗi yêu cầu, nên một yêu cầu điển hình tốn gấp nhiều lần so với cùng yêu cầu trên GPT-6 Luna và mất nhiều thời gian hơn để hoàn thành. Nó dành cho các vấn đề khó, có tính rủi ro cao mà độ chính xác thêm là xứng đáng với chi phí. Đối với công việc lập trình, tác nhân và chat hàng ngày, hãy sử dụng GPT-6 LunaOpens in new tab thay thế. Tìm hiểu thêm trong tài liệu OpenAI: https://developers.openai.com/api/docs/guides/reasoning#reasoning-modeOpens in new tab
- #28
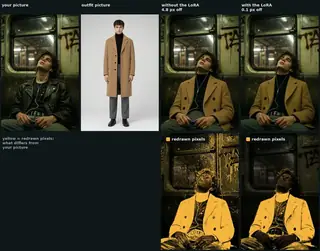
Qwen Image 2.1 Outfit Swap Consistency LoRA
by AusBoss - Qwen Image 2.1 Outfit Swap Consistency LoRA - Qwen Image 2.1 can already dress a person in the outfit from another picture. The result comes back a few pixels off, the face a little softer, the background repainted. With this…by AusBoss - Qwen Image 2.1 Outfit Swap Consistency LoRA - Qwen Image 2.1 can already dress a person in the outfit from another picture. The result comes back a few pixels off, the face a little softer, the background repainted. With this LoRA only the clothes change. No trigger word. Load it at strength 1.0, give the person as image 1 and the outfit as image 2, and ask for the swap
- #29
Hy4 preview
Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows,…Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows, and productivity tasks that require planning, context continuity, and sustained multi-step execution.
- #30
GPT 6 Sol
OpenAI | ngữ cảnh 1,050,000 token | $2.00/M đầu vào, $10.00/M đầu ra. GPT-6 Sol là mô hình cao cấp tiết kiệm chi phí trong dòng GPT-6 của OpenAI, nằm dưới mô hình hàng đầu GPT-6 Astra và trên cấp nhanh GPT-6 Luna. Nó phù hợp cho công việc…OpenAI | ngữ cảnh 1,050,000 token | $2.00/M đầu vào, $10.00/M đầu ra. GPT-6 Sol là mô hình cao cấp tiết kiệm chi phí trong dòng GPT-6 của OpenAI, nằm dưới mô hình hàng đầu GPT-6 Astra và trên cấp nhanh GPT-6 Luna. Nó phù hợp cho công việc chuyên nghiệp đòi hỏi cao, lập trình tác nhân, tự động hóa quy trình kinh doanh và sử dụng máy tính, đặc biệt mạnh trong các nhiệm vụ kỹ thuật phần mềm dài hạn trên mã nguồn thực tế. Nó đạt độ tin cậy thực tế gần bằng Astra với chi phí thấp hơn nhiều và chia sẻ phong cách giao tiếp rõ ràng, súc tích hơn của Astra trong các cuộc trò chuyện kỹ thuật và lập trình.
- #31
MiniMax M3
MiniMax | ngữ cảnh 1.048.576 token | $0.30/M đầu vào, $1.20/M đầu ra. MiniMax-M3 là mô hình nền tảng đa phương thức từ MiniMax. Nó hỗ trợ đầu vào văn bản, hình ảnh và video với đầu ra văn bản, cửa sổ ngữ cảnh 1 triệu token, và phù hợp cho…MiniMax | ngữ cảnh 1.048.576 token | $0.30/M đầu vào, $1.20/M đầu ra. MiniMax-M3 là mô hình nền tảng đa phương thức từ MiniMax. Nó hỗ trợ đầu vào văn bản, hình ảnh và video với đầu ra văn bản, cửa sổ ngữ cảnh 1 triệu token, và phù hợp cho công việc agentic dài hạn, lập trình và sử dụng công cụ. Nó xây dựng trên MiniMax Sparse Attention (MSA), thay thế chú ý đầy đủ bằng lựa chọn khối KV để giảm chi phí tính toán trên mỗi token ở ngữ cảnh dài — khoảng 1/20 chi phí thế hệ trước ở 1 triệu token, với tốc độ tiền xử lý và giải mã nhanh hơn đáng kể trong khi giữ chất lượng trên hầu hết các tác vụ. Được huấn luyện như mô hình đa phương thức gốc trên dữ liệu xen kẽ và tinh chỉnh cho hợp tác đa lượt, giống môi trường sản xuất qua framework mô phỏng người dùng tương tác, mô hình hướng đến các nhiệm vụ kéo dài, đa bước thay vì thực thi một lượt.
- #32
DeepSeek V4 Pro 0813
DeepSeek | 1,048,576 token context | $1.32/M input, $3.96/M output. DeepSeek V4 Pro 0813 is a large-scale mixture-of-experts model from DeepSeek. This is the GA release of DeepSeek V4 Pro. - #33
Grok 4.7
SpaceXAI | ngữ cảnh 500.000 token | $2.00/M đầu vào, $6.00/M đầu ra. Grok 4.7 là mô hình chủ lực của SpaceXAI cho lập trình, tác vụ tác nhân và công việc kiến thức, kế nhiệm Grok 4.6. Nó đặc biệt mạnh trong các tác vụ kỹ thuật phần mềm…SpaceXAI | ngữ cảnh 500.000 token | $2.00/M đầu vào, $6.00/M đầu ra. Grok 4.7 là mô hình chủ lực của SpaceXAI cho lập trình, tác vụ tác nhân và công việc kiến thức, kế nhiệm Grok 4.6. Nó đặc biệt mạnh trong các tác vụ kỹ thuật phần mềm chạy dài, tự xác minh công việc, quản lý ngữ cảnh dài, và cải thiện so với phiên bản trước trong công việc kiến thức chuyên nghiệp như soạn thảo tài liệu và trình bày. Mô hình được huấn luyện với quá trình học tăng cường dài hơn, tập trung vào các vấn đề mất nhiều giờ để hoàn thành, và hiểu bản địa Grok Bot cho các tác vụ hội thoại. Nó đi kèm với hệ thống bảo vệ mới kết hợp khả năng chống jailbreak mạnh với tỷ lệ từ chối thấp cho công việc an ninh mạng và sinh học hợp pháp. Kết quả benchmark của SpaceXAI sử dụng mức độ suy luận xhigh.
- #34
Gemini 3.1 Flash Lite
Google | ngữ cảnh 1,048,576 token | $0.25/M đầu vào, $1.50/M đầu ra. Gemini 3.1 Flash Lite là mô hình đa phương thức hiệu quả cao GA của Google, tối ưu cho các khối lượng công việc độ trễ thấp, khối lượng lớn. Nó hỗ trợ đầu vào văn bản,…Google | ngữ cảnh 1,048,576 token | $0.25/M đầu vào, $1.50/M đầu ra. Gemini 3.1 Flash Lite là mô hình đa phương thức hiệu quả cao GA của Google, tối ưu cho các khối lượng công việc độ trễ thấp, khối lượng lớn. Nó hỗ trợ đầu vào văn bản, hình ảnh, video, âm thanh và PDF, được thiết kế cho các quy trình làm việc tác nhân nhẹ, trích xuất dữ liệu đơn giản và các ứng dụng ưu tiên phản hồi nhanh và chi phí API. Hỗ trợ đầy đủ các mức tư duy (tối thiểu, thấp, trung bình, cao) để đánh đổi chi phí/hiệu suất tinh vi. Giá bằng một nửa Gemini 3 Flash.
- #35
Gemini 2.5 Flash Lite
Google | ngữ cảnh 1,048,576 token | $0.10/M đầu vào, $0.40/M đầu ra. Gemini 2.5 Flash-Lite là mô hình suy luận nhẹ trong dòng Gemini 2.5, tối ưu cho độ trễ cực thấp và hiệu quả chi phí. Nó cung cấp thông lượng cải thiện, tạo token nhanh…Google | ngữ cảnh 1,048,576 token | $0.10/M đầu vào, $0.40/M đầu ra. Gemini 2.5 Flash-Lite là mô hình suy luận nhẹ trong dòng Gemini 2.5, tối ưu cho độ trễ cực thấp và hiệu quả chi phí. Nó cung cấp thông lượng cải thiện, tạo token nhanh hơn và hiệu suất tốt hơn trên các chuẩn phổ biến so với các mô hình Flash trước đó. Theo mặc định, "tư duy" (tức suy luận đa lượt) bị tắt để ưu tiên tốc độ, nhưng nhà phát triển có thể bật qua tham số Reasoning API để đánh đổi chi phí lấy trí tuệ một cách chọn lọc.
- #36
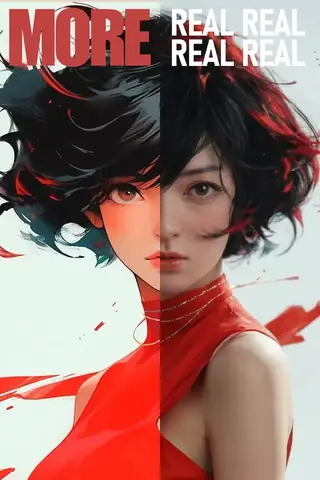
MoreReal
by NO8D - MoreReal - It is a A2R LoRA capable of converting any image into a photorealistic photograph. Weight : 0.6~0.9. Steps : 30/40 - #37
Gemini 3.7 Flash
Google | ngữ cảnh 1,048,576 token | $0.75/M đầu vào, $3.75/M đầu ra. Gemini 3.7 Flash là mô hình đa phương thức từ Google dành cho các quy trình làm việc tác nhân nhanh, lập trình và suy luận đa bước phức tạp. Nó được thiết kế cho các…Google | ngữ cảnh 1,048,576 token | $0.75/M đầu vào, $3.75/M đầu ra. Gemini 3.7 Flash là mô hình đa phương thức từ Google dành cho các quy trình làm việc tác nhân nhanh, lập trình và suy luận đa bước phức tạp. Nó được thiết kế cho các nhiệm vụ đòi hỏi hiệu suất phản hồi và giải quyết vấn đề đa bước đáng tin cậy.
- #38
GLM 5.3 Flash
Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture…Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture maintains accurate long-context behavior while reducing compute overhead. Yes, the stealth model Ox Alpha was revealed to be ZAI's new model, GLM-5.3 Flash.
- #39
Laguna S 2.1
Poolside | ngữ cảnh 1.048.576 token | $0.09/M đầu vào, $0.18/M đầu ra. Laguna S 2.1 là mô hình agent lập trình mới nhất từ PoolsideOpens in new tab. Laguna S 2.1 là mô hình 118 tỷ tham số tổng với 8 tỷ tham số kích hoạt, đạt điểm 70.2%…Poolside | ngữ cảnh 1.048.576 token | $0.09/M đầu vào, $0.18/M đầu ra. Laguna S 2.1 là mô hình agent lập trình mới nhất từ PoolsideOpens in new tab. Laguna S 2.1 là mô hình 118 tỷ tham số tổng với 8 tỷ tham số kích hoạt, đạt điểm 70.2% trên Terminal-Bench 2.1 và 40.4% trên DeepSWE, trở thành một trong những mô hình lập trình mạnh nhất trong phân khúc của nó. Trọng số mở theo giấy phép OpenMDW-1.1. Laguna S 2.1 được thiết kế cho các trường hợp sử dụng kỹ thuật phần mềm và lập trình agentic, và bạn chịu trách nhiệm xác nhận nó phù hợp với ứng dụng dự định của bạn. Laguna S 2.1 tuân theo Giấy phép OpenMDW-1.1Opens in new tab và nên được sử dụng phù hợp với Chính sách Sử dụng Chấp nhận được của PoolsideOpens in new tab. Chúng tôi khuyên không nên vượt qua các biện pháp an toàn của Laguna S 2.1 mà không thực hiện các biện pháp giảm thiểu tương đương phù hợp với trường hợp sử dụng của bạn. Vui lòng báo cáo các lỗ hổng bảo mật hoặc mối quan ngại về an toàn tới [email protected]. Nếu bạn sử dụng Laguna S 2.1 miễn phí, chúng tôi có thể sử dụng đầu vào và đầu ra của bạn để huấn luyện và cải thiện mô hình.
- #40
Gemini 3.8 Flash
Google | 1,048,576 token context | $0.83/M input, $4.12/M output. Gemini 3.8 Flash is Google's most intelligent Flash model with significant gains from 3.7 Flash across software engineering, agentic tasks, and multi-step reasoning. - #41
GLM 5.3 FlashX
Z.ai | ngữ cảnh 1.048.576 token | $0.37/M đầu vào, $1.25/M đầu ra. GLM-5.3-FlashX là biến thể tốc độ cao của GLM-5.3-Flash từ Z.ai, mô hình đa phương thức bản địa cung cấp tốc độ suy luận lên đến 200 token/s. Xây dựng trên kiến trúc chú ý…Z.ai | ngữ cảnh 1.048.576 token | $0.37/M đầu vào, $1.25/M đầu ra. GLM-5.3-FlashX là biến thể tốc độ cao của GLM-5.3-Flash từ Z.ai, mô hình đa phương thức bản địa cung cấp tốc độ suy luận lên đến 200 token/s. Xây dựng trên kiến trúc chú ý lai thưa thớt và tuyến tính (320 tỷ tham số tổng, 18 tỷ tham số hoạt động), nó phù hợp cho lập trình hiệu quả, hiểu biết thị giác và tác vụ tác nhân dài hạn với cửa sổ ngữ cảnh 1M token.
- #42
Qwen Image 2.1 Consistency LoRA
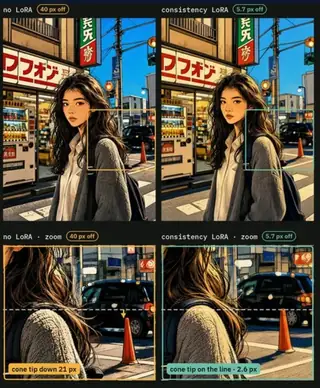
by AusBoss - Qwen Image 2.1 Consistency LoRA - Ask Qwen Image 2.1 for a watercolor, a comic or an anime version of a picture and it comes back a few percent taller, sometimes nudged sideways, different for every seed. A waistband lands 40…by AusBoss - Qwen Image 2.1 Consistency LoRA - Ask Qwen Image 2.1 for a watercolor, a comic or an anime version of a picture and it comes back a few percent taller, sometimes nudged sideways, different for every seed. A waistband lands 40 px lower, a horizon jumps 25 px, a face no longer lines up with the original. On a local edit ("make the cardigan navy") it also repaints things you didn't ask about: hair strands, signs, texture. That breaks anything that stacks the edit on the original: masks, stitching, before/after sliders, video frames. With this LoRA the same prompt makes the same edit, on the original's frame. No trigger word: load it and write your edit instruction as usual
- #43
DeepSeek V4 Flash 0423
DeepSeek | ngữ cảnh 1.048.576 token | $0.09/M đầu vào, $0.18/M đầu ra. DeepSeek V4 Flash là một mô hình Mixture-of-Experts tối ưu hiệu quả từ DeepSeek với tổng số 284 tỷ tham số và 13 tỷ tham số kích hoạt, hỗ trợ cửa sổ ngữ cảnh 1 triệu…DeepSeek | ngữ cảnh 1.048.576 token | $0.09/M đầu vào, $0.18/M đầu ra. DeepSeek V4 Flash là một mô hình Mixture-of-Experts tối ưu hiệu quả từ DeepSeek với tổng số 284 tỷ tham số và 13 tỷ tham số kích hoạt, hỗ trợ cửa sổ ngữ cảnh 1 triệu token. Nó được thiết kế cho suy luận nhanh và các khối lượng công việc thông lượng cao, đồng thời duy trì hiệu suất suy luận và lập trình mạnh mẽ. Mô hình bao gồm chú ý kết hợp để xử lý ngữ cảnh dài hiệu quả. Hỗ trợ các mức nỗ lực suy luận cao và xhigh; xhigh tương ứng với suy luận tối đa. Nó phù hợp cho các ứng dụng như trợ lý lập trình, hệ thống chat và quy trình agent nơi độ phản hồi và hiệu quả chi phí quan trọng.
- #44
Kimi K3
MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic…MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic workflows, and is particularly strong at navigating large repositories, using tools, debugging, and iterating against images, logs, tests, and runtime feedback. Its architecture uses KDA and Attention Residuals for computational efficiency.
- #45
Gemini 3 Flash Preview
Google | ngữ cảnh 1,048,576 token | $0.50/M đầu vào, $3.00/M đầu ra. Gemini 3 Flash Preview là mô hình tư duy tốc độ cao, giá trị cao được thiết kế cho các quy trình làm việc tác nhân, trò chuyện đa lượt và hỗ trợ lập trình. Nó mang lại…Google | ngữ cảnh 1,048,576 token | $0.50/M đầu vào, $3.00/M đầu ra. Gemini 3 Flash Preview là mô hình tư duy tốc độ cao, giá trị cao được thiết kế cho các quy trình làm việc tác nhân, trò chuyện đa lượt và hỗ trợ lập trình. Nó mang lại hiệu suất suy luận và sử dụng công cụ gần cấp Pro với độ trễ thấp hơn đáng kể so với các biến thể Gemini lớn hơn, rất phù hợp cho phát triển tương tác, vòng lặp tác nhân dài và các nhiệm vụ lập trình hợp tác. So với Gemini 2.5 Flash, nó cung cấp cải tiến chất lượng rộng rãi về suy luận, hiểu đa phương thức và độ tin cậy. Mô hình hỗ trợ cửa sổ ngữ cảnh 1M token và đầu vào đa phương thức bao gồm văn bản, hình ảnh, âm thanh, video và PDF, với đầu ra văn bản. Nó bao gồm suy luận có thể cấu hình qua các mức độ tư duy (tối thiểu, thấp, trung bình, cao), đầu ra có cấu trúc, sử dụng công cụ và lưu bộ nhớ ngữ cảnh tự động. Gemini 3 Flash Preview được tối ưu cho người dùng muốn có khả năng suy luận mạnh mẽ và hành vi tác nhân mà không phải chịu chi phí hoặc độ trễ của các mô hình biên quy mô lớn.
- #46
2000s Analog Core v1.0 Qwen2.1
by Danrisi - 2000s Analog Core - 0.7 strength, can be used with other loras - #47
Nemotron 3 Ultra
NVIDIA | ngữ cảnh 262.144 token | $0.60/M đầu vào, $2.40/M đầu ra. NVIDIA Nemotron 3 Ultra là một mô hình tiên phong về suy luận và điều phối từ NVIDIA, với 55 tỷ tham số kích hoạt trên tổng số 550 tỷ tham số (MoE). Xây dựng trên kiến trúc…NVIDIA | ngữ cảnh 262.144 token | $0.60/M đầu vào, $2.40/M đầu ra. NVIDIA Nemotron 3 Ultra là một mô hình tiên phong về suy luận và điều phối từ NVIDIA, với 55 tỷ tham số kích hoạt trên tổng số 550 tỷ tham số (MoE). Xây dựng trên kiến trúc hỗn hợp Transformer-Mamba mixture-of-experts, nó hỗ trợ đầu vào và đầu ra văn bản với cửa sổ ngữ cảnh lên đến 1 triệu token. Mô hình phù hợp cho các quy trình agentic chạy dài, bao gồm điều phối agent, agent lập trình, nghiên cứu sâu và các nhiệm vụ doanh nghiệp phức tạp. Nó đặc biệt mạnh về suy luận và lập kế hoạch nhiều bước, với khả năng suy luận thông lượng cao thiết kế cho các pipeline agent khối lượng lớn. Đây là một phần của dòng mô hình mở NVIDIA Nemotron dành cho AI agentic.
- #48
DeepSeek V4 Pro 0423
DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It…DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It is designed for advanced reasoning, coding, and long-horizon agent workflows, with strong performance across knowledge, math, and software engineering benchmarks. Built on the same architecture as DeepSeek V4 Flash, it introduces a hybrid attention system for efficient long-context processing. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is well suited for complex workloads such as full-codebase analysis, multi-step automation, and large-scale information synthesis, where both capability and efficiency are critical
- #49
Gemini 2.5 Flash
Google | ngữ cảnh 1,048,576 token | $0.30/M đầu vào, $2.50/M đầu ra. Gemini 2.5 Flash là mô hình làm việc tiên tiến nhất của Google, được thiết kế đặc biệt cho suy luận nâng cao, lập trình, toán học và các nhiệm vụ khoa học. Nó bao gồm khả…Google | ngữ cảnh 1,048,576 token | $0.30/M đầu vào, $2.50/M đầu ra. Gemini 2.5 Flash là mô hình làm việc tiên tiến nhất của Google, được thiết kế đặc biệt cho suy luận nâng cao, lập trình, toán học và các nhiệm vụ khoa học. Nó bao gồm khả năng "tư duy" tích hợp, cho phép cung cấp phản hồi với độ chính xác cao hơn và xử lý ngữ cảnh tinh tế hơn. Ngoài ra, Gemini 2.5 Flash có thể cấu hình qua tham số "max tokens for reasoning" như mô tả trong tài liệu (https://openrouter.ai/docs/use-cases/reasoning-tokens#max-tokens-for-reasoningOpens in new tab).
- #50
GLM 5.2
Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows,…Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows, project-level software engineering, and complex multi-step automation. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is particularly strong at coding and tool use across long-running tasks, able to maintain engineering context and follow standards consistently through a full development workflow, from requirements to multi-platform deployment, in a single task.
Độ nóng là điểm xu hướng nội bộ của chúng tôi, từ lạnh đến 9999°. Nó thay đổi mỗi ngày theo tín hiệu sử dụng và mức độ phổ biến từ các cộng đồng và dịch vụ xung quanh từng mô hình. Bảng xếp hạng bao gồm mô hình gốc, LoRA, embedding và mô hình văn bản của mọi họ trong danh mục.
Duyệt theo họ mô hình