Upscale qwen21

Melhor para iniciantes. Fluxos de trabalho poderosos, curva de aprendizado baixa.

Crie vídeos, imagens, personas de chat personalizadas e muito mais.

Navegue por modelos, renderize e refine de qualquer navegador ou celular.

Adicione o Vector ao seu servidor ou entre no Discord do Vector. Crie qualquer coisa!

Editor para imagens e vídeos: renderize, edite, aumente a resolução e mais em uma única página.

Instale programas locais se seu computador tiver hardware compatível.

Gere o mesmo prompt em até 50 modelos checkpoint/base ao mesmo tempo.

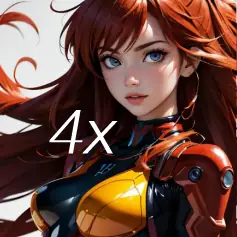
A simple port of a Qwen 2.1 based image upscaling workflow, which upscales the image to 2x by default but can be adjusted with the scale parameter. You can also adjust the guidance factor away from 1.0 to a slightly higher value such as 2.0 to get more (and newer inferred) detail, though keep in mind that guidance != 1 will increase inference time (roughly doubling it). Keep in mind that since this is effectively running the image through a diffusion model for regeneration, some original details might be changed regardless of the CFG/Guidance setting. Diffusion/generative upscaling is more of…A simple port of a Qwen 2.1 based image upscaling workflow, which upscales the image to 2x by default but can be adjusted with the scale parameter. You can also adjust the guidance factor away from 1.0 to a slightly higher value such as 2.0 to get more (and newer inferred) detail, though keep in mind that guidance != 1 will increase inference time (roughly doubling it). Keep in mind that since this is effectively running the image through a diffusion model for regeneration, some original details might be changed regardless of the CFG/Guidance setting. Diffusion/generative upscaling is more of a "Recreate the image with higher quality and at a higher resolution using the reference image as extreme inspiration", if extreme precision is necessary than a different non-generative upscaling workflow might be a better choice. It uses a hardcoded upscale prompt, but can be adjusted with slot1 if deemed to be really necessary. The included prompt attempts to get Qwen to remove any watermarks from the image, which might be one case where an override is warranted (if the watermark being removed is important to your image).

Glossário: os termos usados aqui
- Pontuação heat
- Um número que mostra o quanto um modelo está sendo usado e desejado agora, de 0° a 9.999°. Toda lista neste site que diz mais quente é ordenada por ele e só por ele.
- Limite mínimo
- Os 7.000° que todo modelo com dados reais começa. A escala vai de 0° a 9.999°; a parte abaixo do limite é para substitutos (modelos sem dados), para que um modelo com dados sempre fique acima de um sem. O limite é igual para todos e não decide nada; os graus acima dele são a medida.
- Equivalentes a downloads
- Tudo que a pontuação trata como download, somado: downloads em si, cada torrent seeder como 1.000, cada imagem AI Horde e cada execução em site de geração como um.
- Escala logarítmica
- Contando de dez em dez, não de um em um: ir de 1.000 para 10.000 downloads adiciona os mesmos graus que ir de 10.000 para 100.000. Isso evita que gigantes abafem tudo.
- Likes
- Joinhas e likes de todas as fontes, valendo metade de um download na escala logarítmica.
- Taxa de adoção
- Quantos downloads por dia um modelo recebe agora, pela diferença entre duas leituras de uma fonte. Um quarto do peso do termo download.
- Medido e estimado
- Medido significa que existem duas leituras de uma fonte e a diferença é real. Estimado significa que só se sabe o total de hoje e o passado é distribuído ao longo da vida do modelo; o site indica qual está mostrando.
- Seeder
- Alguém que mantém uma cópia dos pesos online para outros baixarem via torrent, ou um espelho hospedado fazendo o mesmo. Cada um conta como 1.000 downloads.
- AI Horde
- Uma rede voluntária que gera imagens de graça em computadores doados. O número de imagens feitas com um modelo é público, e cada uma conta como um download.
- Sites de geração
- Sites que hospedam suas próprias cópias de um modelo e deixam as pessoas gerarem com ele, como PixAI, SeaArt e Yodayo. Os downloads deles contam como os do Civitai e cada geração conta como um download.
- Tokens OpenRouter
- Um modelo de texto servido via API, como Claude ou GPT, não tem pesos para baixar, então seu uso é medido em tokens: os pedaços de texto que ele leu e escreveu via OpenRouter, um gateway usado por muitos apps, nos últimos 30 dias. Cada 10,000,000 tokens contam como um download. Fonte: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Modelo completo (checkpoint)
- Os pesos em si, o arquivo que gera sozinho. Ganha um bônus porque complementos dependem dele.
- LoRA e embedding
- Arquivos pequenos que direcionam os pesos de outra pessoa para um estilo, personagem ou conceito. Não podem rodar sozinhos.
- Família e pesos
- A base em que um modelo é construído, como SD 1.5, SDXL, Flux ou Wan. Todo modelo herda a data de lançamento dos pesos da sua família.
- Idade
- Pontos retirados conforme há quanto tempo os pesos da família foram lançados: 150° por ano, até 750°. Mantém os downloads antigos que tiveram anos para acumular, evitando que saiam do topo da lista.
- Impulso da família
- Um pequeno empurrão limitado para LoRAs de uma família que este site está promovendo agora, sempre listado na divisão.
- Pontuação provisória
- Um número estável abaixo do mínimo dado a um modelo que ainda não tem dados de fonte, para a lista ficar completa. Nunca fica acima de um modelo com dados.
- Novo! (período de carência)
- Um modelo com menos de 7 dias mostra Novo! em vez de uma pontuação e não ocupa lugar no ranking. Sua pontuação é calculada desde o primeiro dia, mas um modelo com um dia cresce mais rápido que qualquer outro, então sem a espera o #1 da semana seria sempre o que saiu ontem, não o que se manteve por uma semana.
- Tendência
- Como o crescimento de um modelo num período se compara com o crescimento típico dos modelos no mesmo período. Crescimento mais rápido que o típico indica alta, mais lento indica queda.
- Modelo típico
- O meio do catálogo: metade dos modelos com número cresceu mais rápido no período, metade mais devagar.