
Studio Ghibli HunyuanVideo
8096°
<ghibli3-huny>
แอปที่รองรับแท็ก ModelTrends ช่วยให้คุณรัน/ติดตั้งโมเดลได้โดยการคัดลอกโค้ดนี้ไปใส่ในคำสั่งของคุณโดยไม่ต้องตั้งค่า มองหาไอคอนของเราในแอปที่รองรับ เช่น Prism (ด้านล่าง)
รันโมเดลนี้
ข้อเสนอ / โฆษณา

Easy Creator (Prism) เว็บ
ไม่จำกัด · ค่าธรรมเนียมคงที่
เหมาะสำหรับผู้เริ่มต้นที่สุด เวิร์กโฟลว์ทรงพลัง เรียนรู้ง่าย

PirateDiffusion Telegram
ไม่จำกัด · ค่าธรรมเนียมคงที่
สร้างวิดีโอ รูปภาพ บุคลิกแชทที่กำหนดเอง และอื่นๆ

Pro studio (SpyGlass) เว็บ
ไม่จำกัด · ค่าธรรมเนียมคงที่
เรียกดูโมเดล เรนเดอร์ และปรับแต่งได้จากทุกเบราว์เซอร์หรือโทรศัพท์

Discord bot (Vector)
ไม่จำกัด · ค่าธรรมเนียมคงที่
เพิ่ม Vector ในเซิร์ฟเวอร์ของคุณหรือเข้าร่วม Vector Discord สร้างอะไรก็ได้!

Unified Editor เว็บ
ไม่จำกัด · ค่าธรรมเนียมคงที่
ตัวแก้ไขภาพและวิดีโอ: เรนเดอร์ แก้ไข อัปสเกล และอื่นๆ ในหน้าเดียว

Civitai เว็บ
จ่ายตามการใช้
สร้างบนเว็บไซต์ของ Civitai; ทุกภาพใช้ Buzz เครดิต

แอปในเครื่อง
ต้องตั้งค่า
ติดตั้งโปรแกรมในเครื่องถ้าคอมพิวเตอร์ของคุณแรงพอ

ModelDuel เว็บ
จ่ายตามการใช้
สร้างพรอมต์เดียวกันบนโมเดลเช็คพอยต์/เบสได้สูงสุด 50 โมเดลพร้อมกัน

บันทึกจากผู้สร้าง
Disclaimer
Although base HunyuanVideo knows generic anime style well without need for LoRAs and has some knowledge about Studio Ghibli's art style, the latter is not consistent, very prompt-dependant and can sometimes fall back to realistic style. And the shading, palette and linework can be quite different. So by making this LoRA I wanted to try to reinforce the Ghibli art style for HunyuanVideo.
This is the third version of the LoRA. The first two versions were not successful, I did not publish them.
upd. 01/08/2025 Unfortunately, I got no spare time to work on older models, so retraining this one isn't planned any more.
upd. 14/03/2025 After testing Wan2.1-14B-T2V for a week, I must acknowledge that it is superior to HV. Therefore, I will shift to Wan training and do not plan to release any more HV models. However, I'll make my best to release an update to Ghibli LoRA (once I'm done with some of my other planned Flux/Wan models), because I still feel obligated to finalize it with proper training using videos, not just images.
upd. 02/03/2025 I got carried away with Lumina-2 and Wan-2.1 and got back to Flux training again, so v0.7 will be slightly postponed. But I will definitely release it (probably along with one more anime LoRA).
upd. 08/02/2025 v0.6 was a disappointment. I made several risky decisions that did not justify themselves and weren’t worth the 84 hours of training on an RTX 3090. Stay tuned for v0.7! 🙂
upd. 05/01/2025 Done training v.0.4 with musubi-tuner, but it was worse than v0.3, so I won't publish it (and will use diffusion-pipe for v0.5).
upd. 21/01/2025 I made too much mistakes while training v0.5, so I decided to drop it and start from scratch with upgraded dataset and training parameters (and try musubi one more time). 32 hours wasted, but it's for good :)
Usage
For inference I use the with just an additional LoRA loader node. should work too (at least it worked a week ago, but after that I switched to native workflow). A parameters are default except:
guidance: 7.0
steps: 30
That does not mean they are optimal, it's just I mostly generated clips using them, but maybe some other combinations might deliver better results.
The prompt template I am currently using is like this:
A scene from a Studio Ghibli animated film, featuring [CHARACTER DESCRIPTION], as they [ACTION] at [ENVIRONMENT], under [LIGHTING], with [ADDITIONAL SETTING DETAILS], while the camera [CAMERA WORK], emphasizing [MOOD AND AMBIANCE].
I usually input a set of tags to LLM, like "blonde woman, barefeet, ocean seashore, fine weather, etc." and ask to output a cohesive prompt in natural language according the this template.
Training
Please have in mind that my training routine is not optimal, I am just testing and experimenting, so it's possible it worked not because it is good, but despite being bad.
Current version of LoRA is trained on 185 fragments (512x512) of screencaps from various Ghibli movies. They were captioned with . Captioning prompt was:
Create a very detailed description of this image as if it was a frame from Studio Ghibli movie. The description should necessarily 1) describe the main content of the scene, detail the scene's content, which notably includes scene transitions and camera movements that are integrated with the visual content, such as camera follows some subject 2) describe the environment in which the subject is situated 3) identify the type of video shot that highlights or emphasizes specific visual content, such as aerial shot, close-up shot, medium shot, or long shot 4) include description of the atmosphere of the video, such as cozy, tense, or mysterious. Do not use numbered lists or line breaks. IMPORTANT: output description MUST ALWAYS start with unaltered phrase 'A scene from Studio Ghibli animated film, featuring...', and then insert your detailed description.
For training I used Other possible choices are (it currently does require > 24GB VRAM to train HV), (I yet failed to get good results with it, although it's not the software's fault) and (but I never tried it).
Training was done on Windows 11 Home (WSL2) with 64 GB RAM, on a single RTX 3090. Training parameters were default (, ), except:
rank = 16
lr = 6e-5
I saved on each epoch and got 20 epochs, each took 462 steps, so 9240 in total. The speed on RTX 3090 was approximately 7 s/it (so, each epoch took slightly less than 1 hour to train). After testing epochs from 13 to 20, I chose epoch 19 as it was most consistent and gave fewer errors.
The result is still far from perfect, but I hope to deliver upgraded versions. Next version will probably be trained on clips instead of images, but I need time to prepare the dataset.
Also it is quite possible that upcoming I2V model will render style LoRAs useless.
P.S.
I'm still amazed we got such an outstanding local video model. I feel like now it's really a Stable Diffusion moment for local video generation. No doubt we will get more models in the future that will surpass it, but HunyuanVideo will always be the first of its kind, at least for me ❤️
คำทริกเกอร์
A scene from a Studio Ghibli animated film
SHA256
C4CC487F14709AE9D8889A2BE0B89CDD1F9571E058552702CD75A1C0E3FEC3FC
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #1 Hottest Hunyuan LoRA
Not this creator?
Get your own badge
แนวโน้มความนิยมของ Studio Ghibli HunyuanVideo
คะแนนความร้อน, 12 เดือนล่าสุด
คะแนนความนิยม
8,096°
สัปดาห์นี้
▲
0.5%
8,095° ตอนนั้น, 8,096° ตอนนี้
เดือนนี้
▲
2.1%
8,099° ตอนนั้น, 8,096° ตอนนี้
ปีที่ผ่านมา
▲
55.9%
8,088° ตอนนั้น, 8,096° ตอนนี้
7,000°
ค่าพื้นฐาน
มาตรวัดมีช่วงตั้งแต่ 0° ถึง 9,999° ทุกอย่างต่ำกว่า 7,000° จะเก็บไว้สำหรับโมเดลที่ยังไม่มีแหล่งข้อมูลรายงาน ซึ่งใช้ตัวเลขแทนที่ตรงนั้นเพื่อให้รายการครบถ้วน 7,000° คือจุดเริ่มต้นของข้อมูลที่วัดได้: โมเดลที่มีข้อมูลจริงแต่แทบไม่มีการดาวน์โหลดจะอยู่ที่ค่าพื้นฐานนี้ และการวัดจะเติมองศาเพิ่มขึ้นด้านบน ค่าพื้นฐานไม่ได้บอกอะไรเกี่ยวกับโมเดลเลย; มีแค่องศาที่เพิ่มขึ้นด้านบนเท่านั้นที่บอกความแตกต่างระหว่างโมเดลแต่ละตัว
+1,026°
ดาวน์โหลดจาก Civitai
ดาวน์โหลด 2,624 ครั้งของเวอร์ชันนี้บน Civitai การดาวน์โหลดเป็นส่วนประกอบที่สำคัญที่สุดและนับบนมาตราส่วนลอการิทึม: การดาวน์โหลดสิบเท่าจะเพิ่ม 300° เท่ากัน ดังนั้นโมเดลที่ดาวน์โหลดล้านครั้งจะไม่ร้อนกว่าที่ดาวน์โหลดพันครั้งถึงพันเท่า แหล่งดาวน์โหลดหกแหล่งแบ่งส่วนนี้ตามสัดส่วนการดาวน์โหลดของแต่ละแหล่ง
+353°
ยอดถูกใจ
224 ถูกใจและโหวตบวกจากแหล่งต่างๆ การถูกใจมีน้ำหนักเท่าครึ่งหนึ่งของการดาวน์โหลด ตามมาตราส่วนลอการิทึมเดียวกัน
−283°
อายุ
−283° เพราะน้ำหนัก Huny ออกมาในปี 2024 โมเดลทุกตัวสืบทอดอายุของน้ำหนักที่สร้างขึ้น: 150° ต่อปี สูงสุด 750° และจะเพิ่มขึ้นเรื่อยๆ จนถึงจุดนั้น ถ้าไม่มีส่วนนี้ อันดับบนสุดจะเป็นเช็คพอยต์ของปี 2022 และ 2023 ที่ได้เปรียบจากดาวน์โหลดที่สะสมมาหลายปี
แสดงรายละเอียด
ทุกตัวเลขบนเว็บไซต์นี้ตรวจสอบได้ คะแนนความนิยมของโมเดลนี้คือ 8,096° และนี่คือการสร้างคะแนนทีละส่วน พร้อมยอดรวมที่เพิ่มขึ้นหลังจากแต่ละส่วน: ค่าพื้นฐาน, จำนวนองศาที่แต่ละแหล่งข้อมูลเพิ่ม, โบนัสสำหรับประเภทของโมเดล และการลดคะแนนตามอายุของน้ำหนัก สีต่างๆ คือช่วงของกราฟด้านบน คำศัพท์ท้ายบทความอธิบายคำทุกคำ
- 1เริ่มที่ค่าพื้นฐานทำไมต้อง 7,000° ไม่ใช่ศูนย์: มาตรวัดมีช่วงตั้งแต่ 0° ถึง 9,999° ส่วนที่ต่ำกว่า 7,000° ถูกสงวนไว้สำหรับโมเดลที่ยังไม่มีแหล่งข้อมูลรายงาน ซึ่งใช้ตัวเลขแทนที่ตรงนั้นเพื่อให้รายการครบถ้วนและไม่แซงหน้าโมเดลที่มีข้อมูล 7,000° คือจุดเริ่มต้นของข้อมูลที่วัดได้ โมเดลที่มีข้อมูลจริงแต่แทบไม่มีดาวน์โหลดจะอยู่ที่นี่ ทุกอย่างที่ตามมาคือการวัด และพื้นที่ด้านบนค่าพื้นฐานมีสิบขั้นตอนดาวน์โหลดที่เพิ่มขึ้นสิบเท่าที่ 300° ต่อขั้น ค่าพื้นฐานเหมือนกันสำหรับทุกโมเดล ดังนั้นมันจึงไม่ตัดสินอะไร; องศาที่เพิ่มขึ้นด้านบนต่างหากที่ตัดสิน7,000°ยอดรวมที่กำลังคำนวณ
- 2เพิ่มจำนวนการดาวน์โหลด2,624 เทียบเท่าการดาวน์โหลดทั้งหมด จาก ดาวน์โหลดจาก Civitai การดาวน์โหลดเพิ่มขึ้นสิบเท่าจะเพิ่ม 300° เท่ากัน ดังนั้นขนาดจึงสำคัญแต่ไม่ใช่ทุกอย่าง+1,026°8,026°ยอดรวมที่กำลังคำนวณ
- 3เพิ่มจำนวนไลก์224 ไลก์และการกดถูกใจ มีน้ำหนักครึ่งหนึ่งของการดาวน์โหลด+353°8,379°ยอดรวมที่กำลังคำนวณ
- 4ลบอายุออกน้ำหนัก Huny ออกมาในปี 2024: 150° ต่อปี สูงสุด 750° เพิ่มขึ้นจนถึงตอนนั้น−283°8,096°ยอดรวมที่กำลังคำนวณ
- =คะแนนความร้อนตำแหน่งของโมเดลนี้ในทุกลิสต์ของเว็บไซต์นี้ ไม่มีอะไรปรับแต่งเพิ่มเติม8,096°
คำศัพท์: คำที่ใช้ที่นี่
- คะแนนความร้อน
- ตัวเลขเดียวที่บอกว่าโมเดลถูกใช้และต้องการมากแค่ไหนตอนนี้ ตั้งแต่ 0° ถึง 9,999° ทุกลิสต์ที่บอกว่าร้อนแรงที่สุดจะเรียงตามคะแนนนี้เท่านั้น
- พื้นฐาน
- 7,000° คือจุดเริ่มต้นของทุกโมเดลที่มีข้อมูลจริง สเกลตั้งแต่ 0° ถึง 9,999° ส่วนที่ต่ำกว่าพื้นฐานสงวนไว้สำหรับตัวแทน (โมเดลที่ไม่มีข้อมูล) เพื่อให้โมเดลที่มีข้อมูลอยู่เหนือกว่า พื้นฐานเหมือนกันสำหรับทุกคนและไม่ตัดสินอะไร คะแนนที่สูงกว่าพื้นฐานคือการวัดผล
- เทียบเท่าการดาวน์โหลด
- ทุกอย่างที่คะแนนนับเป็นการดาวน์โหลด รวมกัน: การดาวน์โหลดจริง, ผู้แชร์แต่ละคนในทอร์เรนต์นับเป็น 1,000, ภาพ AI Horde แต่ละภาพ และแต่ละครั้งที่ใช้งานในเว็บไซต์สร้างภาพ
- สเกลลอการิทึม
- นับเป็นสิบ ไม่ใช่หน่วยเดียว: การเพิ่มจาก 1,000 เป็น 10,000 การดาวน์โหลดจะเพิ่มคะแนนเท่ากับการเพิ่มจาก 10,000 เป็น 100,000 เพื่อไม่ให้โมเดลใหญ่แย่งพื้นที่ทั้งหมด
- ไลก์
- การกดถูกใจและไลก์จากทุกแหล่ง มีค่าน้ำหนักครึ่งหนึ่งของการดาวน์โหลดในสเกลลอการิทึม
- อัตราการนำไปใช้
- จำนวนการดาวน์โหลดต่อวันที่โมเดลได้รับตอนนี้ วัดจากความต่างระหว่างสองครั้งที่อ่านข้อมูล น้ำหนักเป็นหนึ่งในสี่ของการดาวน์โหลด
- วัดได้และประมาณ
- วัดได้หมายถึงมีการอ่านค่าจากแหล่งที่มาสองครั้งและความแตกต่างนั้นเป็นของจริง ประมาณหมายถึงรู้แค่ยอดรวมของวันนี้เท่านั้น ส่วนอดีตจะถูกกระจายไปตามอายุของโมเดล; เว็บไซต์จะบอกว่ากำลังแสดงแบบไหน
- Seeder
- คนที่เก็บสำเนาน้ำหนักไว้บนออนไลน์เพื่อให้คนอื่นดาวน์โหลดผ่านทอร์เรนต์ หรือกระจกที่โฮสต์ทำแบบเดียวกัน แต่ละคนจะนับเป็น 1,000 ดาวน์โหลด
- AI Horde
- เครือข่ายอาสาสมัครที่สร้างภาพฟรีบนคอมพิวเตอร์ที่บริจาค จำนวนภาพที่สร้างด้วยโมเดลแต่ละตัวเป็นข้อมูลสาธารณะ และแต่ละภาพนับเป็นหนึ่งดาวน์โหลด
- เว็บไซต์สร้างภาพ
- เว็บไซต์ที่โฮสต์สำเนาโมเดลของตัวเองและให้คนสร้างภาพ เช่น PixAI, SeaArt และ Yodayo การดาวน์โหลดของพวกเขานับเหมือนกับ Civitai และแต่ละการสร้างภาพนับเป็นหนึ่งดาวน์โหลด
- โทเค็น OpenRouter
- โมเดลข้อความที่ให้บริการผ่าน API เช่น Claude หรือ GPT ไม่มีน้ำหนักให้ดาวน์โหลด ดังนั้นการใช้งานจะวัดจากโทเค็น: ชิ้นส่วนข้อความที่อ่านและเขียนผ่าน OpenRouter ซึ่งเป็นเกตเวย์ที่แอปหลายตัวใช้ใน 30 วันที่ผ่านมา ทุก 10,000,000 โทเค็นนับเป็นการดาวน์โหลดหนึ่งครั้ง แหล่งข้อมูล: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- โมเดลเต็ม (checkpoint)
- น้ำหนักโมเดลเอง ไฟล์ที่สร้างภาพได้ด้วยตัวเอง ได้รับโบนัสเพราะส่วนเสริมขึ้นอยู่กับมัน
- LoRA และ embedding
- ไฟล์เสริมขนาดเล็กที่ช่วยปรับน้ำหนักของคนอื่นให้ไปในสไตล์ ตัวละคร หรือแนวคิดเฉพาะ มันไม่สามารถทำงานได้เอง
- ตระกูลและน้ำหนัก
- ฐานที่โมเดลสร้างขึ้น เช่น SD 1.5, SDXL, Flux หรือ Wan โมเดลทุกตัวจะสืบทอดวันที่ปล่อยน้ำหนักของตระกูล
- อายุ
- ลดคะแนนตามระยะเวลาที่น้ำหนักของตระกูลถูกปล่อยออกมา: 150° ต่อปี สูงสุด 750° มันเก็บดาวน์โหลดเก่าที่สะสมมาหลายปีจากการแช่แข็งบนสุดของรายการ
- บูสต์ตระกูล
- แรงกระตุ้นเล็กๆ ที่จำกัดสำหรับ LoRA ของตระกูลที่เว็บไซต์นี้กำลังผลักดันอยู่ตอนนี้ จะแสดงในรายละเอียดเสมอ
- คะแนนสำรอง
- ตัวเลขที่มั่นคงต่ำกว่าค่าขั้นต่ำที่ให้กับโมเดลที่ยังไม่มีรายงานแหล่งที่มา เพื่อให้รายการครบถ้วน มันจะไม่จัดอันดับสูงกว่าโมเดลที่มีข้อมูล
- ใหม่! (ช่วงเวลาปลอดภัย)
- โมเดลที่มีอายุน้อยกว่า 7 วันจะแสดงคำว่า ใหม่! แทนคะแนนและจะไม่มีอันดับ โมเดลจะเริ่มคำนวณคะแนนตั้งแต่วันแรก แต่โมเดลที่อายุเพียงวันเดียวจะเติบโตเร็วที่สุด ดังนั้นถ้าไม่รอ โมเดลอันดับ #1 ของสัปดาห์จะเป็นโมเดลที่เพิ่งออกมาเมื่อวานแทนที่จะเป็นโมเดลที่อยู่ได้นานหนึ่งสัปดาห์
- แนวโน้ม
- การเติบโตของโมเดลในช่วงเวลาหนึ่งเทียบกับการเติบโตของโมเดลทั่วไปในช่วงเวลาเดียวกัน เร็วกว่าปกติหมายถึงเพิ่มขึ้น ช้ากว่าหมายถึงลดลง
- โมเดลทั่วไป
- จุดกึ่งกลางของแคตตาล็อก: ครึ่งหนึ่งของโมเดลที่มีตัวเลขเติบโตเร็วกว่าในช่วงเวลา ครึ่งหนึ่งช้ากว่า
ความนิยมของโมเดลนี้เปลี่ยนไปอย่างไรเมื่อเทียบกับแคตตาล็อกทั้งหมด: การเติบโตของการดาวน์โหลด ไลก์ และการใช้งานในแต่ละช่วงเวลา วัดเทียบกับการเติบโตเฉลี่ยของโมเดลทั่วไปในช่วงเวลาเดียวกัน พร้อมคะแนนความร้อนในเวลานั้น ถ้าอยู่เหนือการเติบโตเฉลี่ยคือเพิ่มขึ้น ต่ำกว่าคือถดถอย ข้อมูลในอดีตสร้างจากยอดรวมปัจจุบัน วันแรกของโมเดล และความเร็วดาวน์โหลดที่วัดได้ถ้ามีสองจุดข้อมูล โมเดลที่ยังไม่มีในช่วงเริ่มต้นจะแสดงเป็น n/a
ตัวอย่างผลงาน
พรอมต์และการตั้งค่าที่ผู้สร้างผลงานเหล่านี้บน Civitai แบ่งปันไว้ เลือกผลงานเพื่อดูว่าสร้างขึ้นอย่างไร
การตั้งค่า
จำนวนสเต็ป
26
Guidance
6
Seed
1899703252
ขนาด
480x720
น้ำหนักที่ใช้
0.8
พรอมต์
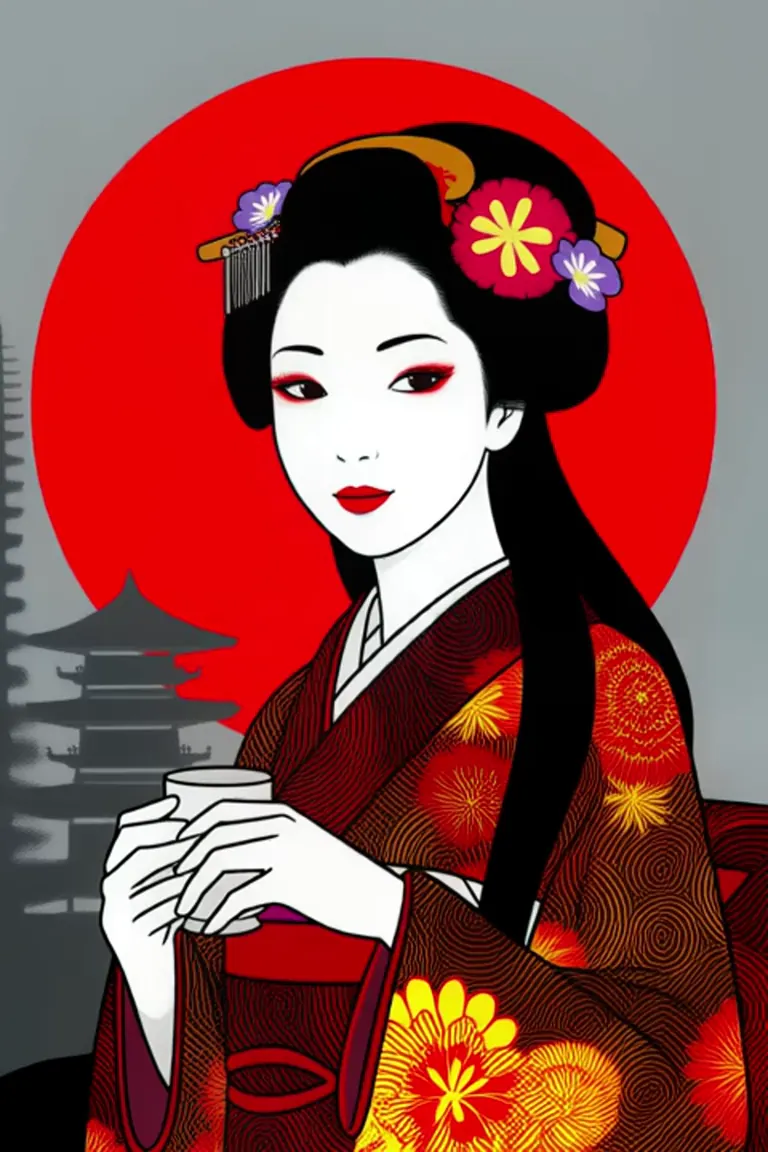
This is a digital illustration of an anime-style woman with a striking silhouette. She has long black hair adorned with colorful flowers and intricate hairpins. Her face is pale with red lips, and she wears a traditional Japanese kimono decorated with floral patterns in red, orange, and gold. A large, vivid red circle, resembling the sun, dominates the background, casting a shadow over her profile. She holds a small cup to her lips with her right hand. The background features a grayscale landscape with a traditional Japanese temple on the left and abstract floral designs. Japanese characters are written vertically along the sides of the image. The overall style combines elements of traditional Japanese art with modern anime aesthetics, using bold colors and high contrast between light and dark areas. The illustration has a textured, almost grunge-like effect, adding depth and complexity to the visual composition.
A scene from a Studio Ghibli animated film
รันในเครื่อง
studio_ghibli_hv_v03_19.safetensors
studio_ghibli_hv_v03.zip
การดาวน์โหลดให้บริการโดย Civitai ผู้สร้างบางรายกำหนดให้เข้าสู่ระบบ Civitai ก่อน
Studio Ghibli HunyuanVideo เป็นLoRAสำหรับตระกูล Hunyuan ที่อยู่ใน ModelTrends.ai แคตตาล็อกแบบอ่านอย่างเดียวของโมเดล AI สร้างภาพ วิดีโอ และข้อความแบบโอเพนซอร์ส เปรียบเทียบกับโมเดล Hunyuan อื่น ๆ ดูคะแนนความร้อนแรงเพื่อติดตามเทรนด์ และเปิดบน PirateDiffusion หรือ BitVector เพื่อลองใช้
เรียกดูตามตระกูลโมเดล
โมเดล Text / LLM
434
โมเดล Anima
528

โมเดล Chroma
19

โมเดล Fibo
2
โมเดล Flux
1,496
โมเดล Flux 2 / Klein
1,239

โมเดล Flux 3
3

โมเดล Moss
3

โมเดล Iris
1
โมเดล MiniMax H3
364
โมเดล Hunyuan
204

โมเดล Ideogram
20
โมเดล Krea2
717

โมเดล Qwen
20
โมเดล Qwen2
47
โมเดล Ltx2
153