Wan 2.2 Animate ComfyUI 工作流程:角色替换和视频中的姿势迁移
概述
Wan 2.2 Animate 需要一个视频和一张图片。在 Move 模式下,图片中的角色执行视频中的动作,表情逐帧复制;在 Mix 模式下,角色被替换到视频中原有人物的位置,并重新匹配光照。这是团队 Wan 模板中最复杂的:包含四十个节点,包括姿势估计(DWPose)、带点编辑器的分割模型(SAM2)用于标记人物,以及一个扩展组,用 77 帧的片段继续剪辑。
与本站其他工作流程不同,它需要三个自定义节点包:comfyui_controlnet_aux(DWPose)、ComfyUI-KJNodes 和 ComfyUI-segment-anything-2。ComfyUI Manager 可以通过“安装缺失的自定义节点”安装这三个包。模型是 Kijai 的 fp8 缩放 Animate 14B,lightx2v 四步 LoRA 降低时间,重光 LoRA 用于 Mix 模式匹配光照。模板故意限制输入大小:预处理大视频非常耗时。
托管在 ModelTrends.ai:video_wan2_2_14B_animate.json 模板,未做改动。
图片和视频片段
The ComfyUI team's launch clip for this model
Wan 2.2 Animate ComfyUI workflow: the workflow as it opens in ComfyUI
Wan 2.2 Animate ComfyUI workflow: the template's input picture
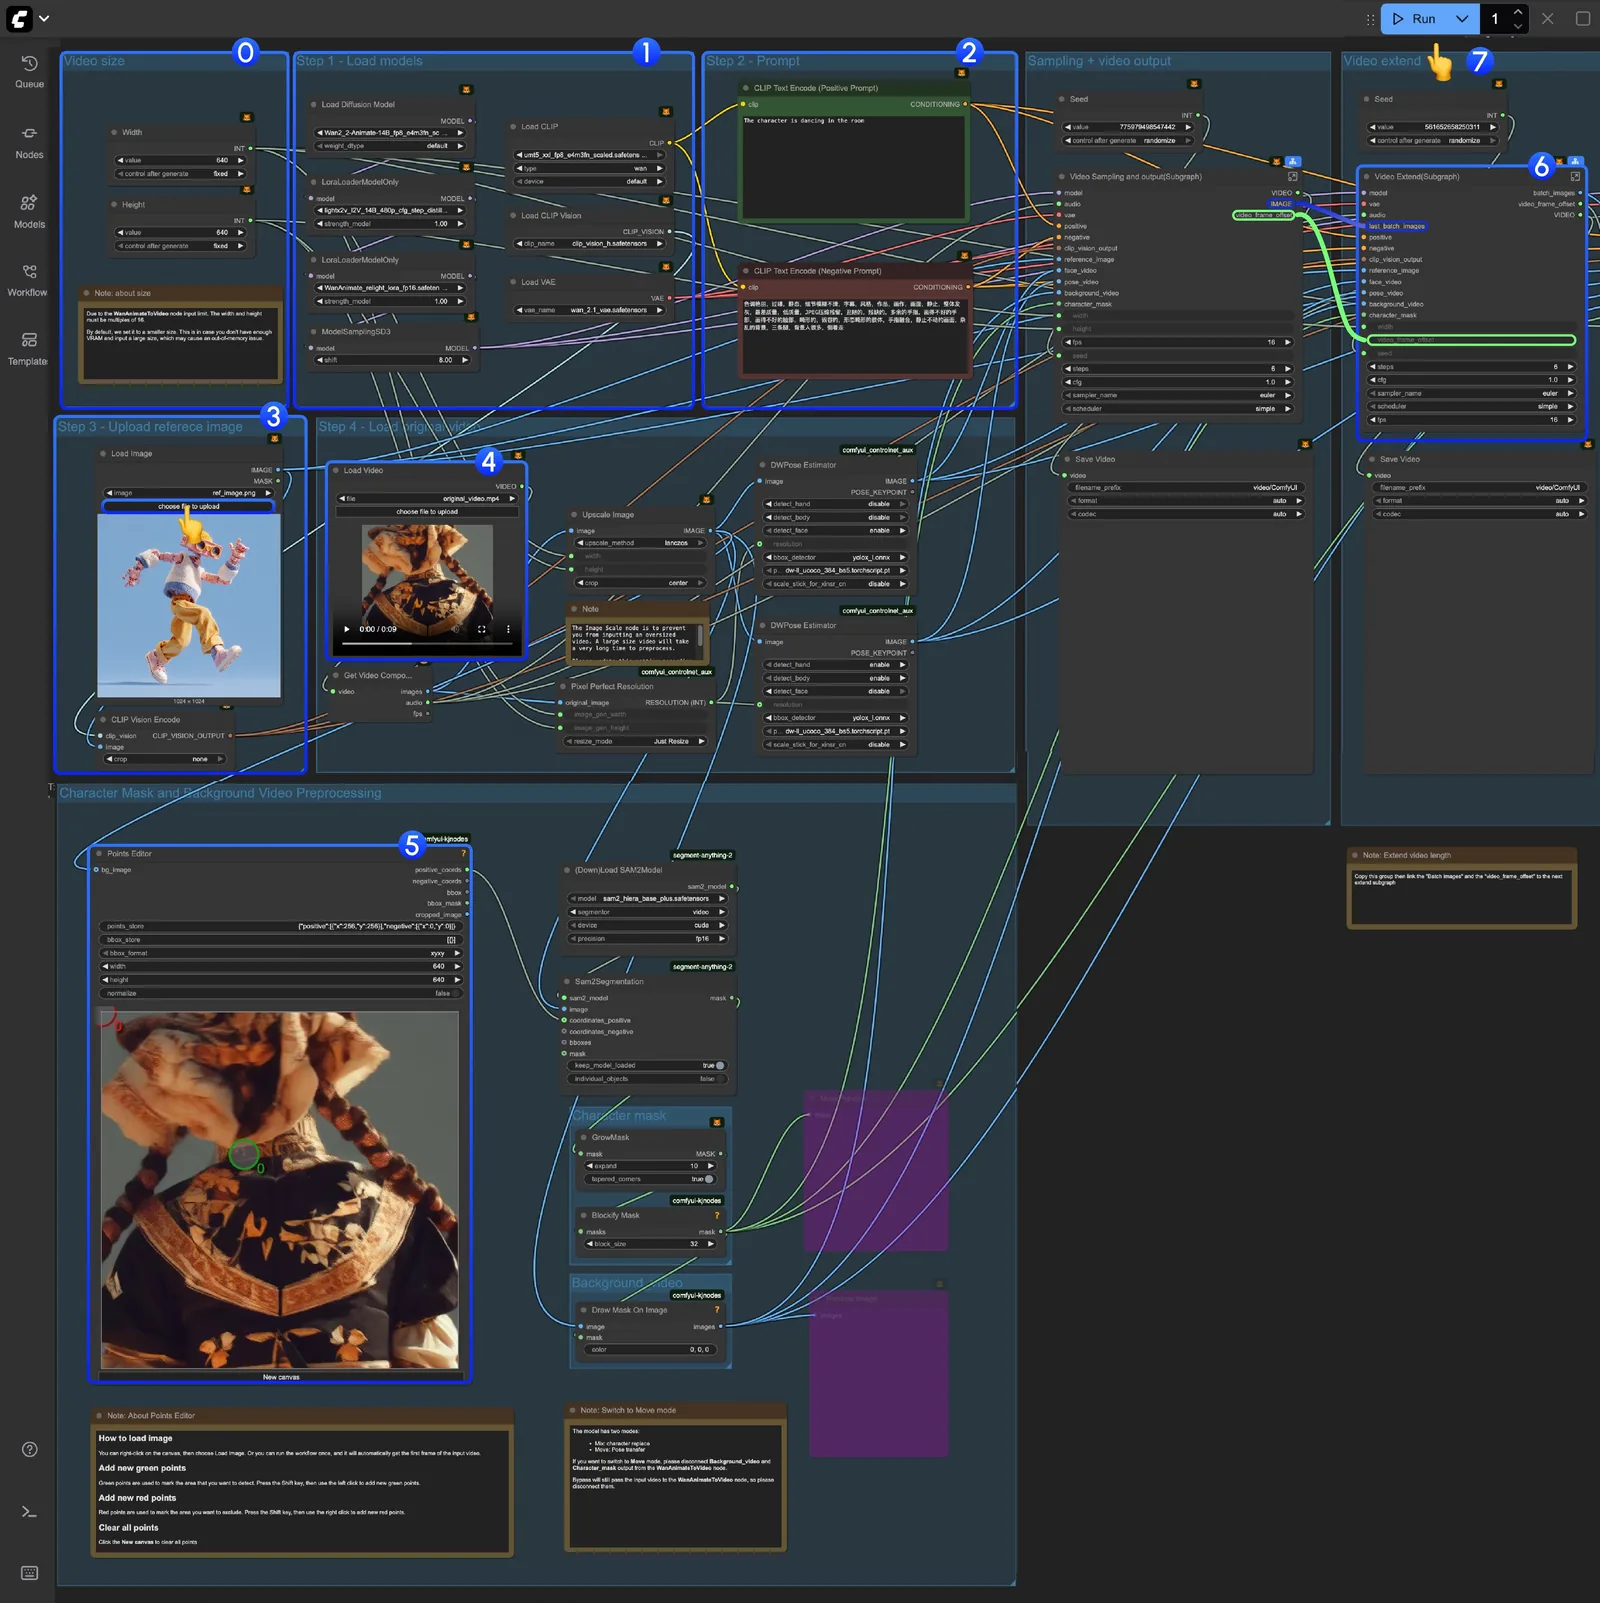
Wan 2.2 Animate ComfyUI workflow: the nodes to check, step by step
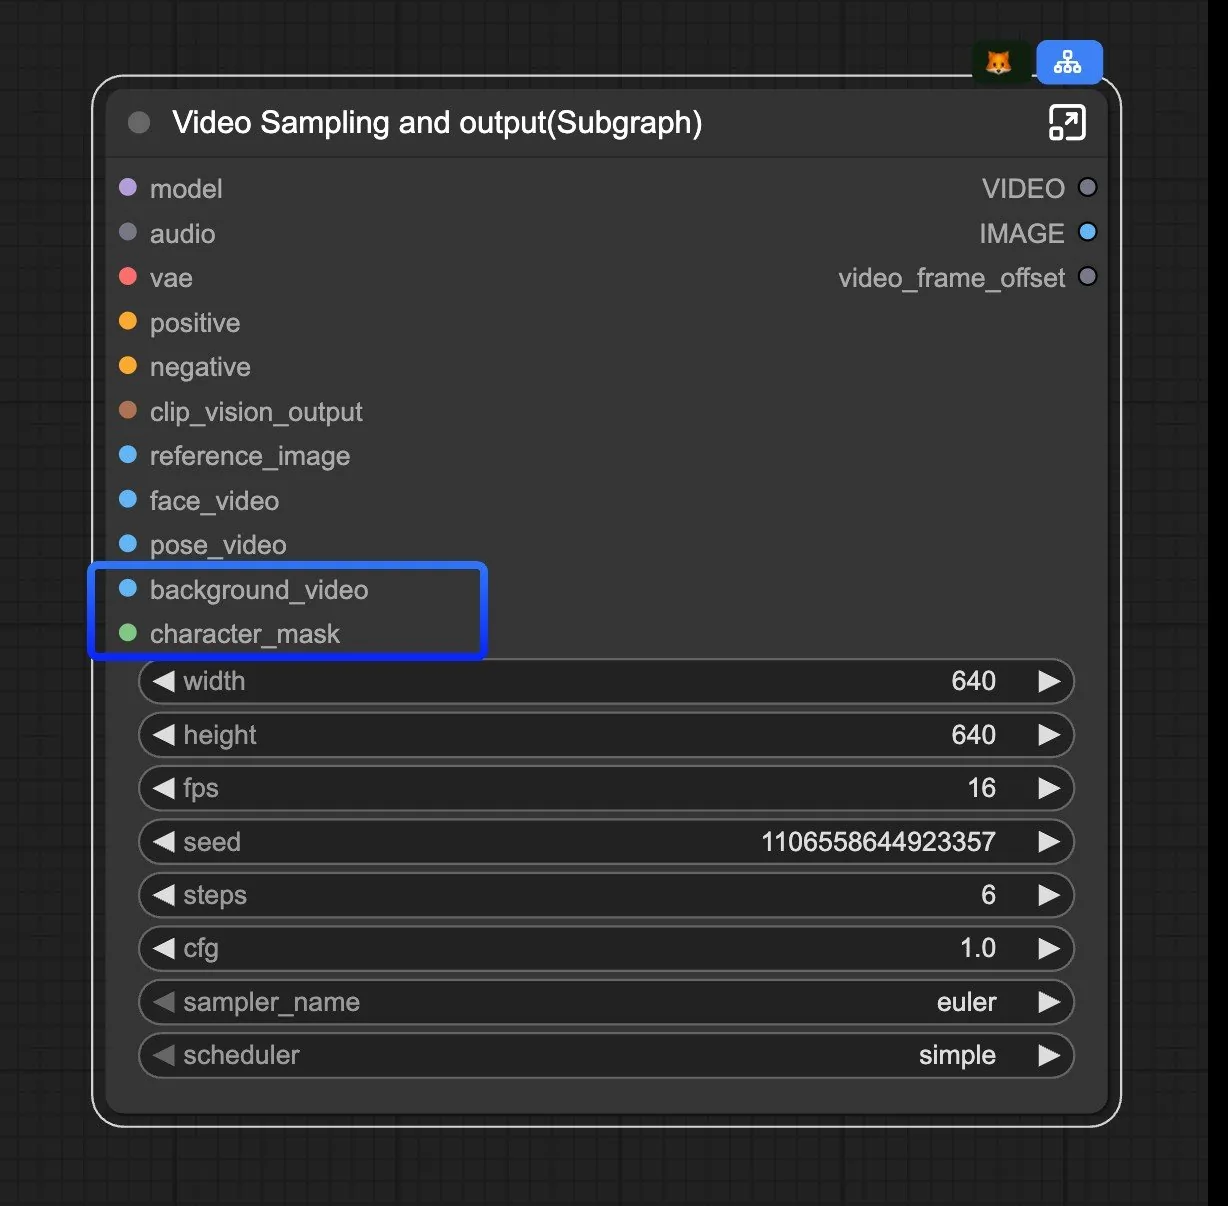
Wan 2.2 Animate ComfyUI workflow: inside the subgraph
参考
名称 | 类型 | 含义 |
|---|---|---|
Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors | models/diffusion_models | |
lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors | models/loras | |
WanAnimate_relight_lora_fp16.safetensors | models/loras | Mix 模式下为插入的角色重新匹配光照。Kijai/WanVideo_comfy,LoRAs/Wan22_relight。 |
umt5_xxl_fp8_e4m3fn_scaled.safetensors | models/text_encoders | |
wan_2.1_vae.safetensors | models/vae | |
clip_vision_h.safetensors | models/clip_vision | 读取图像到视频的起始图片。Comfy-Org/Wan_2.1_ComfyUI_repackaged。 |
Custom nodes | comfyui_controlnet_aux, ComfyUI-KJNodes, ComfyUI-segment-anything-2 | |
Load Video / Load Image | reference video, character picture | 视频提供动作(Mix 模式下也提供场景);图片提供角色。 |
Points Editor | green and red points | Shift+点击在要替换的人物上添加绿色点,红色点标记要保留的部分。 |
文件存放位置
把每个下载放到你 ComfyUI 安装目录的这个文件夹里。加载节点只会列出它读取的文件夹里的文件,所以模型放错文件夹会显示缺失。
ComfyUI/├───📂 models/│ ├───📂 diffusion_models/│ │ ├─── Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors│ │ └─── wan2.2_animate_14B_bf16.safetensors│ ├───📂 loras/│ │ └─── lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors│ ├───📂 text_encoders/│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors│ ├───📂 clip_visions/│ │ └─── clip_vision_h.safetensors│ └───📂 vae/│ └── wan_2.1_vae.safetensors
分步操作
- 更新 ComfyUI(桌面版:帮助 > 检查更新;便携版:运行 update_comfyui.bat)。这些工作流程需要 2025 或更新版本。
- 下载下面的工作流程文件,拖到 ComfyUI 画布上,或用 Workflow > Open 打开。节点会自动填入文件名。
- 打开 ComfyUI Manager,选择安装缺失的自定义节点,安装三个包后重启 ComfyUI。
- 下载表格中的所有文件,放到指定文件夹。如果模型控件显示红框,说明文件名与文件夹中不匹配:点击控件,选择你下载的文件。
- 加载参考视频和角色图片。保持 Image Scale 节点尺寸小(模板默认),直到了解运行时间。
- 运行一次:第一帧会出现在 Points Editor。Shift+点击绿色点标记要跟踪的人物;添加红色点标记要保留的部分。
- Mix 模式(替换视频中的人物)是默认。要用 Move 模式(角色自己执行动作),断开 WanAnimateToVideo 节点的 Background_video 和 Character_mask 连接,模板注释中有说明;仅绕过不够。
- 按运行(Ctrl+Enter)。第一次运行加载模型,耗时最长;后续运行会复用模型。默认尺寸下一段 77 帧大约几分钟,需 24 GB 显存。
- 要做更长的剪辑,复制扩展组,并将 Batch images 和 video_frame_offset 连接到下一个复制组,模板注释有示例。
示例
模板提示词
The character is dancing in the room
技巧
- WanAnimateToVideo 的宽高必须是 16 的倍数,模板中有提醒。
- 参考视频中有一个人,摄像机稳定,整个人体入镜,能给 DWPose 最干净的骨架。
- 角色图片应与视频构图匹配(跳舞用全身,讲话用半身)。
- 如果 SAM2 选错了人,给错误的人加红点,给你的人加第二个绿点。
问题排查
加载后节点变红
原因
缺少三个自定义节点包中的一个。
修复方法
Manager > 安装缺失的自定义节点,重启。如果 DWPose 下载失败,comfyui_controlnet_aux 的 README 里列出需要手动放置的模型文件。
预处理一直没完成
原因
输入视频太大。
修复方法
先把 Image Scale 节点长边调到 640,视频先剪辑成几秒。
CUDA 显存不足
原因
模型加潜变量超显存。
修复方法
先降低宽、高或帧数;选用 fp8 或 GGUF 版本的扩散模型;Load Diffusion Model 里把 weight_dtype 设为 fp8;关闭其他 GPU 程序。本站显存指南有各显卡数字。
遮罩覆盖了错误的人
原因
点标记错了对象。
修复方法
红点标错人,绿点标对人,重新运行。
常见问题
Mix 和 Move 有什么区别?
Mix 是把人物替换进原视频,保留背景并重新匹配光照。Move 是让你的角色自己执行视频的动作和表情。
我需要所有三个自定义节点包吗?
需要:DWPose 来自 comfyui_controlnet_aux,SAM2 来自 ComfyUI-segment-anything-2,还有一些辅助来自 KJNodes。
剪辑最长能多长?
每段 77 帧;扩展组把片段串起来,每段从上一段结尾开始。
链接与来源
- The ComfyUI blog post
- ComfyUI Wan 2.2 Animate tutorial
- Kijai WanVideo models
- Wan models on ModelTrends.ai
本指南涉及的模型
作者
掌舵这艘船。对 VAE 解码时间有很多没人问过的看法。相信权重应该是自由的,任何你下载不了的模型都是带额外步骤的订阅。不接受关于 NAS 上 400 GB 检查点的问题。
Captain 的所有指南
相关指南
Wan 2.2 14B 图像转视频 ComfyUI 工作流程:最佳开源照片到剪辑图
2026年10月9日
Wan 2.2 14B 文本到视频 ComfyUI 工作流程:两个模型,一个4步LoRA,影院级运动效果
2026年10月9日

ComfyUI 错误及修复方法:红色节点、缺失模型、CUDA 内存不足
2026年5月12日