
Wan 2.2 Animate ComfyUI 워크플로우: 비디오에서 캐릭터 교체와 포즈 전송
개요
Wan 2.2 Animate는 비디오와 사진을 입력받습니다. Move 모드에서는 사진 속 캐릭터가 비디오의 움직임을 따라 하며, 표정도 프레임별로 복사됩니다. Mix 모드에서는 비디오 속 원래 인물 대신 캐릭터가 붙여지고, 조명도 맞춰집니다. 이 템플릿은 팀의 Wan 템플릿 중 가장 복잡하며, 포즈 추정(DWPose), 사람을 표시하는 포인트 에디터가 있는 세그멘테이션 모델(SAM2), 그리고 77프레임 단위로 클립을 이어주는 확장 그룹 등 40개의 노드로 구성되어 있습니다.
이 사이트의 다른 워크플로우와 달리 세 가지 커스텀 노드 팩이 필요합니다: comfyui_controlnet_aux (DWPose), ComfyUI-KJNodes, ComfyUI-segment-anything-2. ComfyUI Manager에서 "Install Missing Custom Nodes"를 선택하면 세 가지 모두 설치됩니다. 모델은 Kijai의 fp8 스케일 Animate 14B이며, lightx2v 4단계 LoRA가 시간을 단축시키고, relight LoRA는 Mix 모드에서 조명을 맞춥니다. 템플릿은 입력 크기를 일부러 제한하는데, 큰 비디오를 전처리하는 데 시간이 너무 오래 걸리기 때문입니다.
ModelTrends.ai에서 호스팅 중인 video_wan2_2_14B_animate.json 템플릿이며 변경되지 않았습니다.
그림과 클립
The ComfyUI team's launch clip for this model
Wan 2.2 Animate ComfyUI workflow: the workflow as it opens in ComfyUI
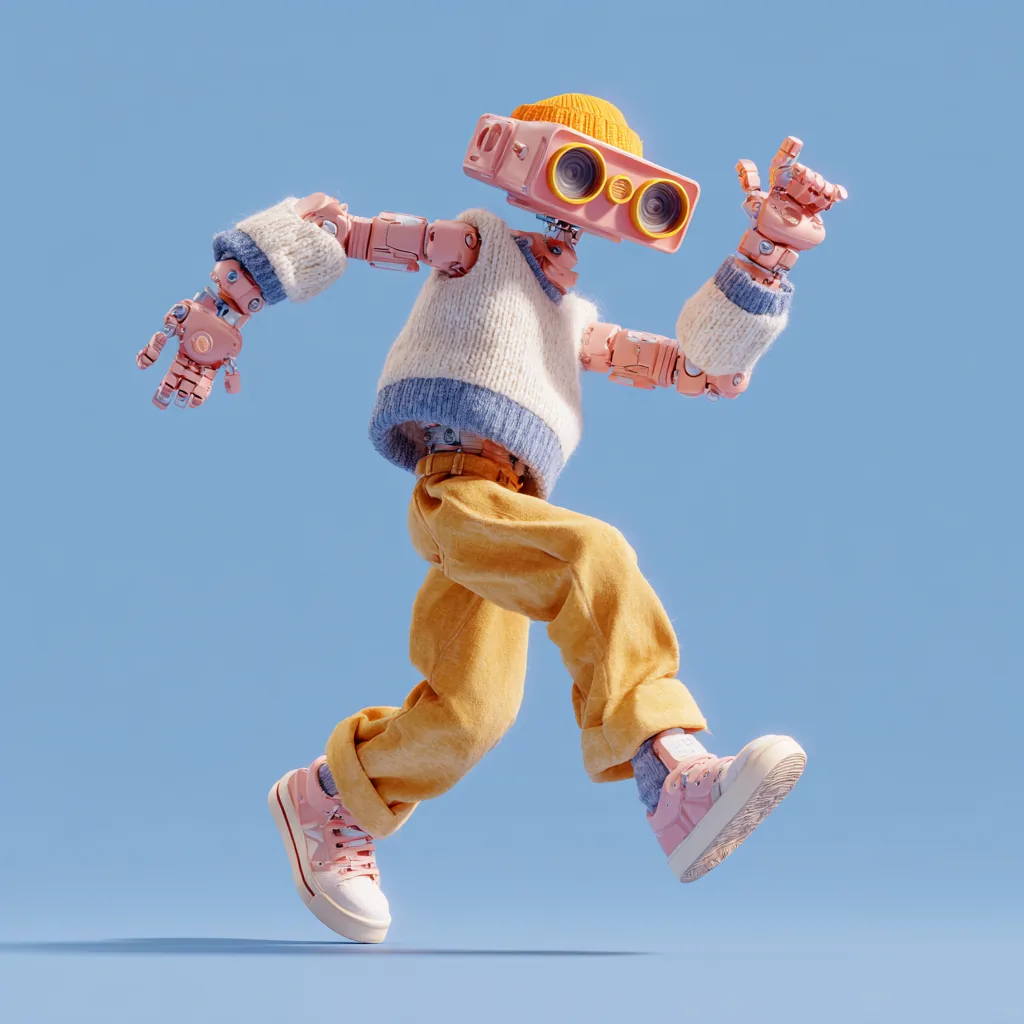
Wan 2.2 Animate ComfyUI workflow: the template's input picture
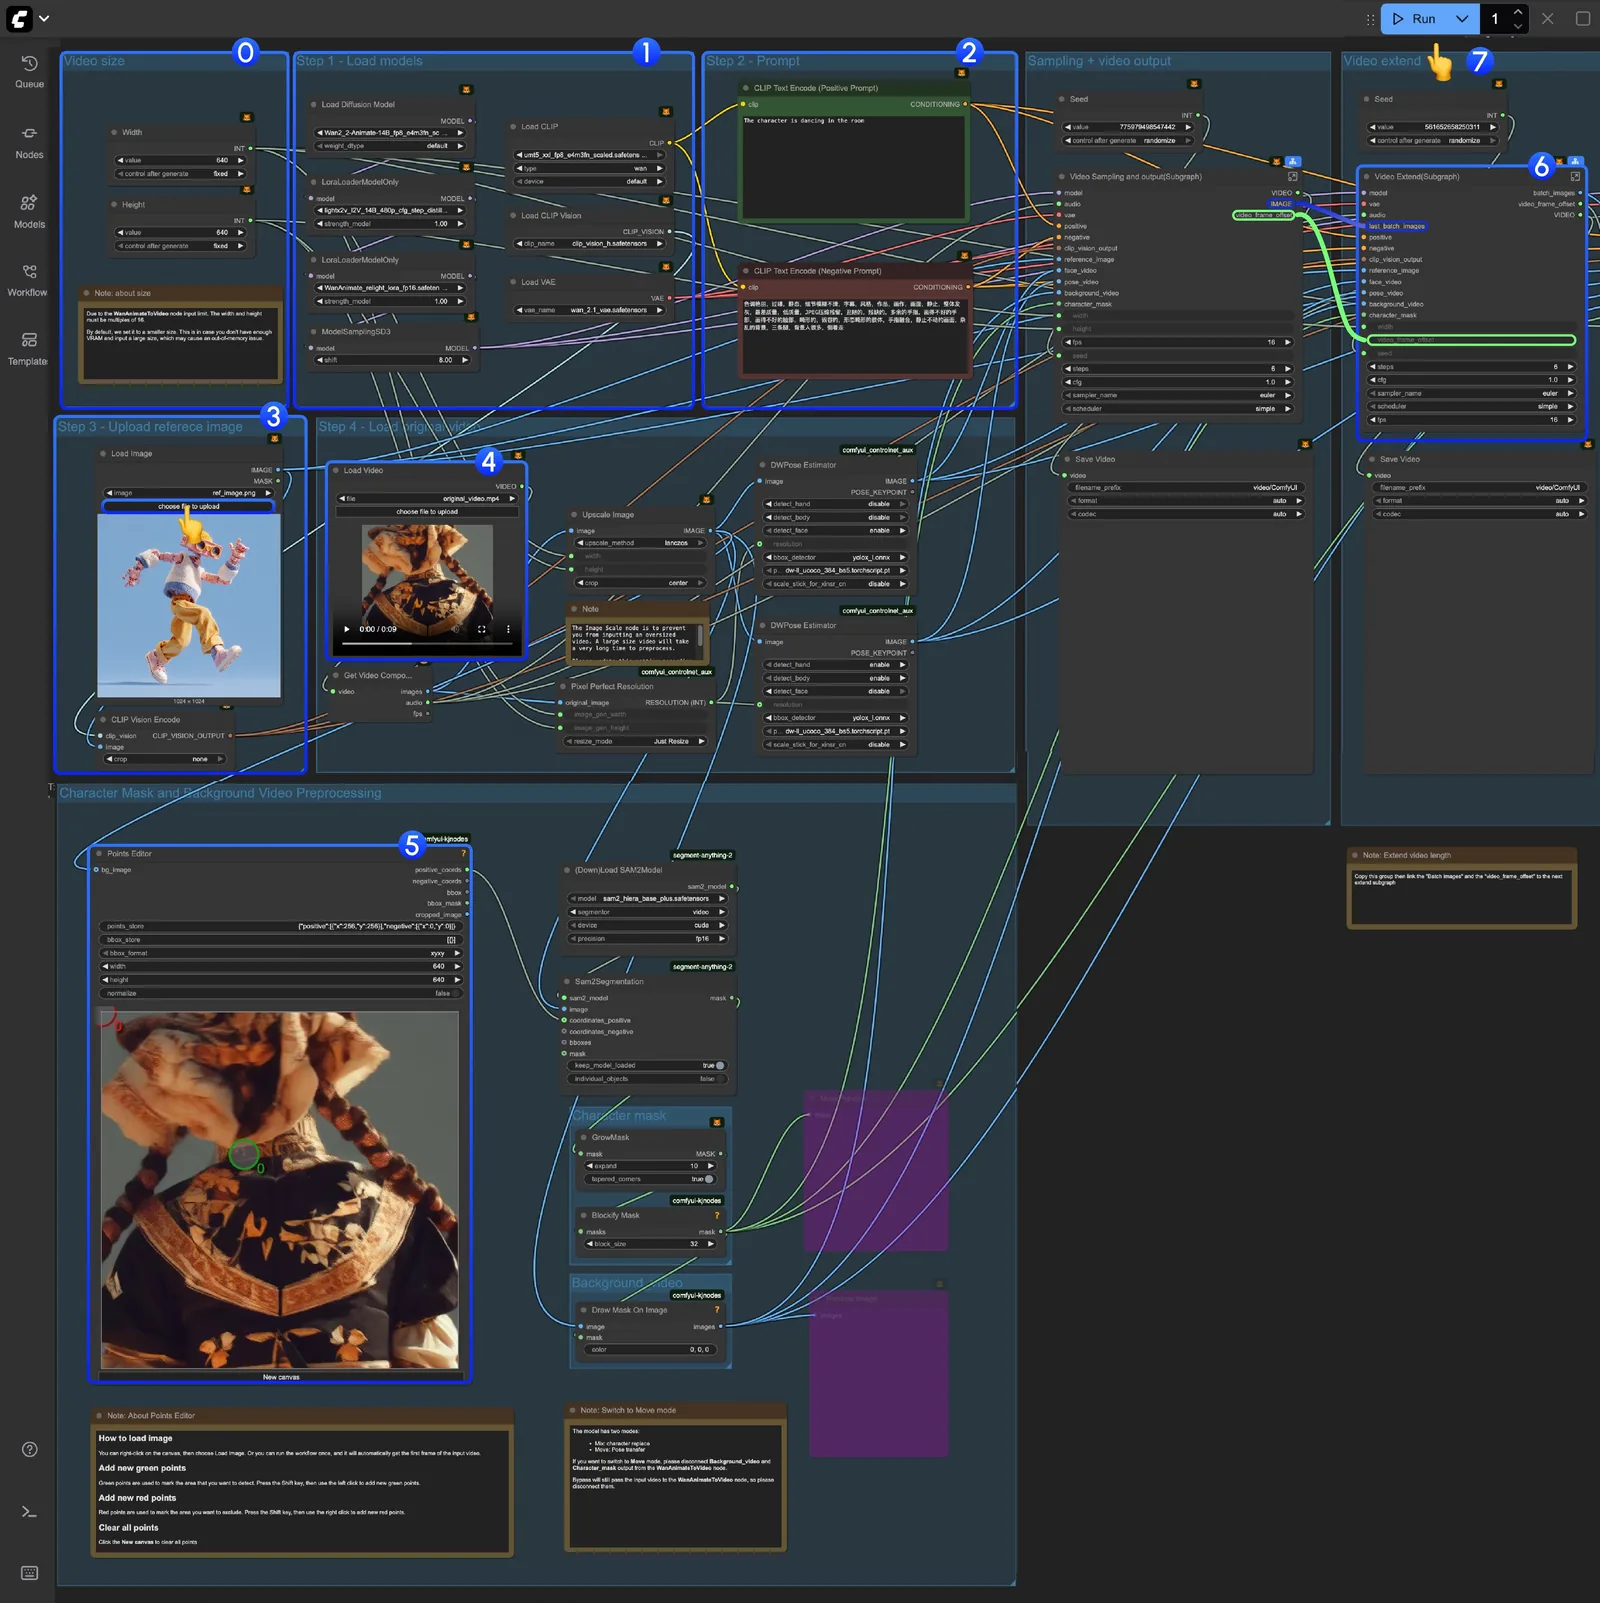
Wan 2.2 Animate ComfyUI workflow: the nodes to check, step by step
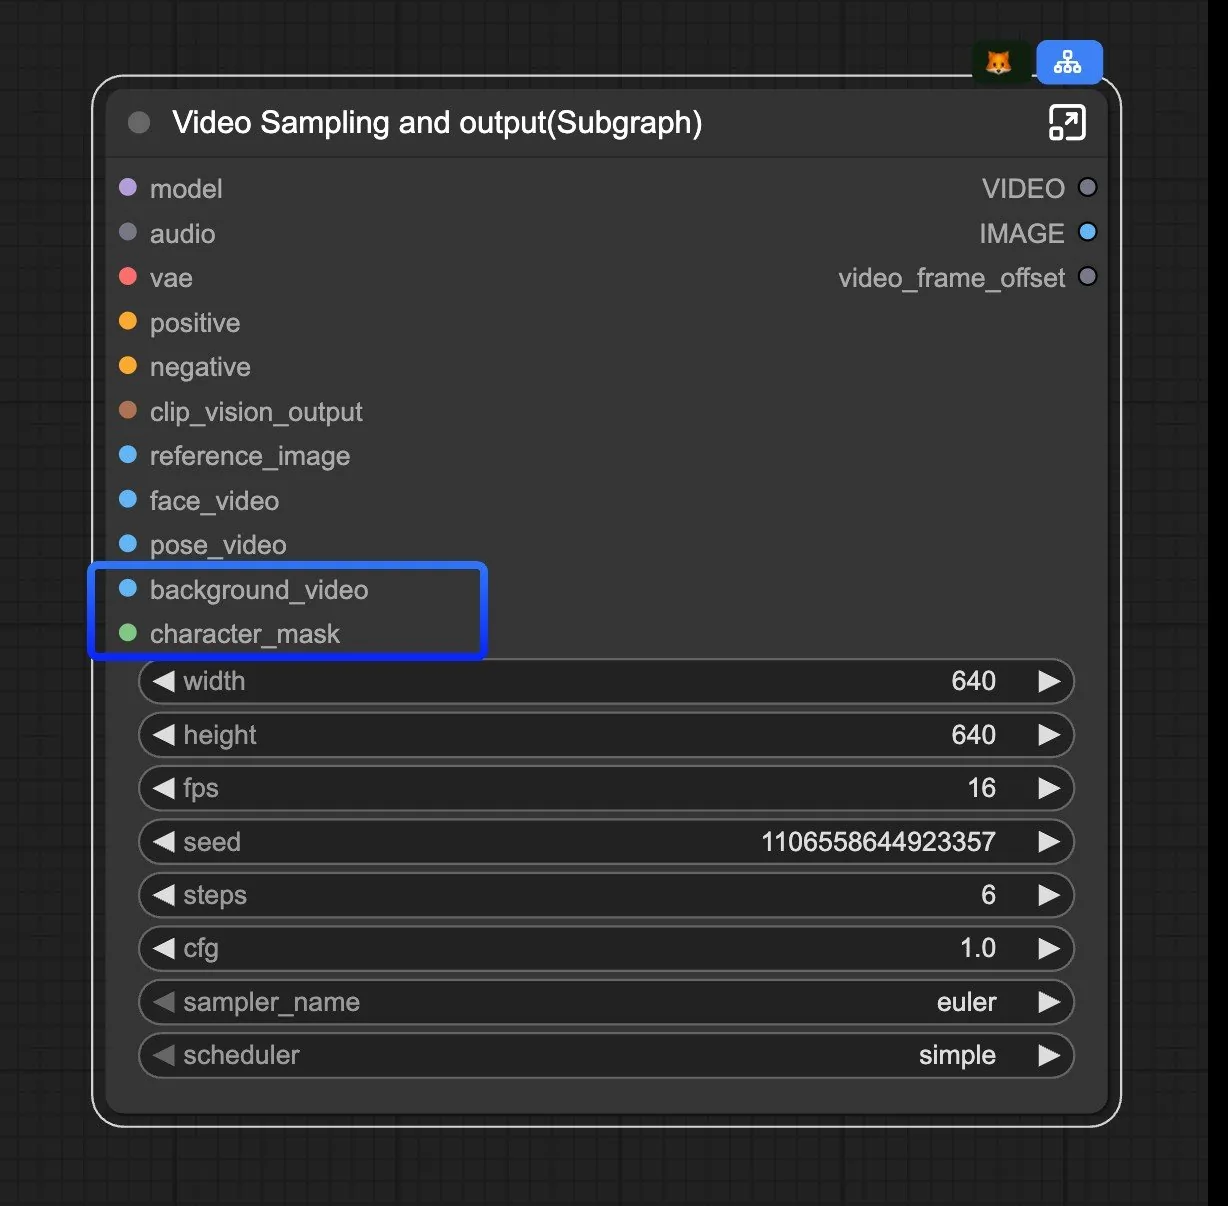
Wan 2.2 Animate ComfyUI workflow: inside the subgraph
참고 자료
이름 | 타입 | 의미 |
|---|---|---|
Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors | models/diffusion_models | |
lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors | models/loras | |
WanAnimate_relight_lora_fp16.safetensors | models/loras | Mix 모드에서 삽입된 캐릭터의 조명을 맞춤. Kijai/WanVideo_comfy, LoRAs/Wan22_relight. |
umt5_xxl_fp8_e4m3fn_scaled.safetensors | models/text_encoders | |
wan_2.1_vae.safetensors | models/vae | |
clip_vision_h.safetensors | models/clip_vision | 이미지-비디오 변환을 위한 시작 이미지 읽기. Comfy-Org/Wan_2.1_ComfyUI_repackaged. |
Custom nodes | comfyui_controlnet_aux, ComfyUI-KJNodes, ComfyUI-segment-anything-2 | ComfyUI Manager > Install Missing Custom Nodes에서 설치 후 재시작. |
Load Video / Load Image | reference video, character picture | 비디오는 움직임(및 Mix 모드에서는 장면)을 제공하고, 사진은 캐릭터를 제공합니다. |
Points Editor | green and red points | Shift+클릭으로 교체할 사람에 초록 점 추가, 빨간 점은 그대로 둘 부분 표시. |
파일 저장 위치
다운로드한 파일을 ComfyUI 설치 폴더 안 이 폴더에 넣어. 로더 노드는 읽는 폴더에 있는 파일만 보여주니까, 모델이 잘못된 폴더에 있으면 없다고 나와.
ComfyUI/├───📂 models/│ ├───📂 diffusion_models/│ │ ├─── Wan2_2-Animate-14B_fp8_e4m3fn_scaled_KJ.safetensors│ │ └─── wan2.2_animate_14B_bf16.safetensors│ ├───📂 loras/│ │ └─── lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors│ ├───📂 text_encoders/│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors│ ├───📂 clip_visions/│ │ └─── clip_vision_h.safetensors│ └───📂 vae/│ └── wan_2.1_vae.safetensors
단계별 안내
- ComfyUI 업데이트 (데스크톱: 도움말 > 업데이트 확인; 포터블: update_comfyui.bat 실행). 이 워크플로우는 2025년 이후 빌드가 필요합니다.
- 아래 워크플로우 파일을 다운로드해 ComfyUI 캔버스에 드래그하거나 Workflow > Open을 사용하세요. 노드들이 파일 이름과 함께 나타납니다.
- ComfyUI Manager를 열고 Install Missing Custom Nodes를 선택해 세 가지 팩을 설치한 뒤 ComfyUI를 재시작하세요.
- 표에 있는 모든 파일을 다운로드해 지정된 폴더에 넣으세요. 모델 위젯에 빨간 테두리가 보이면, 이름이 폴더 내 파일과 일치하지 않는 것입니다. 클릭해 다운로드한 파일을 선택하세요.
- 참조 비디오와 캐릭터 사진을 불러옵니다. 실행 시간을 알 때까지 Image Scale 노드는 작게 유지하세요(템플릿 기본값).
- 한 번 실행하면 첫 프레임이 Points Editor에 나타납니다. 교체할 사람에 Shift+클릭으로 초록 점을 찍고, 그대로 둘 부분에는 빨간 점을 추가하세요.
- Mix 모드(비디오 속 인물 교체)가 기본입니다. Move 모드(캐릭터가 스스로 움직임 수행)를 원하면, 워크플로우 노트에 따라 WanAnimateToVideo 노드에서 Background_video와 Character_mask 연결을 끊으세요; 단순 바이패스는 안 됩니다.
- 실행(Run, Ctrl+Enter)하세요. 첫 실행은 모델을 불러와 가장 오래 걸리며, 이후 실행은 모델을 재사용합니다. 기본 크기에서 77프레임 분량은 24GB 카드에서 몇 분 걸립니다.
- 더 긴 클립은 확장 그룹을 복사하고 Batch images와 video_frame_offset을 다음 복사본에 연결하세요. 템플릿 노트에 방법이 나와 있습니다.
예시
템플릿 프롬프트
The character is dancing in the room
팁
- WanAnimateToVideo는 너비와 높이가 16의 배수여야 합니다; 템플릿에서 경고합니다.
- 한 명이 나오고 카메라가 고정되며 몸 전체가 프레임에 들어간 참조 비디오가 DWPose에 가장 깨끗한 스켈레톤을 제공합니다.
- 캐릭터 사진은 비디오의 구도와 맞아야 합니다(춤이면 전신, 말하는 얼굴이면 상반신).
- SAM2가 잘못된 사람을 선택하면 그 사람에 빨간 점을, 내 캐릭터에 초록 점을 추가하세요.
문제 해결
불러온 후 빨간 노드가 보임
원인
세 가지 커스텀 노드 팩 중 하나가 없습니다.
해결 방법
Manager > Install Missing Custom Nodes를 선택하고 재시작하세요. DWPose 다운로드 실패 시 comfyui_controlnet_aux README에 수동으로 넣어야 할 모델 파일 목록이 있습니다.
전처리가 끝나지 않음
원인
입력 비디오가 너무 큽니다.
해결 방법
Image Scale 노드를 긴 쪽 640으로 낮추고 비디오를 몇 초로 자르세요.
CUDA 메모리 부족
원인
모델과 잠재 공간이 GPU 메모리에 안 맞습니다.
해결 방법
마스크가 잘못된 사람을 가림
원인
포인트가 잘못된 대상에 찍혔습니다.
해결 방법
잘못된 사람에 빨간 점, 내 캐릭터에 초록 점을 찍고 다시 실행하세요.
질문
Mix와 Move의 차이가 뭔가요?
Mix는 원래 비디오 속 인물을 교체하고 배경과 조명을 유지합니다. Move는 비디오의 움직임과 표정으로 캐릭터를 스스로 움직이게 합니다.
세 가지 커스텀 노드 팩이 모두 필요한가요?
네. DWPose는 comfyui_controlnet_aux에서, SAM2는 ComfyUI-segment-anything-2에서, 여러 도우미는 KJNodes에서 옵니다.
클립은 얼마나 길게 만들 수 있나요?
77프레임씩 나누어 확장 그룹이 이어 붙입니다. 각 조각은 이전 조각 끝에서 시작합니다.
링크 및 출처
- The ComfyUI blog post
- ComfyUI Wan 2.2 Animate tutorial
- Kijai WanVideo models
- Wan models on ModelTrends.ai
이 가이드의 모델
작성자
이 배를 운영합니다. 아무도 묻지 않은 VAE 디코드 시간에 대한 의견이 있습니다. 가중치는 자유로워지길 원하며 다운로드할 수 없는 모델은 추가 단계가 있는 구독이라고 믿습니다. NAS에 있는 400GB 체크포인트에 관한 질문은 받지 않습니다.
Captain의 모든 가이드
관련 가이드
Wan 2.2 14B 이미지에서 비디오로 ComfyUI 워크플로우: 최고의 오픈 사진-클립 그래프
2026년 10월 9일
Wan 2.2 14B 텍스트-투-비디오 ComfyUI 워크플로우: 두 모델, 4단계 LoRA, 시네마급 모션
2026년 10월 9일

ComfyUI 오류와 해결 방법: 빨간 노드, 모델 누락, CUDA 메모리 부족
2026년 5월 12일
더 많은 가이드

Wan 2.2 5B ComfyUI 워크플로우: 중급 카드 하나로 720p 텍스트 또는 이미지에서 비디오 만들기
2026년 10월 9일

Wan 2.1 이미지에서 비디오로 (480p, 14B) ComfyUI 워크플로우: 사진 애니메이션 만들기
2026년 10월 9일
Wan 2.1 텍스트-투-비디오 (1.3B) ComfyUI 워크플로우: 8GB 카드에서 첫 로컬 비디오 만들기
2026년 10월 9일

Wan 2.2 비디오: 텍스트-투-비디오와 이미지-투-비디오 설정, 세팅 및 LoRA
2026년 5월 24일
LTX-2 이미지에서 비디오로 ComfyUI 워크플로우: 정지 이미지에 소리 동기화 애니메이션 만들기
2026년 10월 9일