
Anima : léger, rapide, un peu indiscipliné
Aperçu
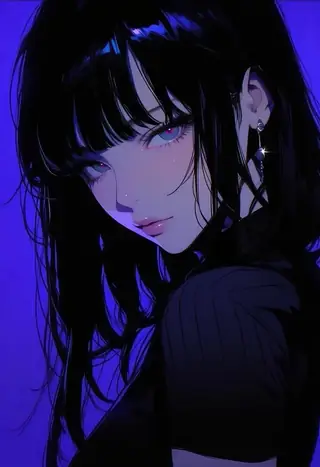
Anima est un modèle texte-vers-image conçu par ComfyUI avec CircleStone Labs, une start-up en IA. Il est apparu via quelques versions preview et un modèle de base v1, sans grand bruit. Le titre, c'est qu'il n'est pas photoréaliste : les notes de version indiquent un entraînement sur plusieurs millions d'images anime et environ 800 000 images artistiques non anime, sans données synthétiques, les données anime s'arrêtant en septembre 2025.
Le résultat est un modèle open source, compact, de 2 milliards de paramètres, construit dès le départ pour l'anime, le manga, l'illustration et le concept art, un domaine dominé par SDXL et ses fine-tunes comme Illustrious et Pony. Conçu pour cela, il produit des traits plus nets, une meilleure anatomie anime, des personnages plus cohérents et moins de réalisme accidentel.
Face à SDXL : SDXL est un ancien UNet avec des encodeurs de texte CLIP ; Anima est un transformer léger bâti sur une version allégée de l'architecture Cosmos de NVIDIA. Anima lit les prompts via un adaptateur de langage Qwen, il comprend donc le langage naturel et suit bien les prompts, tout en acceptant les tags Danbooru. Son VAE à 16 canaux (4 pour SDXL) donne un meilleur éclairage, une meilleure composition et plus de détails d'arrière-plan. Modèle en flow matching, il est plus lent que les checkpoints SDXL très optimisés sur GPU grand public, mais reste très rapide à côté des modèles photoréalistes lourds comme Qwen et Flux. SDXL possède l'immense écosystème de fine-tunes et de LoRA, et les LoRA SDXL ne sont pas compatibles, même si de nouveaux LoRA Anima apparaissent sans cesse. La licence de base de SDXL est permissive pour le commerce ; celle d'Anima est plus restrictive et orientée vers les projets personnels.
À l'usage : le rendu du texte est faible selon les standards actuels, à limiter à un ou deux mots. Le respect du prompt est bon mais pas au niveau de Qwen Image ou Flux.2 ; Anima se rebelle presque contre les prompts trop restrictifs et fonctionne bien mieux avec un guide souple et de la place pour créer. Il excelle en anime, mais avec le bon prompt et les bons tags il produit aussi de l'aquarelle, des croquis, de la 3D, de l'huile et des résultats assez abstraits, et les LoRA vont plus loin. Attendez-vous à varier prompt, seed et sampler sur quelques générations avant de tomber juste. Le modèle de base n'ayant que quelques semaines, les fine-tunes et LoRA devraient se multiplier dans les mois à venir.
Référence
Nom | Type | Rôle |
|---|---|---|
Modèle | fichier | |
Encodeur de texte | fichier | |
VAE | fichier | |
matériel | Officiellement 8 Go ; des utilisateurs rapportent que 6 Go fonctionnent. Sur une carte de 16 Go, il n'en utilise généralement que la moitié. | |
Résolution | réglage | La documentation officielle suggère 1 à 2 mégapixels. 1:1, 3:4, 4:5 et 16:9 fonctionnent tous ; jusqu'à 1536x1536 passe sans problème, mais la qualité est légèrement meilleure et plus régulière un peu en dessous. |
Étapes | réglage | |
réglage | 4 à 5. Anima donne des résultats plus propres avec une guidance basse ; au-dessus de 10 environ, les couleurs saturent avec des contours durs et des hautes lumières brûlées. | |
Sampler / scheduler | réglage | er_sde avec simple est un bon défaut (trait net, aplats anime, régulier). Euler A : traits plus doux, plus pictural, légèrement 2.5D, bon pour les personnages et les couvertures. DPM++ 2M SDE GPU : plus de variation et des compositions plus riches, imprévisible avec des prompts complexes. Le KSampler standard ; le sampler ClownShark n'a pas donné de bons résultats jusqu'ici. |
Prompt négatif | prompt | Pris en charge. Utilisez-le pour écarter des styles comme « photorealistic » et pour les tags habituels : blurry, low resolution, oversaturated, watermark, messy typography, distorted anatomy, overexposed highlights, bad hands, malformed hands. |
Tags de sécurité | prompt | Anima est assez peu censuré et peut produire du contenu indésirable à partir de prompts courts ou vagues. Placez safe, sensitive, nsfw ou explicit dans le prompt positif ou négatif selon le cas, surtout en réutilisant de courts prompts de style Danbooru. |
@artist | prompt | Les tags de référence d'artiste doivent être précédés du symbole @ et se placent de préférence en début de prompt. L'Anima Style Explorer recense quelque 60 000 styles d'artistes issus du jeu d'entraînement. |
Pas à pas
- Chargez les trois fichiers dans ComfyUI : le modèle de base Anima, l'encodeur de texte Qwen3 0.6B et le VAE Qwen Image. Anima est pris en charge nativement et livré avec des modèles d'exemple dans la dernière version de ComfyUI ; le workflow standard est très simple.
- Partez du modèle standard : KSampler, sampler er_sde, scheduler simple, 30 à 40 étapes, CFG 4 à 5, un canevas de 1 à 2 mégapixels.
- Écrivez le prompt en langage courant, deux à trois courts paragraphes au plus. Les prompts très courts laissent beaucoup de liberté créative ; les très longs dégradent le respect du prompt et parfois la qualité.
- Ajoutez des tags Danbooru là où ils aident, avec les références de style ou @artist au début. Restez propre et concis : Anima est sensible à la surcharge de tags répétitifs.
- Ajoutez un prompt négatif avec les styles non voulus (par exemple photorealistic) et les tags de qualité habituels, plus un tag de sécurité si le prompt positif est court ou vague.
- Générez et considérez le résultat comme un brouillon. S'il manque le détail voulu, assouplissez la formulation plutôt que de la durcir, puis variez seed, tags et sampler sur quelques générations.
- Pour un autre rendu, changez d'abord de sampler (Euler A pour le pictural, er_sde pour l'anime net et plat, DPM++ 2M SDE GPU pour la variété), puis essayez un LoRA ; un LoRA n'ajoute que quelques secondes.
Exemples
Un prompt de style Danbooru
1girl, solo, looking at viewer, masterpiece, detailed eyes
Le prompt négatif habituel
photorealistic, blurry, low resolution, oversaturated, watermark, messy typography, distorted anatomy, overexposed highlights, bad hands, malformed hands
Réglages de référence
RTX 4060 Ti 16 GB, standard workflow, er_sde / simple, 30 steps: about 1.8 s per step, a finished image in under a minute, VRAM at roughly 50%.
Astuces
- Les tags Danbooru sont économes en tokens et laissent au modèle de la place pour créer ; le langage naturel donne plus de contrôle. Les utilisateurs rapportent que le prompting hybride offre le meilleur équilibre entre compréhension du prompt et esthétique anime.
- Les tags Danbooru viennent de Danbooru, un imageboard anime lancé en 2005 dont le système de tags consultables est devenu l'une des taxonomies d'images les plus complètes d'Internet ; beaucoup de modèles anime ont été entraînés sur des images taguées Danbooru, d'où l'efficacité du prompting par tags.
- Des prompts structurés simples en JSON ou YAML fonctionnent parce que l'encodeur Qwen les interprète, mais ils se dégradent vite dès qu'ils se complexifient et rien n'indique qu'ils produisent de meilleures images que le langage naturel ou les tags.
- Changer de sampler ou de scheduler modifie à peine le temps de génération, mais avec Anima cela peut beaucoup changer le résultat ; le même prompt et la même seed via euler, euler-a, er-sde et dpmpp-sde-gpu donnent quatre images nettement différentes.
- Un CFG plus bas que sur d'autres modèles anime. Certains aiment des CFG très élevés ; pas Anima.
- Pour un contrôle précis, prenez un modèle comme Flux.2. Anima est un modèle anime, illustration et art plus libre, qui prend une idée approximative et l'interprète de bien des façons.
- L'anime est le point fort, puis l'aquarelle, les croquis, la 3D et les styles à l'huile. Un prompt aquarelle plus un LoRA comme Vector Paintings de Daalis pousse le style plus loin.
- La fiche de modèle Hugging Face en dit plus sur l'ordre des tags, la syntaxe et l'approche en langage naturel.
Dépannage
L'image ignore les détails d'un long prompt
Pourquoi cela arrive
Les prompts très longs ou très restrictifs dégradent le respect du prompt et parfois la qualité ; le modèle fonctionne mieux avec un guide souple.
Comment le corriger
Réduisez le prompt à deux ou trois courts paragraphes, gardez la direction générale, retirez les détails fins, puis lancez quelques seeds.
Couleurs saturées, contours durs, hautes lumières brûlées
Pourquoi cela arrive
CFG trop élevé ; au-dessus de 10 environ, Anima brûle l'image.
Comment le corriger
Ramenez le CFG à 4 ou 5.
Contenu adulte non désiré à partir d'un prompt court
Pourquoi cela arrive
Anima est assez peu censuré et complète seul les prompts vagues ou courts, surtout les prompts Danbooru réutilisés.
Comment le corriger
Ajoutez safe ou sensitive au prompt positif, ou nsfw et explicit au prompt négatif, et détaillez davantage le prompt.
Les membres sortent raccourcis avec le LoRA Turbo
Pourquoi cela arrive
Le premier LoRA Turbo (8 à 12 étapes) raccourcit parfois les membres.
Comment le corriger
Utilisez le modèle de base à 30 ou 40 étapes pour ces images, ou gardez Turbo pour les brouillons rapides.
Le texte dans l'image est illisible
Pourquoi cela arrive
Le rendu du texte est faible selon les standards actuels.
Comment le corriger
Limitez le texte dans l'image à un ou deux mots, ou ajoutez-le au montage.
Questions
Les LoRA SDXL fonctionnent-ils avec Anima ?
Non. Anima utilise une architecture différente, les LoRA SDXL ne sont donc pas compatibles nativement. De nouveaux LoRA entraînés pour Anima apparaissent sans cesse.
Anima prend-il en charge le prompting JSON ?
Pas nativement, à notre connaissance. Des prompts JSON ou YAML simples fonctionnent parce que l'encodeur de texte Qwen les interprète, mais ils se dégradent vite en se complexifiant et ne donnent pas de meilleures images que le langage naturel ou les tags.
Quelle est sa vitesse ?
Sur une RTX 4060 Ti 16 Go avec le workflow standard, er_sde / simple et 30 étapes, environ 1,8 seconde par étape et une image finie en moins d'une minute, avec la moitié de la VRAM. Un LoRA ajoute quelques secondes.
Puis-je l’utiliser commercialement ?
La licence d'Anima est plus restrictive que la licence de base de SDXL et orientée vers les projets personnels. Lisez la licence avant tout usage commercial.
Est-ce réservé à l'anime ?
L'anime est son point fort, mais avec le bon prompt et les bons tags il produit aussi de l'aquarelle, des croquis, de la 3D, de l'huile et des résultats assez abstraits, et les LoRA l'emmènent vers d'autres styles.
Liens et sources
- Anima: light, fast, slightly unruly, by Chris Green on Medium
- Diffusion Doodles, Chris Green's Substack (original publication)
Modèles de ce guide
Écrit par
Construit des machines dans un garage qui chauffe plus que les GPU. Fait deux fois les benchmarks, une fois pour la science et une fois parce que le premier chiffre était embarrassant. Utilise des modèles locaux par principe et avec une 3090 d’occasion. Croit que le cloud est la machine de quelqu’un d’autre avec une marge.
Tous les guides de Chris Green
Guides associés
Nœuds ComfyUI : documentation et dépannage
2 Juin 2026

MiniMax H3 prompts vidéo : la structure officielle
14 Sept 2026
Autres guides
Best AI Models for Anime in 2026: MOSS-Image, Anima, Illustrious
16 Oct 2026
Modificateurs de Qualité Esthétique - Masterpiece pour Anima : donner du sens aux tags de qualité
1 Oct 2026
Anime dans le réel pour Anima : personnages d'anime dans des décors réalistes
30 Sept 2026
Style > gpt-image-2 pour Anima : amélioration des détails, de l'éclairage et de la texture
1 Oct 2026
MOSS-Image: a 5B anime and illustration model with layout control
19 Oct 2026