
Anima: lätt, snabb, lite busig
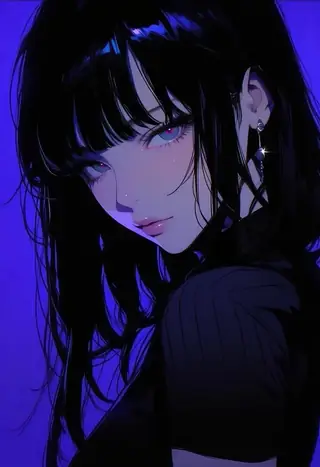
Översikt
Anima är en text-till-bild-modell skapad av ComfyUI tillsammans med CircleStone Labs, ett AI-startup. Den dök upp genom några förhandsversioner och en v1-basmodell utan mycket uppståndelse. Det viktiga är att det inte är en fotorealistisk modell: release-noterna säger att den tränades på flera miljoner animebilder och runt 800 tusen icke-anime konstnärliga bilder, utan syntetisk data, och att anime-träningsdata slutar i september 2025.
Resultatet är en öppen källkod, kompakt modell med 2 miljarder parametrar byggd från grunden för anime, manga, illustration och konstnärlig konceptkonst, ett område som SDXL och dess finjusteringar som Illustrious och Pony har dominerat. Den är byggd för det ändamålet och ger renare linjer, bättre animeanatomi, mer konsekvent karaktärsgengivning och mindre oavsiktlig realism.
Jämfört med SDXL: SDXL är en äldre UNet med CLIP-textkodare; Anima är en lättvikts-transformer byggd på en strömlinjeformad version av NVIDIAs Cosmos-arkitektur. Anima läser prompts via en Qwen-språkadapter, så den förstår naturligt språk och följer prompts bra, samtidigt som den stöder Danbooru-taggar. Dess 16-kanals VAE (SDXL har 4) ger bättre belysning, komposition och bakgrundsdetaljer. Eftersom det är en flow-matching-modell är den långsammare än mycket optimerade SDXL-checkpoints på konsument-GPU:er, men ändå väldigt snabb jämfört med tunga fotorealistiska modeller som Qwen och Flux. SDXL har ett stort ekosystem av finjusteringar och LoRAs och SDXL LoRAs är inte kompatibla, men nya Anima LoRAs dyker upp hela tiden. SDXL:s baslicens är kommersiellt tillåtande; Animas är mer restriktiv och riktad mot personliga hobbyprojekt.
I användning: textåtergivning är svag enligt dagens standard, bäst att hålla till ett eller två ord. Promptföljsamheten är bra men inte på Qwen Image- eller Flux.2-nivå; Anima gör nästan uppror mot för restriktiva prompts och fungerar mycket bättre med en lös guide och utrymme för kreativitet. Den är starkast på anime, men med rätt prompt och taggar gör den också akvarell, skisser, 3D, olja och ganska abstrakta bilder, och LoRAs tar det ännu längre. Räkna med att variera prompt, seed och sampler över några generationer innan du hittar rätt. Med basmodellen bara ett par veckor gammal förväntas finjusteringar och LoRAs mångfaldigas under de kommande månaderna.
Referens
Namn | Typ | Vad det är |
|---|---|---|
Model | file | |
Text encoder | file | Qwen3 textkodaren med 0.6 miljarder parametrar (1.2 GB), från samma Hugging Face-sida. |
VAE | file | |
hardware | Officiellt 8 GB; användare rapporterar att 6 GB fungerar. På ett 16 GB-kort använder den vanligtvis bara ungefär hälften. | |
Resolution | setting | Den officiella dokumentationen föreslår 1 till 2 megapixlar. 1:1, 3:4, 4:5 och 16:9 fungerar alla; upp till 1536x1536 fungerar bra men kvaliteten är lite bättre och mer konsekvent lite lägre. |
Steps | setting | |
setting | 4 till 5. Anima ger renare resultat med lägre vägledning; över ungefär 10 blir färgerna övermättade med hårda konturer och utbrända högdagrar. | |
Sampler / scheduler | setting | er_sde med simple är en bra standard (skarpa linjer, platt anime-färgning, konsekvent). Euler A: mjukare linjer, mer måleriskt, lite 2.5D, bra för karaktärskonst och omslag. DPM++ 2M SDE GPU: mer variation och rikare kompositioner, oförutsägbar med komplexa prompts. Standard KSampler; ClownShark-samplern har inte gett bra resultat hittills. |
prompt | Stöds. Använd den för att styra bort från stilar som "photorealistic" och för vanliga taggar: blurry, low resolution, oversaturated, watermark, messy typography, distorted anatomy, overexposed highlights, bad hands, malformed hands. | |
Safety tags | prompt | Anima är ganska ocensurerad och kan producera oönskat innehåll från korta eller vaga prompts. Lägg till safe, sensitive, nsfw eller explicit i den positiva eller negativa prompten vid behov, särskilt när du återanvänder korta Danbooru-stil prompts. |
@artist | prompt | Artistreferenstaggar måste föregås av @-symbolen och placeras helst i början av prompten. Anima Style Explorer listar ungefär 60 000 artiststilar från träningsdata. |
Steg för steg
- Ladda de tre filerna i ComfyUI: Anima-basmodellen, Qwen3 0.6B textkodaren och Qwen Image VAE. Anima stöds nativt och levereras med grundläggande exempelmallar i senaste ComfyUI; standardarbetsflödet är väldigt enkelt.
- Börja med standardmallen: KSampler, er_sde sampler, simple scheduler, 30 till 40 steg, CFG 4 till 5, en canvas på 1 till 2 megapixlar.
- Skriv prompten på vanligt språk, högst två till tre korta stycken. Mycket korta prompts ger modellen mycket kreativ frihet; mycket långa prompts försämrar följsamhet och ibland kvalitet.
- Blanda in Danbooru-stil taggar där de hjälper, med eventuella stil- eller @artist-referenser i början. Håll det rent och koncist: Anima är känslig för överbelastning av repetitiva taggar.
- Lägg till en negativ prompt med stilar du inte vill ha (t.ex. photorealistic) och vanliga kvalitets-taggar, samt en säkerhetstagg när den positiva prompten är kort eller vag.
- Generera och titta på resultatet som ett utkast. Om det saknas detaljer du ville ha, gör prompten lösare istället för striktare, och variera sedan seed, taggar och sampler över några generationer.
- När du vill ha ett annat utseende, byt sampler först (Euler A för måleriskt, er_sde för skarp platt anime, DPM++ 2M SDE GPU för variation), och prova sedan en LoRA; en LoRA lägger bara till några sekunder.
Exempel
En Danbooru-stil prompt
1girl, solo, looking at viewer, masterpiece, detailed eyes
Den vanliga negativa prompten
photorealistic, blurry, low resolution, oversaturated, watermark, messy typography, distorted anatomy, overexposed highlights, bad hands, malformed hands
Referensinställningar
RTX 4060 Ti 16 GB, standard workflow, er_sde / simple, 30 steps: about 1.8 s per step, a finished image in under a minute, VRAM at roughly 50%.
Tips
- Danbooru-taggar är token-effektiva och ger modellen utrymme att vara kreativ; naturligt språk ger mer kontroll. Användare säger att hybrid-prompting ger bäst balans mellan promptförståelse och anime-estetik.
- Danbooru-taggar kommer från Danbooru, ett animebildforum som startade 2005 och vars sökbara tagsystem blev en av de mest omfattande bildtaxonomierna på internet; många anime-modeller tränades på Danbooru-tagade bilder, vilket är varför tag-prompting fungerar.
- Enkla JSON- eller YAML-strukturerade prompts fungerar eftersom Qwen-kodaren tolkar dem, men de fallerar snabbt när de blir komplexa och det finns inget som tyder på att de ger bättre bilder än naturligt språk eller taggar.
- Att byta sampler eller scheduler ändrar knappt genereringstiden, men med Anima kan det ändra utdata mycket; samma prompt och seed genom euler, euler-a, er-sde och dpmpp-sde-gpu ger fyra tydligt olika bilder.
- Lägre CFG än vad du skulle använda på andra anime-modeller. Vissa av dem gillar väldigt hög CFG; Anima gör inte det.
- Om du vill ha exakt kontroll, använd en modell som Flux.2. Anima är en fri-flödande anime-, illustrations- och konstmodell som tar en grov idé och tolkar den på många olika sätt.
- Räkna med att anime är starkast, sedan akvarell, skisser, 3D och oljestilar. En akvarellprompt plus en LoRA som Vector Paintings av Daalis driver stilen längre.
- Hugging Face-modellkortet har mer om taggordning, syntax och det naturliga språk-tillvägagångssättet.
Felsökning
Bilden ignorerar detaljerna i en lång prompt
Varför det händer
Mycket långa eller mycket restriktiva prompts försämrar Animas följsamhet och ibland dess kvalitet; modellen fungerar bäst med en lös guide.
Så löser du det
Kort prompten till två eller tre korta stycken, behåll den allmänna riktningen och släpp de finare detaljerna, och kör sedan några seeds.
Övermättade färger, hårda konturer, utbrända högdagrar
Varför det händer
CFG är för högt; över ungefär 10 bränner Anima ut sig.
Så löser du det
Sänk CFG till 4 till 5.
Oönskat vuxeninnehåll från en kort prompt
Varför det händer
Anima är ganska ocensurerad och fyller i vaga eller korta prompts, särskilt återanvända Danbooru-stil prompts, på egen hand.
Så löser du det
Lägg till safe eller sensitive i den positiva prompten, eller nsfw och explicit i den negativa prompten, och ge prompten mer detaljer.
Lemmar blir ihoptryckta med Turbo LoRA
Varför det händer
Den tidiga Turbo LoRA:n (8 till 12 steg) förkortar ibland lemlängder.
Så löser du det
Använd basmodellen på 30 till 40 steg för de bilderna, eller behåll Turbo bara för snabba utkast.
Text i bilden är oläslig
Varför det händer
Textåtergivningen är svag enligt dagens standard.
Så löser du det
Håll text på bilden till ett eller två ord eller lägg till text i efterredigering.
Frågor
Fungerar SDXL LoRAs med Anima?
Nej. Anima använder en annan arkitektur, så SDXL LoRAs är inte nativt kompatibla. Nya LoRAs tränade för Anima dyker upp hela tiden.
Stöder Anima JSON-prompting?
Inte nativt så vitt känt. Enkla JSON- eller YAML-prompts fungerar eftersom Qwen-textkodaren tolkar dem, men de fallerar snabbt när de blir komplexa och ger inte bättre bilder än naturligt språk eller taggar.
Hur snabbt är den?
På en RTX 4060 Ti 16 GB med standardarbetsflödet, er_sde / simple och 30 steg, ungefär 1,8 sekunder per steg och en färdig bild på under en minut, med ungefär halva VRAM-användningen. En LoRA lägger till några sekunder.
Kan jag använda den kommersiellt?
Animas licens är mer restriktiv än baslicensen för SDXL och riktad mot personliga hobbyprojekt. Läs licensen innan kommersiell användning.
Är den bara för anime?
Anime är där den är starkast, men med rätt prompt och taggar gör den också akvarell, skisser, 3D, olja och ganska abstrakta bilder, och LoRAs tar den till fler stilar.
Länkar och källor
- Anima: light, fast, slightly unruly, by Chris Green on Medium
- Diffusion Doodles, Chris Green's Substack (original publication)
Modeller i den här guiden
Skriven av
Bygger maskiner i ett garage som blir varmare än GPU:erna. Benchmarkar allt två gånger, en gång för vetenskapen och en gång för att första siffran var pinsam. Kör lokala modeller av princip och på en begagnad 3090. Tror att molnet är någons annans rigg med påslag.
Alla guider av Chris Green
Relaterade guider
ComfyUI-noder: dokumentation och felsökning
2 jun 2026

MiniMax H3 videopromptar: den officiella strukturen
14 sep 2026
Fler guider
Best AI Models for Anime in 2026: MOSS-Image, Anima, Illustrious
16 okt 2026
Modifierare för estetisk kvalitet - Masterpiece för Anima: få kvalitets-taggar att betyda något
1 okt 2026
Anime i verkligheten för Anima: animekaraktärer i realistiska bakgrunder
30 sep 2026
Stil > gpt-image-2 för Anima: förbättrare av detalj, ljussättning och textur
1 okt 2026
MOSS-Image: a 5B anime and illustration model with layout control
19 okt 2026