
Workflow ComfyUI LTX-2 da testo a video: immagine e suono da un solo prompt
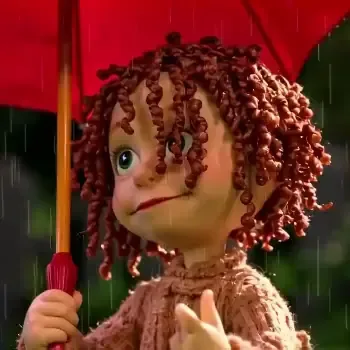
Panoramica
LTX-2 è il modello video open di Lightricks di gennaio 2026 e il primo che puoi far girare a casa che genera la colonna sonora insieme all'immagine: passi, pioggia, una voce che canta, dialoghi sincronizzati con le labbra nella lingua che scrivi. Il template ComfyUI tiene tutto in un solo grafo: il testo passa attraverso il codificatore Gemma 3, i latenti video e audio si generano insieme (LTXVConcatAVLatent), si separano, si decodificano con il VAE video e il VAE audio, e si muxano in un mp4 con Create Video e Save Video.
Il template rende in due passaggi: una base a 768x512 (97 frame, 20 step con LTXVScheduler e cfg 4), poi un upscaling latente 2x e un breve passaggio di rifinitura con il LoRA distillato a cfg 1. Larghezza e altezza devono essere divisibili per 64 e il numero di frame deve essere un multiplo di 8 più 1; valori sbagliati non danno errore, il grafo sceglie silenziosamente quelli validi più vicini. Il checkpoint 19B fp8 richiede una scheda da 24 GB; le note dicono di provare 1920x1088 solo su GPU potenti.
Ospitato su ModelTrends.ai: il template video_ltx2_t2v.json, senza modifiche.
Immagini e clip
The ComfyUI team's launch clip for this model
LTX-2 text to video ComfyUI workflow: the workflow as it opens in ComfyUI
Riferimento
Nome | Tipo | Cos'è |
|---|---|---|
ltx-2-19b-dev-fp8.safetensors | models/checkpoints | Il modello LTX-2 19B con i suoi VAE video e audio, fp8. Lightricks/LTX-2 su Hugging Face. Nota: checkpoint, non diffusion_models. |
gemma_3_12B_it_fp4_mixed.safetensors | models/text_encoders | Il codificatore testuale Gemma 3 12B in fp4 misto. Comfy-Org/ltx-2, split_files/text_encoders. |
ltx-2-spatial-upscaler-x2-1.0.safetensors | models/latent_upscale_models | |
ltx-2-19b-distilled-lora-384.safetensors | models/loras | |
ltx-2-19b-lora-camera-control-dolly-left.safetensors | models/loras | |
Dimensione e durata | 768x512, 97 frames, 25 fps | |
euler_ancestral. Due nodi RandomNoise con seed fissi 0 e 10. |
Dove vanno i file
Metti ogni download in questa cartella della tua installazione ComfyUI. Un nodo loader elenca solo i file che stanno nella cartella che legge, quindi un modello nella cartella sbagliata risulterà mancante.
ComfyUI/├── models/│ ├── checkpoints/│ │ └── ltx-2-19b-dev-fp8.safetensors│ ├── text_encoders/│ │ └── gemma_3_12B_it_fp4_mixed.safetensors│ ├── latent_upscale_models/│ │ └── ltx-2-spatial-upscaler-x2-1.0.safetensors│ └── loras/│ ├── ltx-2-19b-distilled-lora-384.safetensors│ └── ltx-2-19b-lora-camera-control-dolly-left.safetensors
Passo dopo passo
- Aggiorna ComfyUI (Desktop: Aiuto > Controlla aggiornamenti; portable: esegui update_comfyui.bat). Questi workflow richiedono una build 2025 o più recente.
- Scarica il file del workflow qui sotto e trascinalo sulla tela di ComfyUI, oppure usa Workflow > Apri. I nodi appaiono con i nomi dei file già compilati.
- Scarica tutti i file nella tabella e mettili nella cartella indicata. Se un widget modello ha un bordo rosso, il nome non corrisponde a un file in quella cartella: cliccaci e scegli il file scaricato. Il checkpoint LTX-2 va in models/checkpoints.
- Scrivi il prompt in tre parti, come suggerisce la nota del template: l'azione nel tempo, i dettagli visivi, poi i suoni e qualsiasi frase detta tra virgolette.
- Mantieni 768x512 e 97 frame; assicurati che il frame rate sia uguale in entrambe le caselle (la nota lo indica).
- Premi Run (Ctrl+Enter). La prima esecuzione carica i modelli e dura di più; le successive li riutilizzano. Ci vogliono diversi minuti su una scheda da 24 GB per i due passaggi.
- L'mp4 con audio si trova in ComfyUI/output/video/LTX-2.
Esempi
Prompt del template (versione breve)
A close-up of a cheerful girl puppet with curly auburn yarn hair and wide button eyes, holding a small red umbrella above her head. Rain falls gently around her. She looks upward and begins to sing with joy in English: "It's raining, it's raining, I love it when it's raining"
Consigli
- Dialogo: metti le parole tra virgolette e indica la lingua: she says in English: "We should go now."
- Descrivi il suono della stanza ("pioggia su un tetto di lamiera, tuoni lontani") o il clip avrà un'atmosfera generica.
- Il LoRA della camera è disattivato di default; Ctrl+B sul suo loader lo attiva con forza 1. Usa un solo LoRA camera alla volta.
- Il template distillato (video_ltx2_t2v_distilled nello stesso repository) è la versione veloce di bozza con gli stessi modelli.
Risoluzione dei problemi
Nodi rossi dopo aver caricato il workflow
Perché succede
La tua versione di ComfyUI è più vecchia dei nodi usati dal template.
Come risolverlo
Aggiorna prima ComfyUI; questi template usano solo nodi integrati, quindi non serve un pacchetto nodi personalizzati a meno che la guida non lo dica.
"Value not in list" su un widget modello
Perché succede
Il file manca o si trova nella cartella sbagliata.
Come risolverlo
Controlla la tabella: i modelli diffusion vanno in models/diffusion_models, i codificatori testuali in models/text_encoders, i VAE in models/vae, i LoRA in models/loras. Premi R per aggiornare le liste.
CUDA out of memory
Perché succede
Il modello più il latente non entra nella scheda.
Come risolverlo
Il video ha dimensioni o durata diverse da quelle impostate
Perché succede
Larghezza o altezza non divisibili per 64, o frame non 8n+1.
Come risolverlo
Usa 768x512, 1024x576, 1280x704; frame 65, 97, 121. Altrimenti il grafo arrotonda silenziosamente.
Nessun suono nell'mp4
Perché succede
Il percorso di decodifica audio è bypassato o il lettore ignora la traccia.
Come risolverlo
Controlla che il nodo LTXVAudioVAEDecode sia attivo e riproduci il file con VLC.
Domande
Quale scheda?
24 GB per il checkpoint 19B fp8 a 768x512; 32 GB per 1920x1088. Schede da 16 GB dovrebbero aspettare build GGUF o usare il cloud.
Fa davvero il parlato?
Sì, con sincronizzazione labiale, in diverse lingue. Scrivi la frase tra virgolette e indica chi parla.
Che succede con LTX-2.3 e 2.5?
Le versioni più recenti di LTX-2 usano lo stesso schema di grafo con file diversi; la libreria template li ha. Questa pagina copre la versione originale LTX-2 annunciata nel post del blog.
Link e fonti
Modelli di questa guida
Scritto da
Comanda questa nave. Ha opinioni sui tempi di decodifica VAE che nessuno ha chiesto. Crede che i pesi vogliano essere liberi e che ogni modello che non puoi scaricare sia un abbonamento con passaggi extra. Non risponderà a domande sui 400 GB di checkpoint sul NAS.
Tutte le guide di Captain
Guide correlate
Flusso di lavoro ComfyUI LTX-2 da immagine a video: anima un fermo immagine con audio sincronizzato
9 Ott 2026
Wan 2.2 14B testo a video ComfyUI workflow: due modelli, un LoRA a 4 step, movimento da cinema
9 Ott 2026

Quanta VRAM serve per i video AI? Wan 2.2, HunyuanVideo 1.5 e LTX-2 in base alla dimensione GPU (2026)
6 Ott 2026
Altre guide

I migliori modelli video AI open-source nel 2026: cosa puoi davvero scaricare
14 Ott 2026
ComfyUI vs Forge (2026): quale interfaccia Stable Diffusion dovresti usare?
14 Ott 2026

Flusso di lavoro Wan 2.2 5B ComfyUI: testo o immagine 720p in video su una scheda di fascia media
9 Ott 2026

Wan 2.1 testo a video (1.3B) workflow ComfyUI: il tuo primo video locale su una scheda da 8 GB
9 Ott 2026

Flusso di lavoro ComfyUI HunyuanVideo text to video: il modello 13B che ha avviato il video locale
9 Ott 2026