
Flusso di lavoro ComfyUI LTX-2 da immagine a video: anima un fermo immagine con audio sincronizzato
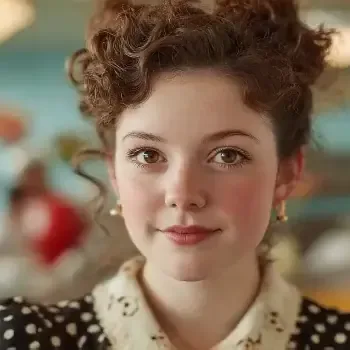
Panoramica
Dai a LTX-2 un'immagine e ti restituisce un clip che parte da quel fotogramma e ha il suono giusto: la cameriera nell'esempio del diner del template dice la sua battuta con il rumore di piatti dietro di lei. Il grafo è il template text-to-video più Load Image, un nodo di ridimensionamento che porta l'immagine a una dimensione valida, LTXVPreprocess e due nodi LTXVImgToVideoInplace (uno per passaggio) che scrivono il fotogramma nel latente.
Il template rende in due passaggi: un passaggio base a 768x512 (97 fotogrammi, 20 step con LTXVScheduler e cfg 4), poi un upscale latente 2x e un breve passaggio di rifinitura con il LoRA distillato a cfg 1. Larghezza e altezza devono essere divisibili per 64 e il numero di fotogrammi deve essere un multiplo di 8 più 1; valori sbagliati non danno errore, il grafo sceglie silenziosamente quelli validi più vicini. Il checkpoint 19B fp8 richiede una scheda da 24 GB; le note dicono di provare 1920x1088 solo su GPU potenti.
Ospitato su ModelTrends.ai: il template video_ltx2_i2v.json, senza modifiche.
Immagini e clip
The ComfyUI team's launch clip for this model
LTX-2 image to video ComfyUI workflow: the workflow as it opens in ComfyUI
Riferimento
Nome | Tipo | Cos'è |
|---|---|---|
ltx-2-19b-dev-fp8.safetensors | models/checkpoints | Il modello LTX-2 19B con il suo video e audio VAE, fp8. Lightricks/LTX-2 su Hugging Face. Nota: checkpoint, non diffusion_models. |
gemma_3_12B_it_fp4_mixed.safetensors | models/text_encoders | L'encoder testuale Gemma 3 12B in mixed fp4. Comfy-Org/ltx-2, split_files/text_encoders. |
ltx-2-spatial-upscaler-x2-1.0.safetensors | models/latent_upscale_models | |
ltx-2-19b-distilled-lora-384.safetensors | models/loras | |
ltx-2-19b-lora-camera-control-dolly-left.safetensors | models/loras | |
Load Image | your picture | Il primo fotogramma. Viene ridimensionato alla dimensione di lavoro (768x512 di default), quindi scegli l'orientamento giusto. |
Size and length | 768x512, 97 frames, 25 fps | Divisibile per 64; fotogrammi 8n+1. Upscale 2x nel secondo passaggio. |
euler e gradient_estimation; semi fissi 0 e 10. |
Dove vanno i file
Metti ogni download in questa cartella della tua installazione ComfyUI. Un nodo loader elenca solo i file che stanno nella cartella che legge, quindi un modello nella cartella sbagliata risulterà mancante.
ComfyUI/├── models/│ ├── checkpoints/│ │ └── ltx-2-19b-dev-fp8.safetensors│ ├── text_encoders/│ │ └── gemma_3_12B_it_fp4_mixed.safetensors│ ├── latent_upscale_models/│ │ └── ltx-2-spatial-upscaler-x2-1.0.safetensors│ └── loras/│ ├── ltx-2-19b-distilled-lora-384.safetensors│ └── ltx-2-19b-lora-camera-control-dolly-left.safetensors
Passo dopo passo
- Aggiorna ComfyUI (Desktop: Aiuto > Controlla aggiornamenti; portable: esegui update_comfyui.bat). Questi flussi richiedono una build 2025 o più recente.
- Scarica il file del flusso di lavoro qui sotto e trascinalo sulla tela di ComfyUI, oppure usa Workflow > Open. I nodi appaiono con i nomi dei file già compilati.
- Scarica tutti i file della tabella e mettili nella cartella indicata. Se un widget modello ha un bordo rosso, il nome non corrisponde a un file in quella cartella: cliccaci e scegli il file scaricato. Il checkpoint LTX-2 va in models/checkpoints.
- Carica l'immagine. Imposta la dimensione di lavoro in base all'orientamento (768x512 orizzontale, 512x768 verticale).
- Descrivi il movimento, poi il suono. Non descrivere ciò che è già nell'immagine.
- Premi Run (Ctrl+Enter). La prima esecuzione carica i modelli e dura di più; le successive li riutilizzano. Ci vogliono diversi minuti su una scheda da 24 GB.
- L'mp4 con audio si trova in ComfyUI/output/video/LTX_2.0_i2v.
Esempi
Prompt del template (versione breve)
A close-up shot of a young waitress in a retro 1950s diner, her warm brown eyes meeting the camera with a gentle smile. She wears a black polka-dot dress with an elegant cream lace collar, her reddish-brown hair styled in an elaborate updo with delicate curls
Consigli
- Una battuta parlata tra virgolette dà il lip sync; il volto nell'immagine dovrebbe essere abbastanza grande nel fotogramma.
- Mantieni l'illuminazione del primo fotogramma nel prompt ("luce calda da diner") così i fotogrammi successivi non cambiano troppo.
- Per un prodotto o un paesaggio, "la camera si avvicina lentamente" più una descrizione del suono ambientale è una ricetta sicura.
- Il LoRA per il controllo della camera è disattivato di default; attivalo con Ctrl+B quando vuoi un movimento definito.
Risoluzione dei problemi
Nodi rossi dopo aver caricato il flusso di lavoro
Perché succede
La tua versione di ComfyUI è più vecchia dei nodi usati dal template.
Come risolverlo
Aggiorna prima ComfyUI; questi template usano solo nodi integrati, quindi non serve un pacchetto nodi personalizzato a meno che la guida non lo dica.
"Value not in list" su un widget modello
Perché succede
Il file manca o è nella cartella sbagliata.
Come risolverlo
Controlla la tabella: i diffusion models vanno in models/diffusion_models, gli encoder testuali in models/text_encoders, i VAE in models/vae, i LoRA in models/loras. Premi R per aggiornare le liste.
CUDA out of memory
Perché succede
Il modello più il latente non entrano nella scheda.
Come risolverlo
Il primo fotogramma è diverso dalla mia immagine
Perché succede
L'immagine è stata ridimensionata a un rapporto d'aspetto diverso.
Come risolverlo
Adatta la dimensione di lavoro all'orientamento dell'immagine; ritaglia l'immagine a 3:2 o 2:3 prima.
Domande
Quale scheda?
24 GB per il checkpoint 19B fp8 a 768x512.
Può continuare un clip?
Sì: usa l'ultimo fotogramma dell'output come prossimo Load Image, mantieni il prompt coerente.
Esiste una versione più veloce?
video_ltx2_i2v_distilled nella libreria template salta il passaggio base con gli stessi modelli.
Link e fonti
Modelli di questa guida
Scritto da
Comanda questa nave. Ha opinioni sui tempi di decodifica VAE che nessuno ha chiesto. Crede che i pesi vogliano essere liberi e che ogni modello che non puoi scaricare sia un abbonamento con passaggi extra. Non risponderà a domande sui 400 GB di checkpoint sul NAS.
Tutte le guide di Captain
Guide correlate
Workflow ComfyUI LTX-2 da testo a video: immagine e suono da un solo prompt
9 Ott 2026
Wan 2.2 14B immagine a video workflow ComfyUI: il miglior grafo open photo-to-clip
9 Ott 2026

Quanta VRAM serve per i video AI? Wan 2.2, HunyuanVideo 1.5 e LTX-2 in base alla dimensione GPU (2026)
6 Ott 2026
Altre guide

Wan 2.1 da immagine a video (480p, 14B) flusso di lavoro ComfyUI: anima una foto
9 Ott 2026

Flusso di lavoro Wan 2.2 5B ComfyUI: testo o immagine 720p in video su una scheda di fascia media
9 Ott 2026
Wan 2.2 Animate ComfyUI workflow: sostituzione del personaggio e trasferimento della posa da un video
9 Ott 2026
FLUX.2 [klein] 4B testo in immagine workflow ComfyUI: immagini in meno di un secondo su una scheda da 8 GB
9 Ott 2026
Qwen Image Edit 2509 ComfyUI workflow: modifica foto con una frase, fino a tre immagini di riferimento
9 Ott 2026