
Wan 2.2 14B immagine a video workflow ComfyUI: il miglior grafo open photo-to-clip
Panoramica
Questo è il grafo da cui proviene la maggior parte dei clip Wan 2.2 su internet. Gli dai un’immagine e una frase; il modello 14B ad alto rumore decide il movimento nei primi step e quello a basso rumore completa i dettagli negli ultimi. Il template racchiude tutto in un subgraph così la canvas mostra solo Load Image, il prompt, la dimensione e Save Video.
Il template è costruito come un subgraph: i loader, i due sampler e gli switch LoRA stanno dentro un nodo, e la canvas esterna mostra solo il prompt, la dimensione, l’immagine (per immagine a video) e Save Video. Apri il subgraph (icona sul nodo) per vedere i due nodi KSamplerAdvanced: il modello ad alto rumore rende i passi da 0 a 2, quello a basso rumore da 2 a 4 quando il LoRA a 4 step è attivo. Il team ha misurato 640x640 a 81 frame su una RTX 4090 D: circa nove minuti senza LoRA, meno di due con.
Ospitato su ModelTrends.ai: il template video_wan2_2_14B_i2v.json, senza modifiche.
Immagini e clip
Wan 2.2 14B image to video ComfyUI workflow: the template's output clip
The ComfyUI team's launch clip for this model
Wan 2.2 14B image to video ComfyUI workflow: the workflow as it opens in ComfyUI
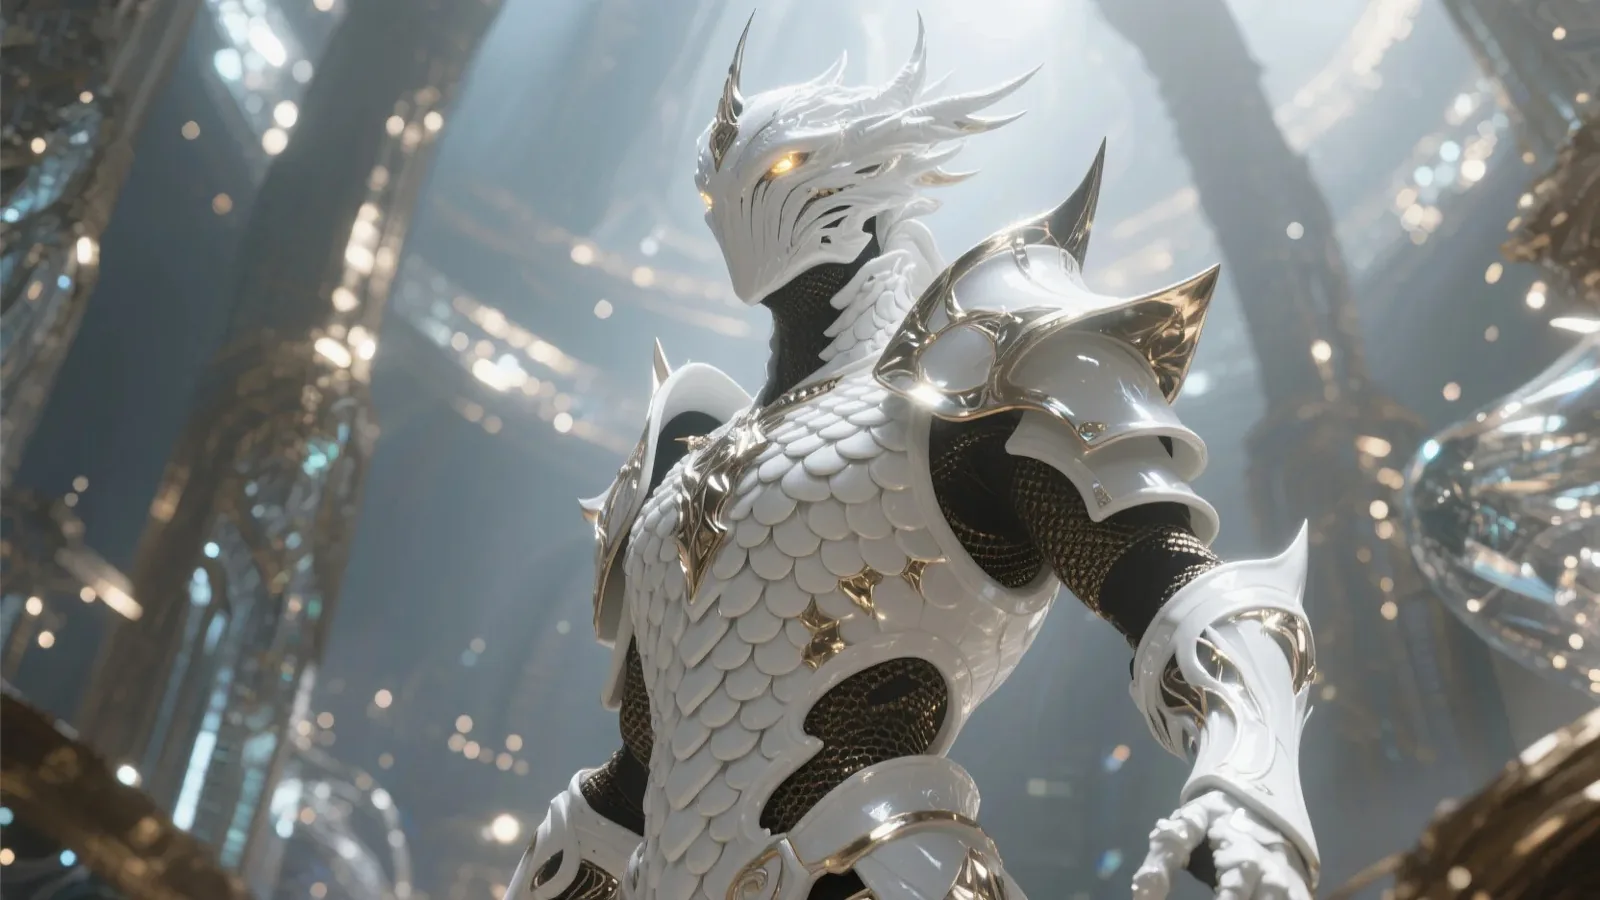
Wan 2.2 14B image to video ComfyUI workflow: the template's input picture
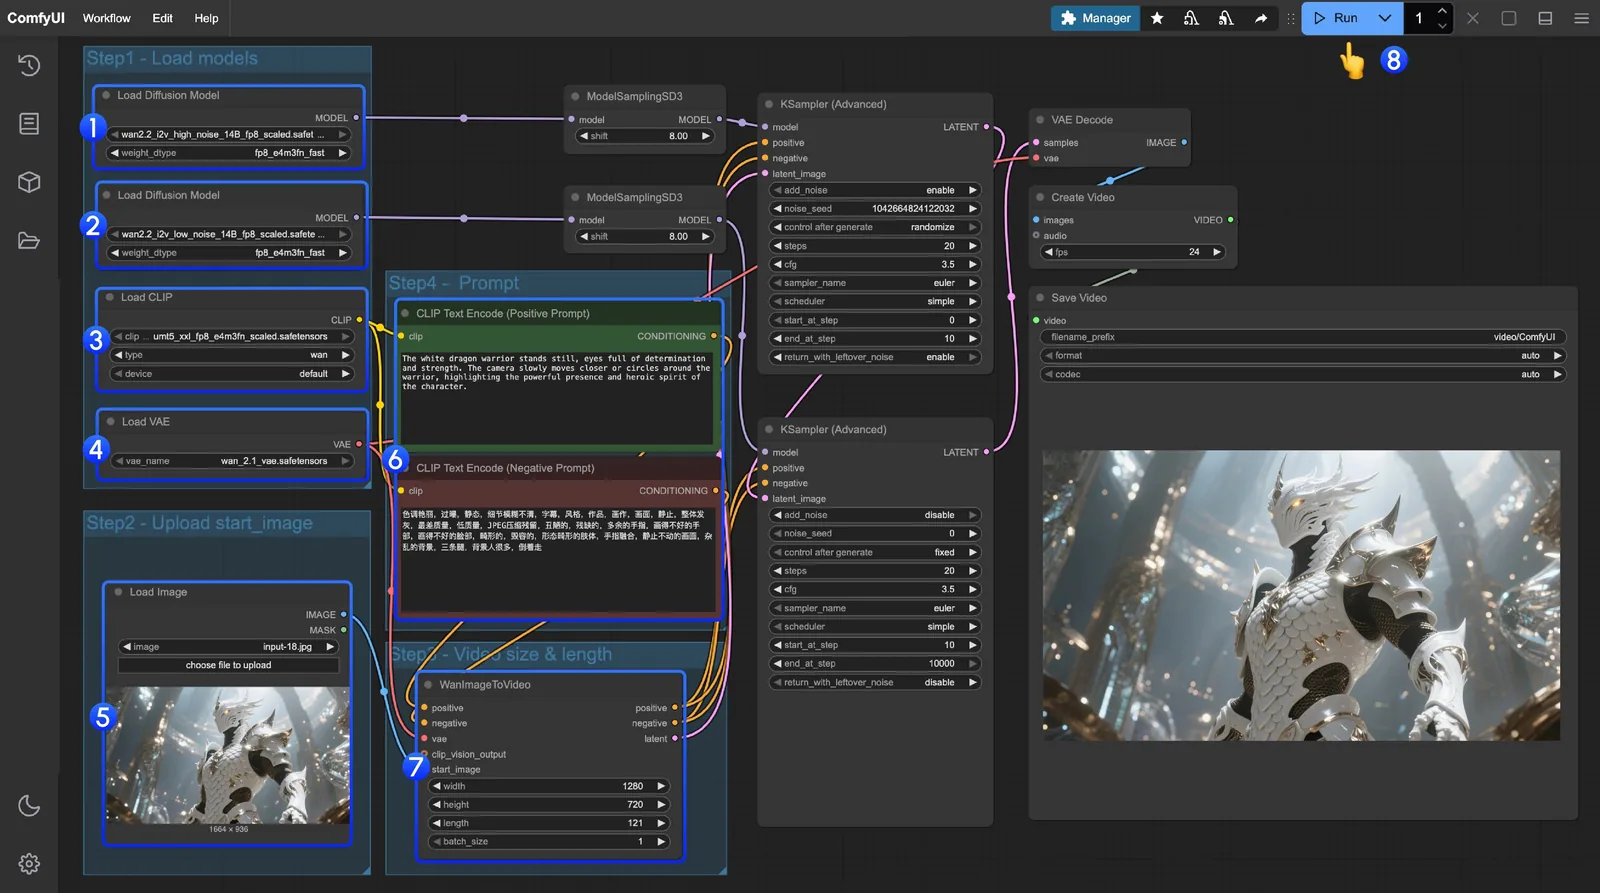
Wan 2.2 14B image to video ComfyUI workflow: the nodes to check, step by step
Riferimento
Nome | Tipo | Cos'è |
|---|---|---|
wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors | models/diffusion_models | |
wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors | models/diffusion_models | |
wan2.2_i2v_lightx2v_4steps_lora_v1_high_noise.safetensors | models/loras | |
wan2.2_i2v_lightx2v_4steps_lora_v1_low_noise.safetensors | models/loras | |
umt5_xxl_fp8_e4m3fn_scaled.safetensors | models/text_encoders | L’encoder testuale Wan, usato in tutti i workflow Wan 2.1 e 2.2. Da Comfy-Org/Wan_2.1_ComfyUI_repackaged su Hugging Face. |
wan_2.1_vae.safetensors | models/vae | |
Load Image | your picture | Il primo frame. Imposta larghezza e altezza secondo l’orientamento dell’immagine. |
WanImageToVideo | 640x640, 81 frames | Cinque secondi a 16 fps. |
Dove vanno i file
Metti ogni download in questa cartella della tua installazione ComfyUI. Un nodo loader elenca solo i file che stanno nella cartella che legge, quindi un modello nella cartella sbagliata risulterà mancante.
ComfyUI/├───📂 models/│ ├───📂 diffusion_models/│ │ ├─── wan2.2_i2v_low_noise_14B_fp16.safetensors│ │ └─── wan2.2_i2v_high_noise_14B_fp16.safetensors│ ├───📂 text_encoders/│ │ └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors│ └───📂 vae/│ └── wan_2.1_vae.safetensors
Passo dopo passo
- Aggiorna ComfyUI (Desktop: Aiuto > Controlla aggiornamenti; portable: esegui update_comfyui.bat). Questi workflow richiedono una build 2025 o più recente.
- Scarica il file workflow qui sotto e trascinalo sulla canvas di ComfyUI, oppure usa Workflow > Open. I nodi appariranno con i nomi file già compilati.
- Scarica tutti i file nella tabella e mettili nella cartella indicata. Se un widget modello ha un bordo rosso, il nome non corrisponde a un file in quella cartella: cliccaci e scegli il file scaricato.
- Carica la tua immagine. Imposta larghezza e altezza secondo l’orientamento (832x480 orizzontale, 480x832 verticale); il default del template è quadrato.
- Descrivi solo il movimento e la camera; l’immagine già dice cosa c’è nella scena.
- Premi Run (Ctrl+Enter). La prima esecuzione carica i modelli e dura di più; le successive li riutilizzano. Meno di due minuti con LoRA su una scheda da 24 GB, circa nove senza.
- Trova l’mp4 in ComfyUI/output/video/Wan2.2_i2v.
Esempi
Il prompt del template
The white dragon warrior stands still, eyes full of determination and strength. The camera slowly moves closer or circles around the warrior, highlighting the powerful presence and heroic spirit of the character.
Consigli
- Wan 2.2 non usa CLIP Vision per l’immagine (a differenza della 2.1); il VAE codifica direttamente il frame, per questo la somiglianza è così stabile.
- Chiedi prima della camera quando il soggetto deve restare fermo: "la camera gira lentamente intorno al guerriero" mantiene la posa e aggiunge un tocco cinematografico.
- Per uno scatto prodotto, "l’oggetto ruota lentamente sul suo asse, illuminazione da studio" funziona bene.
- Il template primo-ultimo frame (video_wan2_2_14B_flf2v) nello stesso repository usa gli stessi modelli se ti serve un frame finale definito.
Risoluzione dei problemi
Nodi rossi dopo aver caricato il workflow
Perché succede
La tua versione di ComfyUI è più vecchia dei nodi usati dal template.
Come risolverlo
Aggiorna prima ComfyUI; questi template usano solo nodi integrati, quindi non serve un pacchetto nodi custom a meno che la guida non dica il contrario.
"Value not in list" su un widget modello
Perché succede
Il file manca o è nella cartella sbagliata.
Come risolverlo
Controlla la tabella: i modelli diffusion vanno in models/diffusion_models, gli encoder testuali in models/text_encoders, i VAE in models/vae, i LoRA in models/loras. Premi R per aggiornare le liste.
CUDA out of memory
Perché succede
Il modello più il latente non entra nella scheda.
Come risolverlo
Il soggetto è tagliato o schiacciato
Perché succede
La dimensione di lavoro non corrisponde al rapporto d’aspetto dell’immagine.
Come risolverlo
Imposta larghezza e altezza secondo l’orientamento dell’immagine; multipli di 16.
Domande
Quale scheda?
24 GB per la coppia fp8 a 640x640 e 81 frame; 16 GB con i modelli GGUF Q4 o a 480p e 49 frame.
Perché non c’è il nodo CLIP Vision?
Wan 2.2 si basa sul primo frame codificato dal VAE; il grafo 2.1 usava clip_vision_h, questo no.
Posso estendere un clip?
Prendi l’ultimo frame dell’output (Image From Batch, indice -1) come prossimo Load Image e rilancia; il template Animate su questo sito fa così in loop.
Link e fonti
Modelli di questa guida
Scritto da
Comanda questa nave. Ha opinioni sui tempi di decodifica VAE che nessuno ha chiesto. Crede che i pesi vogliano essere liberi e che ogni modello che non puoi scaricare sia un abbonamento con passaggi extra. Non risponderà a domande sui 400 GB di checkpoint sul NAS.
Tutte le guide di Captain
Guide correlate
Wan 2.2 14B testo a video ComfyUI workflow: due modelli, un LoRA a 4 step, movimento da cinema
9 Ott 2026

Flusso di lavoro Wan 2.2 5B ComfyUI: testo o immagine 720p in video su una scheda di fascia media
9 Ott 2026

Wan 2.1 da immagine a video (480p, 14B) flusso di lavoro ComfyUI: anima una foto
9 Ott 2026

Quanta VRAM serve per i video AI? Wan 2.2, HunyuanVideo 1.5 e LTX-2 in base alla dimensione GPU (2026)
6 Ott 2026
Altre guide
Wan 2.2 Animate ComfyUI workflow: sostituzione del personaggio e trasferimento della posa da un video
9 Ott 2026
Wan 2.1 testo a video (1.3B) workflow ComfyUI: il tuo primo video locale su una scheda da 8 GB
9 Ott 2026

HunyuanVideo 1.5 vs Wan 2.2: quale modello video open usare nel 2026
4 Ott 2026
Cos'è ComfyUI? Una guida per principianti ai nodi, ai flussi di lavoro e al primo grafo
17 Dic 2025

Wan 2.2 video: configurazione, impostazioni e LoRA per text-to-video e image-to-video
24 Mag 2026