
Wan 2.1 da immagine a video (480p, 14B) flusso di lavoro ComfyUI: anima una foto

Panoramica
Da immagine a video è dove Wan 2.1 ha fatto il suo nome: gli dai una foto e una frase su cosa si muove, e ti restituisce un clip che mantiene il volto, i vestiti e lo sfondo. Questo è il flusso di lavoro 480p del team ComfyUI. Rispetto al grafo testo-a-video aggiunge Carica Immagine, un caricatore e codificatore CLIP Vision che legge la foto, e il nodo WanImageToVideo che trasforma immagine più prompt nel latente iniziale.
Il modello 14B è quello vero; il file bf16 pesa circa 32 GB e il file fp8 circa 16 GB, quindi la maggior parte usa fp8 su una scheda da 16 GB o 24 GB e lascia che ComfyUI scarichi il resto sulla RAM di sistema. 512x512 a 33 frame è il default del template; 480p indica il lato corto, quindi 832x480 in orizzontale funziona allo stesso modo. Il modello e flusso di lavoro sorella a 720p esistono nello stesso repository per schede da 24 GB.
Ospitato su ModelTrends.ai: il file immutato image_to_video_wan_480p_example.json da Comfy-Org.
Immagini e clip
Wan 2.1 image to video (480p, 14B) ComfyUI workflow: the workflow as it opens in ComfyUI
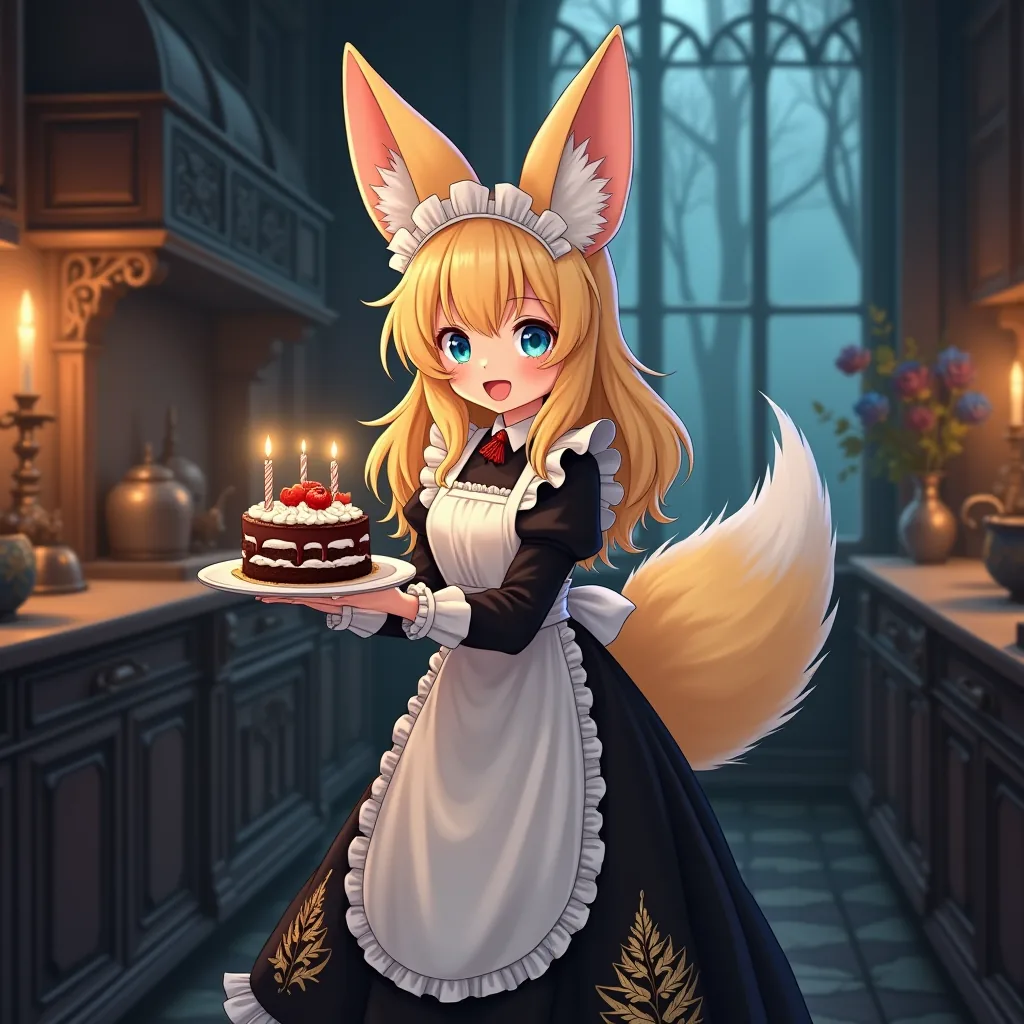
Wan 2.1 image to video (480p, 14B) ComfyUI workflow: the template's input picture
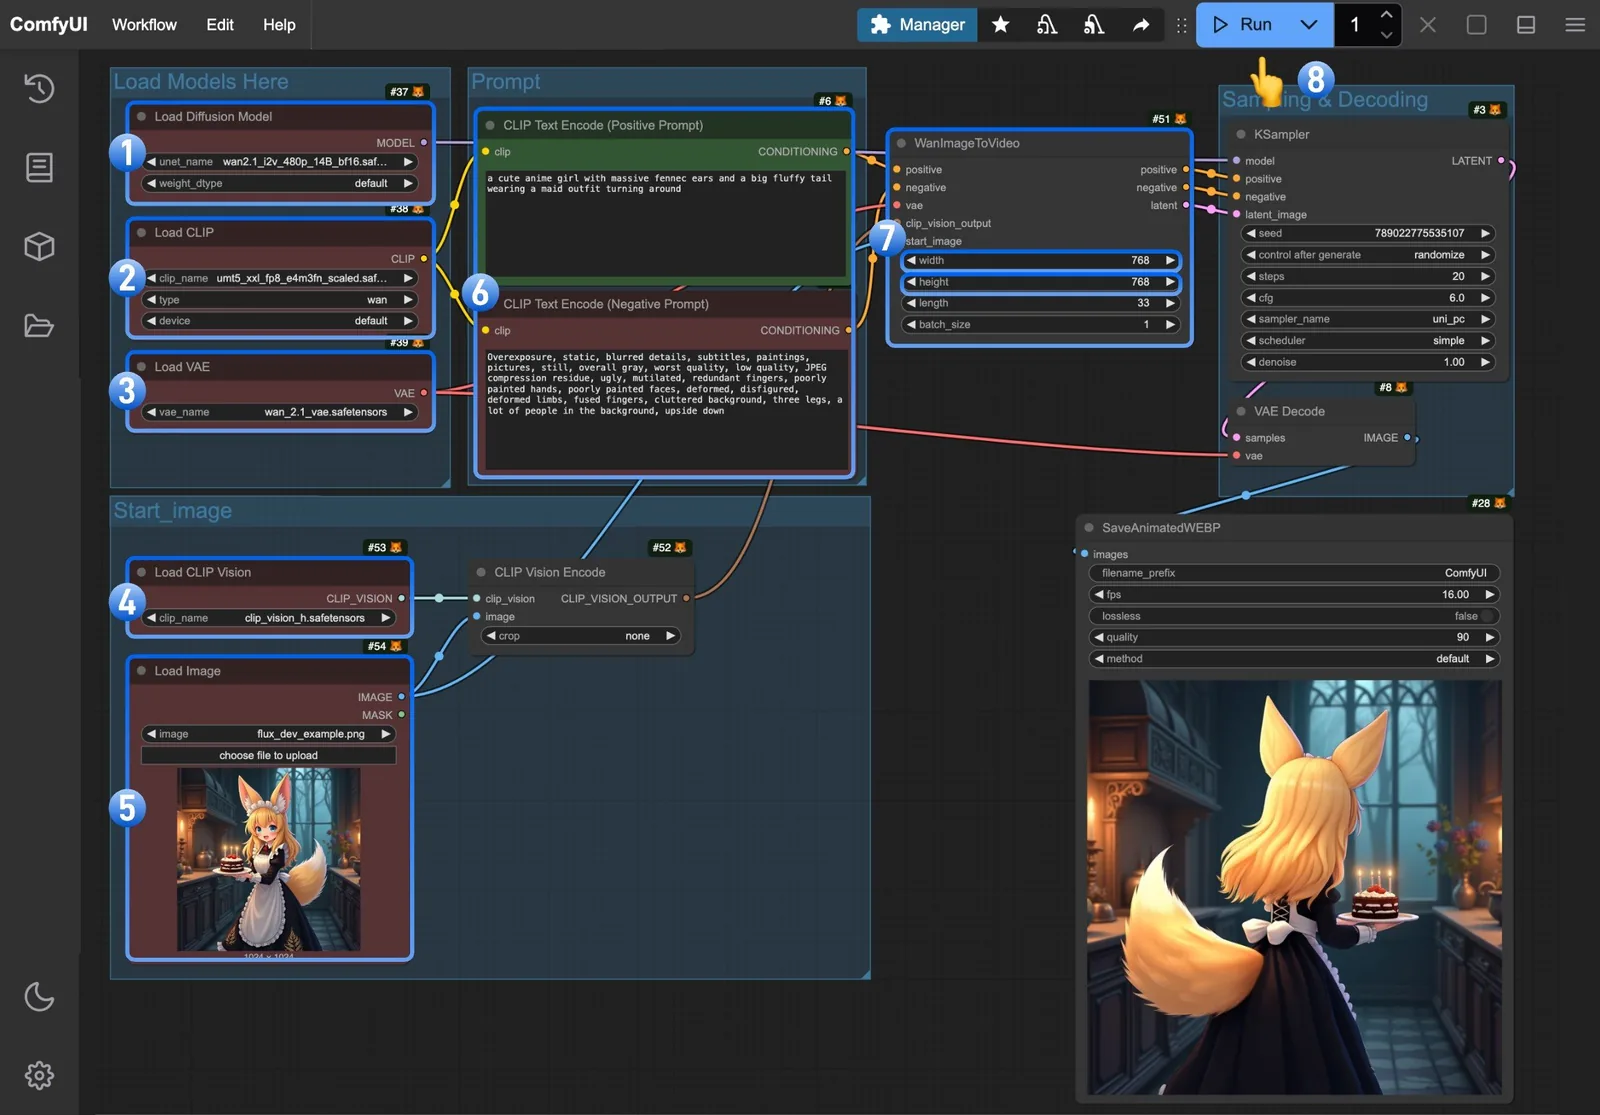
Wan 2.1 image to video (480p, 14B) ComfyUI workflow: the nodes to check, step by step
Riferimento
Nome | Tipo | Cos'è |
|---|---|---|
wan2.1_i2v_480p_14B_bf16.safetensors | models/diffusion_models | Il modello da immagine a video 480p. La versione fp8_e4m3fn nella stessa cartella è la metà di dimensione ed è quella che serve alla maggior parte delle schede. |
umt5_xxl_fp8_e4m3fn_scaled.safetensors | models/text_encoders | Il codificatore testuale Wan, usato da ogni flusso Wan 2.1 e 2.2. Da Comfy-Org/Wan_2.1_ComfyUI_repackaged su Hugging Face. |
wan_2.1_vae.safetensors | models/vae | |
clip_vision_h.safetensors | models/clip_vision | Legge l'immagine iniziale per da immagine a video. Comfy-Org/Wan_2.1_ComfyUI_repackaged. |
Load Image | your picture | Qualsiasi JPG o PNG. L'output mantiene il rapporto d'aspetto; larghezza e altezza in WanImageToVideo impostano la dimensione di lavoro. |
WanImageToVideo | 512x512, 33 frames | Dimensione e numero di frame. Multipli di 16. |
KSampler | I default del template. |
Dove vanno i file
Metti ogni download in questa cartella della tua installazione ComfyUI. Un nodo loader elenca solo i file che stanno nella cartella che legge, quindi un modello nella cartella sbagliata risulterà mancante.
ComfyUI/├── models/│ ├── diffusion_models/│ │ └── wan2.1_i2v_480p_14B_bf16.safetensors│ ├── text_encoders/│ │ └── umt5_xxl_fp8_e4m3fn_scaled.safetensors│ ├── vae/│ │ └── wan_2.1_vae.safetensors│ └── clip_vision/│ └── clip_vision_h.safetensors
Passo dopo passo
- Aggiorna ComfyUI (Desktop: Aiuto > Controlla aggiornamenti; portatile: esegui update_comfyui.bat). Questi flussi richiedono una build 2025 o più recente.
- Scarica il file del flusso qui sotto e trascinalo sulla tela di ComfyUI, oppure usa Workflow > Apri. I nodi appaiono con i nomi dei file già compilati.
- Scarica ogni file nella tabella e mettilo nella cartella indicata. Se un widget modello mostra un bordo rosso, il nome non corrisponde a un file in quella cartella: cliccaci e scegli il file scaricato.
- Clicca su Load Image e scegli la tua foto. Ritratti e soggetti singoli su sfondo calmo si animano meglio.
- Scrivi cosa deve muoversi nel prompt positivo: l'azione del soggetto, poi la camera. Non descrivere cosa c'è già nella foto.
- Premi Run (Ctrl+Enter). La prima esecuzione carica i modelli e dura di più; le successive li riutilizzano. Con fp8 su una scheda da 16 GB aspettati da cinque a dieci minuti per 33 frame.
- Entrambi gli output (anteprima WebP, file WebM) vengono scritti in ComfyUI/output.
Esempi
Il prompt del template
a cute anime girl with massive fennec ears and a big fluffy tail wearing a maid outfit turning around
Una foto ritratto
She looks up from the book and smiles at the camera, soft wind in her hair, the camera slowly pushes in
Consigli
- Imposta il lato più lungo di WanImageToVideo per corrispondere all'orientamento della tua foto (832x480 per orizzontale, 480x832 per verticale) altrimenti il soggetto viene tagliato.
- Piccoli movimenti funzionano: una rotazione della testa, capelli al vento, uno zoom lento. Cambiamenti grandi (la persona esce dall'inquadratura) rompono la somiglianza.
- Se il clip ignora la tua foto, controlla che CLIP Vision Encode sia collegato da Load Image e che clip_vision_h.safetensors sia caricato.
- Usa lo stesso seed (imposta control_after_generate su fixed) mentre affini il prompt, poi randomizza.
Risoluzione dei problemi
Nodi rossi dopo aver caricato il flusso di lavoro
Perché succede
La tua versione di ComfyUI è più vecchia dei nodi usati dal template.
Come risolverlo
Aggiorna prima ComfyUI; questi template usano solo nodi integrati, quindi non serve un pacchetto nodi personalizzato a meno che la guida non lo dica.
"Valore non nella lista" su un widget modello
Perché succede
Il file manca o è nella cartella sbagliata.
Come risolverlo
Controlla la tabella: i modelli diffusion vanno in models/diffusion_models, i codificatori testuali in models/text_encoders, i VAE in models/vae, le LoRA in models/loras. Premi R per aggiornare le liste.
CUDA out of memory
Perché succede
Il modello più il latente non entrano nella scheda.
Come risolverlo
Il volto cambia dopo pochi frame
Perché succede
Hai chiesto troppo movimento, o la dimensione di lavoro è molto diversa dal rapporto d'aspetto della foto.
Come risolverlo
Chiedi un movimento piccolo, abbina il rapporto d'aspetto e mantieni 33 frame.
Domande
Quale scheda serve?
Una scheda da 16 GB con il modello fp8 a 512x512 e 33 frame; 24 GB è comodo. 12 GB funziona con offloading ma è lento.
Dov'è la versione 720p?
Stesso repository: wan2.1_i2v_720p_14B e il flusso image_to_video_wan_720p_example.json. Serve 24 GB.
Fa anche audio?
Link e fonti
Modelli di questa guida
Scritto da
Comanda questa nave. Ha opinioni sui tempi di decodifica VAE che nessuno ha chiesto. Crede che i pesi vogliano essere liberi e che ogni modello che non puoi scaricare sia un abbonamento con passaggi extra. Non risponderà a domande sui 400 GB di checkpoint sul NAS.
Tutte le guide di Captain
Guide correlate
Wan 2.1 testo a video (1.3B) workflow ComfyUI: il tuo primo video locale su una scheda da 8 GB
9 Ott 2026
Wan 2.2 14B immagine a video workflow ComfyUI: il miglior grafo open photo-to-clip
9 Ott 2026

Quanta VRAM serve per i video AI? Wan 2.2, HunyuanVideo 1.5 e LTX-2 in base alla dimensione GPU (2026)
6 Ott 2026
Altre guide

Flusso di lavoro Wan 2.2 5B ComfyUI: testo o immagine 720p in video su una scheda di fascia media
9 Ott 2026
Wan 2.2 14B testo a video ComfyUI workflow: due modelli, un LoRA a 4 step, movimento da cinema
9 Ott 2026
Wan 2.2 Animate ComfyUI workflow: sostituzione del personaggio e trasferimento della posa da un video
9 Ott 2026
Flusso di lavoro ComfyUI LTX-2 da immagine a video: anima un fermo immagine con audio sincronizzato
9 Ott 2026
Cos'è ComfyUI? Una guida per principianti ai nodi, ai flussi di lavoro e al primo grafo
17 Dic 2025