
LTX-2 bild till video ComfyUI arbetsflöde: animera en stillbild med synkroniserat ljud
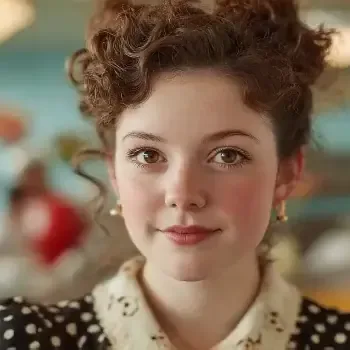
Översikt
Ge LTX-2 en bild så får du en video som börjar på den bilden och låter rätt: servitrisen i mallens diner-exempel säger sin replik med tallriksklirr bakom sig. Grafen är text-till-video-mallen plus Load Image, en resize-nod som ändrar bilden till en giltig storlek, LTXVPreprocess och två LTXVImgToVideoInplace-noder (en per pass) som skriver in bilden i latent.
Mallen renderar i två pass: ett baspass på 768x512 (97 bilder, 20 steg med LTXVScheduler och cfg 4), sedan en 2x latent uppskalning och ett kort förfiningspass med den destillerade LoRA:n på cfg 1. Bredd och höjd måste vara delbara med 64 och bildantalet måste vara ett multipel av 8 plus 1; felaktiga värden ger inget felmeddelande, grafen väljer tyst närmaste giltiga värden. 19B fp8 checkpoint är ett 24 GB kort arbetsflöde; noteringarna säger att 1920x1088 bara ska testas på kraftfull GPU.
Hostad på ModelTrends.ai: video_ltx2_i2v.json-mallen, oförändrad.
Bilder och klipp
The ComfyUI team's launch clip for this model
LTX-2 image to video ComfyUI workflow: the workflow as it opens in ComfyUI
Referens
Namn | Typ | Vad det är |
|---|---|---|
ltx-2-19b-dev-fp8.safetensors | models/checkpoints | LTX-2 19B modellen med dess video- och audio-VAE, fp8. Lightricks/LTX-2 på Hugging Face. Obs: checkpoints, inte diffusion_models. |
gemma_3_12B_it_fp4_mixed.safetensors | models/text_encoders | Gemma 3 12B textencoder i blandad fp4. Comfy-Org/ltx-2, split_files/text_encoders. |
ltx-2-spatial-upscaler-x2-1.0.safetensors | models/latent_upscale_models | 2x latent uppskalare som används i andra passet. Lightricks/LTX-2. |
ltx-2-19b-distilled-lora-384.safetensors | models/loras | |
ltx-2-19b-lora-camera-control-dolly-left.safetensors | models/loras | En kamera-kontroll LoRA, som är avstängd som standard (Ctrl+B för att aktivera). Lightricks kamera LoRA-samling. |
Load Image | your picture | Första bilden. Den ändras till arbetsstorleken (768x512 som standard), så matcha orienteringen. |
Size and length | 768x512, 97 frames, 25 fps | Delbar med 64; bilder 8n+1. Uppskalad 2x i andra passet. |
euler och gradient_estimation; fasta seeds 0 och 10. |
Var filerna ska ligga
Lägg varje nedladdning i den här mappen i din ComfyUI-installation. En loader-nod listar bara filer som ligger i mappen den läser, så en modell i fel mapp visas som saknad.
ComfyUI/├── models/│ ├── checkpoints/│ │ └── ltx-2-19b-dev-fp8.safetensors│ ├── text_encoders/│ │ └── gemma_3_12B_it_fp4_mixed.safetensors│ ├── latent_upscale_models/│ │ └── ltx-2-spatial-upscaler-x2-1.0.safetensors│ └── loras/│ ├── ltx-2-19b-distilled-lora-384.safetensors│ └── ltx-2-19b-lora-camera-control-dolly-left.safetensors
Steg för steg
- Uppdatera ComfyUI (Desktop: Hjälp > Sök efter uppdateringar; portable: kör update_comfyui.bat). Dessa arbetsflöden behöver version 2025 eller senare.
- Ladda ner arbetsflödesfilen nedan och dra den till ComfyUI-canvasen, eller använd Workflow > Open. Noderna visas med filnamnen ifyllda.
- Ladda ner alla filer i tabellen och lägg dem i angivna mappar. Om en modellwidget har röd kant betyder det att namnet inte matchar en fil i mappen: klicka och välj filen du laddade ner. LTX-2 checkpoint går i models/checkpoints.
- Ladda bilden. Ställ in arbetsstorleken efter dess orientering (768x512 liggande, 512x768 stående).
- Beskriv rörelsen, sen ljudet. Beskriv inte vad som redan finns i bilden.
- Tryck på Kör (Ctrl+Enter). Första gången laddas modellerna och det tar längst tid; senare körningar återanvänder dem. Tar några minuter på ett 24 GB kort.
- Mp4-filen med ljud finns i ComfyUI/output/video/LTX_2.0_i2v.
Exempel
Mallens prompt (förkortad)
A close-up shot of a young waitress in a retro 1950s diner, her warm brown eyes meeting the camera with a gentle smile. She wears a black polka-dot dress with an elegant cream lace collar, her reddish-brown hair styled in an elaborate updo with delicate curls
Tips
- En talad replik inom citattecken ger läpprörelse; ansiktet i bilden bör vara hyfsat stort i bild.
- Behåll första bildens ljus i prompten ("varmt diner-ljus") så att följande bilder inte ändrar sig.
- För en produkt eller landskap är "kameran zoomar långsamt in" plus en beskrivning av omgivningsljud en säker metod.
- Kamera-kontroll LoRA:n är avstängd som standard; slå på den med Ctrl+B när du vill ha en definierad rörelse.
Felsökning
Noder är röda efter att ha laddat arbetsflödet
Varför det händer
Din ComfyUI är äldre än de noder mallen använder.
Så löser du det
Uppdatera ComfyUI först; dessa mallar använder bara inbyggda noder, så inget extra nodpaket behövs om inte guiden säger det.
"Value not in list" på en modellwidget
Varför det händer
Filen saknas eller ligger i fel mapp.
Så löser du det
Kolla tabellen: diffusion models i models/diffusion_models, text encoders i models/text_encoders, VAEs i models/vae, LoRAs i models/loras. Tryck R för att uppdatera listorna.
CUDA out of memory
Varför det händer
Modellen plus latent passar inte på kortet.
Så löser du det
Sänk bredd, höjd eller bildantal först; välj en fp8 eller GGUF-version av diffusionmodellen; sätt weight_dtype till fp8 i Load Diffusion Model; stäng andra GPU-program. VRAM-guiderna på den här sidan ger siffror per kort.
Första bilden ser annorlunda ut än min bild
Varför det händer
Bilden ändrades till ett annat bildförhållande.
Så löser du det
Matcha arbetsstorleken med bildens orientering; beskära bilden till 3:2 eller 2:3 först.
Frågor
Vilket kort?
24 GB för 19B fp8 checkpoint på 768x512.
Kan den fortsätta en video?
Ja: mata in sista bilden från output som nästa Load Image, behåll prompten konsekvent.
Finns det en snabbare version?
video_ltx2_i2v_distilled i mallbiblioteket hoppar över baspasset med samma modeller.
Länkar och källor
Modeller i den här guiden
Skriven av
Styr det här skeppet. Har åsikter om VAE-dekodningstider som ingen bett om. Tror att vikter vill vara fria och att varje modell du inte kan ladda ner är en prenumeration med extra steg. Kommer inte att svara på frågor om de 400 GB checkpoints på NAS:en.
Alla guider av Captain
Relaterade guider
LTX-2 text till video ComfyUI arbetsflöde: bild och ljud från en prompt
9 okt 2026
Wan 2.2 14B bild till video ComfyUI arbetsflöde: det bästa öppna foto-till-clip grafen
9 okt 2026

Hur mycket VRAM behöver du för AI-video? Wan 2.2, HunyuanVideo 1.5 och LTX-2 efter GPU-storlek (2026)
6 okt 2026
Fler guider

Wan 2.1 bild till video (480p, 14B) ComfyUI arbetsflöde: animera ett foto
9 okt 2026

Wan 2.2 5B ComfyUI arbetsflöde: 720p text eller bild till video på ett mellanklasskort
9 okt 2026
Wan 2.2 Animate ComfyUI arbetsflöde: karaktärsutbyte och poseöverföring från en video
9 okt 2026
FLUX.2 [klein] 4B text till bild ComfyUI arbetsflöde: bilder på under en sekund på ett 8 GB kort
9 okt 2026
Qwen Image Edit 2509 ComfyUI arbetsflöde: redigera foton med en mening, upp till tre referensbilder
9 okt 2026