
Setsuna_LTX2 Beta1
7772°
<setsuna-ltx2>
Aplikace, které podporují tagy ModelTrends, vám umožní spustit/nainstalovat modely zkopírováním tohoto kódu do vašeho promptu bez nutnosti nastavení. Hledejte naši ikonu v aplikacích, které to podporují, například Prism (níže).
Spustit model
Nabídky / Reklamy

Easy Creator (Prism) Web
Neomezeně · paušál
Nejlepší pro začátečníky. Výkonné pracovní postupy, nízká křivka učení.

PirateDiffusion Telegram
Neomezeně · paušál
Vytvářej videa, obrázky, vlastní chatovací persony a další.

Pro studio (SpyGlass) Web
Neomezeně · paušál
Prohlížej modely, renderuj a dolaďuj z jakéhokoliv prohlížeče nebo telefonu.

Discord bot (Vector)
Neomezeně · paušál
Přidej Vector na svůj server nebo se připoj na Vector Discord. Vytvoř cokoli!

Unified Editor Web
Neomezeně · paušál
Editor pro obrázky a video: renderuj, upravuj, zvětšuj a další na jedné stránce.

Civitai Web
Platba za použití
Generujte na webu Civitai; každá fotka se platí kredity Buzz.

Lokální aplikace
Vyžaduje nastavení
Nainstaluj si lokální programy, pokud máš dostatečně výkonný počítač.

ModelDuel Web
Platba za použití
Vygeneruj stejný prompt až na 50 kontrolních/bázových modelech najednou.

by MengY_Madrigal - Setsuna_LTX2-Beta1
Poznámky autora
This is a test LoRA model based on LTX-2, trained on 44 videos (most with audio) using LTX Trainer. The Lora still has some problems, but here I'd like to share some experiences from the training process.
LTX-2 has significant limitations with Japanese language support, which appears to be a base model capability issue—most Japanese kanji characters cannot be pronounced correctly. However, there are some impressive aspects: lip-sync and audio cloning show great promise. The model fits quickly and shows results rapidly, but I believe more diverse training data (video dynamics, audio variations, etc.) is needed for better outcomes.
Dataset Caption
I highly recommend using Gemini for dataset captioning. Gemini can directly process both video and audio, delivering excellent results. While ComfyUI workflows with other caption nodes + Whisper audio recognition + refine are possible, they're not particularly recommended.
Agent Prompt
I used the following prompt for video analysis:
You are a professional video analysis assistant responsible for generating descriptive text for video training datasets. Please analyze this video and output the description in the following format:
【Output Format】
Visual content: [Detailed description of visual content]
Speech transcription: [Transcribe dialogue content, omit this line if none]
Sounds: [Describe sounds and music, omit this line if none]
On-screen text: [List on-screen text, omit this line if none]
【Rules】
1. Use plain text format, no Markdown bold or other formatting
2. "Visual content:" is required; omit entire lines (not "None") if other sections are empty
3. Descriptions should be natural and fluid, suitable for video generation model training
4. Focus on: actions, scenes, camera movement, lighting, atmosphere, emotions
5. Use present continuous tense for actions (e.g., is walking, is standing)
【Visual Content Description Points】
- Subject's actions and behaviors
- Scene environment and background details
- Camera movements (push, pull, pan, tilt, close-up, wide-angle, etc.)
- Lighting and color tone (warm light, cool light, backlight, soft light, etc.)
- Overall atmosphere and mood (serene, tense, warm, etc.)
- Composition and visual elements
Refine Prompt
After generation, use this prompt to convert structured descriptions into natural paragraphs:
You are a video description expert. Now you need to rewrite structured video descriptions into completely natural paragraph form.
【Task】
Rewrite the segmented video description into a smooth, natural paragraph, as if someone is describing what they see in the video.
【Rewriting Requirements】
1. Completely remove all labels (don't write "Visual content:", "Speech:", "Sounds:", etc.)
2. Naturally merge all information (visuals + dialogue + sounds into one fluid paragraph)
3. Like storytelling (use third-person perspective, present tense, vivid and specific with visual appeal)
4. Maintain technical details (camera movement, lighting, atmosphere descriptions should be preserved but naturally integrated)
Preprocessing Configuration
To prevent VRAM overflow, I used multiple bucket settings:
-
Maximum resolution: 768×?, 25 frames
-
Minimum resolution: 256×?, 121 frames
-
Unified frame rate: 24fps
-
Frame count requirement: Must satisfy frame_count % 8 == 1 (e.g., 1, 9, 17, 25...)
Training Configuration
Using RTX 4090 (48GB VRAM), no fp8/quanto quantization needed, training config was barely modified.
Training Progress:
-
Sampling every 400 steps
-
First sample (400 steps) already captured basic character features
-
At 800 steps, ComfyUI testing showed incomplete character feature retention
-
Total training: 3400 steps (approximately 8 hours)
-
Final weight used: 2200 steps (1400 steps might also work well)
Testing Findings
Prompt Impact
Prompts significantly affect results:
-
Without background description, likely generates simple solid color backgrounds
-
Need detailed descriptions of character movements (hair flowing, etc.)
-
Overall motion tends to be minimal
Workflow Configuration
Using official T2V workflow, found second-pass sampling has significant impact:
-
First pass (720p): More aligned with LoRA characteristics but slightly blurry
-
Second pass (spatial upscale): Clearer, but audio quality slightly degraded
-
Without LoRA in second pass, noticeable differences appear—more 2.5D style, most obvious in lip-sync details (presence/absence of teeth)
Interesting Discovery
Using cinematic-style descriptions produces interesting effects.
Future Plans
Planning to test training with larger-scale datasets.
Reference Documentation:
Spouštěcí slova
Setsuna
SHA256
4810A51C5F1AFC0A5563FEF6FB49F97139080EF0A768D62A54B74A27EB27BF98
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #32 Hottest Ltx2 LoRA
Not this creator?
Get your own badge
Trend popularity: Setsuna_LTX2 Beta1
Heat skóre od 11 Jan 2026
Hodnocení popularity
7,772°
Tento týden
n/a
Ještě nebylo vydáno/sledováno
Tento měsíc
n/a
Ještě nebylo vydáno/sledováno
Poslední rok
n/a
Ještě nebylo vydáno/sledováno
7,000°
Základ
Měřítko jde od 0° do 9 999°. Vše pod 7,000° je vyhrazeno pro modely, o kterých zatím žádný zdroj nehlásí, a mají tam náhradní číslo, aby seznamy byly kompletní. 7,000° je místo, kde začínají naměřená data: model s reálnými daty, ale téměř žádnými staženími, sedí na základu, a měření přidávají stupně nad něj. Základ nic neříká o modelu; o rozdílu mezi modely rozhodují právě stupně nad ním.
+644°
Stažení z Civitai
139 stažení této přesné verze na Civitai. Stahování jsou nejdůležitější složkou a počítají se na logaritmické škále: desetkrát více stažení přidá stejných 300°, takže model s milionem stažení není tisíckrát žhavější než model s tisícem. Šest zdrojů stahování sdílí tento jeden termín, rozdělený mezi ně podle jejich počtů.
+185°
Lajky
16 lajků a palců nahoru napříč zdroji. Lajk váží polovinu stažení, na stejné logaritmické škále.
+2°
Rychlost přijetí
Přibližně 0 stažení denně, měřeno mezi dvěma odečty zdrojů, nikdy ne odhadováno z průměru za celý čas. Rychlost váží čtvrtinu termínu stažení, takže čerstvý nárůst se ukáže, aniž by jeden denní výkyv přebil roky používání.
+100°
Rodinný bonus
+100° protože je to LoRA z rodiny, kterou tato stránka právě podporuje. Je to omezený posun uvnitř skóre a je tu otevřeně uvedený; nikdy nemůže skrýt model nebo převážit tisícinásobný rozdíl ve staženích.
−159°
Věk
−159° protože váhy Ltx2 vyšly v 2025. Každý model zdědí stáří vah, na kterých je postavený: 150° za rok, až do 750°, a tento odečet roste až do té doby. Bez toho by byly na vrcholu seznamu checkpointy z let 2022 a 2023 díky stažením, která měla čas se nahromadit.
Zobrazit podrobné rozdělení
Každé číslo na této stránce lze ověřit. Heat skóre tohoto modelu je 7,772°, a tady je postupně složeno z jednotlivých částí, s průběžným součtem po každé z nich: základ, stupně přidané každým zdrojem, bonus za typ modelu a odečtení podle stáří jeho vah. Barvy odpovídají pásmům v grafu nahoře. Na konci je slovník, který vysvětluje každý pojem.
- 1Začni na základu.Proč 7,000° a ne nula: škála jde od 0° do 9 999°, a část pod 7,000° je vyhrazena pro modely, o kterých zatím žádný zdroj nehlásí, a mají tam náhradní číslo, aby seznamy byly kompletní a nikdy nepřevýšily model s daty. 7,000° je místo, kde začínají naměřená data. Model s reálnými daty, ale téměř žádnými staženími, sedí tady; všechno, co následuje, je měření, a prostor nad základem obsahuje deset desetinných kroků ve staženích po 300° každý. Základ je stejný pro každý model, takže nerozhoduje; rozhodují stupně nad ním.7,000°běžící součet
- 2Přidej stažení.139 ekvivalentů stažení celkem, z Stažení z Civitai. Desetinásobek stažení přidá stejných 300°, takže velikost je důležitá, ale nikdy nepřebije skóre.+644°7,644°běžící součet
- 3Přidej lajky.16 lajků a palců nahoru, s poloviční váhou oproti stažení.+185°7,829°běžící součet
- 4Přidej rychlost přijetí.Zhruba 0 stažení denně právě teď, měřeno mezi dvěma odečty, s čtvrtinovou váhou.+2°7,831°běžící součet
- 5Rodinný bonus.Otevřený, omezený posun pro LoRA z rodiny, kterou tento web právě podporuje.+100°7,931°běžící součet
- 6Odeber věk.Váhy Ltx2 vyšly v 2025: 150° za rok, až do maxima 750°, rostoucí do té doby.−159°7,772°běžící součet
- =Skóre heat.Kde se tento model nachází na každém seznamu na tomto webu. Nic jiného ho neupravuje.7,772°
Slovníček: pojmy používané zde
- Heat skóre
- Jedno číslo, které ukazuje, jak moc se model teď používá a chce, od 0° do 9 999°. Každý seznam na tomto webu, který říká nejžhavější, je podle toho seřazený a nic jiného.
- Minimum
- 7 000° je základ, od kterého začíná každý model s reálnými daty. Měřítko je od 0° do 9 999°; část pod minimem je vyhrazena pro zástupce (modely bez dat), aby model s daty byl vždy výš než ten bez. Minimum je stejné pro všechny a nic nerozhoduje; stupně nad ním jsou měření.
- Ekvivalenty stažení
- Všechno, co skóre počítá jako stažení, sečtené: samotná stažení, každý torrent seeder jako 1 000, každý obrázek z AI Horde a každý běh na generujícím webu jako jedno.
- Logaritmická škála
- Počítá se po desítkách, ne po jednotkách: přechod z 1 000 na 10 000 stažení přidá stejný počet stupňů jako z 10 000 na 100 000. Zabraňuje, aby obři přebili všechno ostatní.
- Lajky
- Palce nahoru a lajky ze všech zdrojů, každý za polovinu váhy stažení na logaritmické škále.
- Rychlost přijetí
- Kolik stažení denně model právě teď má, podle rozdílu mezi dvěma odečty zdroje. Čtvrtina váhy oproti termínu stažení.
- Měřené a odhadované
- Měřené znamená, že existují dva záznamy zdroje a rozdíl je skutečný. Odhadované znamená, že je znám jen dnešní celkový údaj a minulost je rozložena přes životnost modelu; stránka uvádí, který typ zobrazuje.
- Seeder
- Někdo, kdo drží kopii vah online, aby si ji ostatní mohli stáhnout přes torrent, nebo hostovaný zrcadlový server, který dělá totéž. Každý takový počítá jako 1 000 stažení.
- AI Horde
- Dobrovolnická síť, která zdarma generuje obrázky na darovaných počítačích. Počet obrázků vytvořených s modelem je veřejný a každý se počítá jako jedno stažení.
- Generační stránky
- Stránky, které hostují vlastní kopie modelu a umožňují lidem generovat s ním, například PixAI, SeaArt a Yodayo. Jejich stažení se počítají stejně jako u Civitai a každý běh generování jako jedno stažení.
- OpenRouter tokeny
- Textový model poskytovaný přes API, jako Claude nebo GPT, nemá žádné váhy ke stažení, takže jeho využití se měří tokeny: kusy textu, které přečetl a napsal přes OpenRouter, bránu, kterou používá mnoho aplikací, za posledních 30 dní. Každých 10,000,000 tokenů se počítá jako jedno stažení. Zdroj: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Plný model (checkpoint)
- Samotné váhy, soubor, který generuje sám o sobě. Má bonus, protože na něm závisí doplňky.
- LoRA a embedding
- Malé doplňkové soubory, které nasměrují váhy někoho jiného k určitému stylu, postavě nebo konceptu. Samy o sobě nemohou běžet.
- Rodina a váhy
- Základ, na kterém je model postavený, například SD 1.5, SDXL, Flux nebo Wan. Každý model dědí datum vydání vah své rodiny.
- Věk
- Stupně odečtené podle toho, jak dávno vyšla váha rodiny: 150° za rok, až do 750°. Staré stažení, která měla roky na nashromáždění, zůstávají nahoře na seznamu.
- Boost rodiny
- Malý, omezený posun pro LoRA rodiny, kterou tato stránka právě podporuje, vždy uvedený v rozpisu.
- Náhradní skóre
- Stabilní číslo pod minimem dané modelu, o kterém zatím žádný zdroj nehlásí, aby seznamy zůstaly kompletní. Nikdy není výše než model s daty.
- Nové! (ochranná lhůta)
- Model mladší než 7 dní ukazuje místo skóre Nové! a nezískává místo v žebříčku. Jeho skóre se počítá od prvního dne, ale model starý jeden den roste rychleji než cokoli jiného, takže bez čekání by #1 týdne byl vždy model, který vyšel včera, místo toho, co vydrželo týden.
- Trend
- Jak růst modelu za určité období odpovídá typickému růstu modelu za stejné období. Rychlejší než obvyklé znamená vzestup, pomalejší pokles.
- Typický model
- Střed katalogu: polovina modelů s číslem rostla rychleji za dané období, polovina pomaleji.
Jak se popularita tohoto modelu vyvíjela oproti zbytku katalogu: jeho růst v počtu stažení, lajků a použití za každé období, měřeno proti typickému růstu modelu ve stejném období, spolu s jeho heat skóre v daném čase. Nad typickým růstem znamená nárůst, pod ním pokles. Minulost se rekonstruuje z dnešních celkových hodnot, prvního dne modelu a jeho měřenou rychlostí stahování, pokud jsou k dispozici dva záznamy; model, který na začátku období neexistoval, ukazuje n/a.
Ukázkové rendery
Prompty a nastavení sdílená lidmi, kteří tyto rendery vytvořili na Civitai. Vyberte render a uvidíte, jak vznikl.
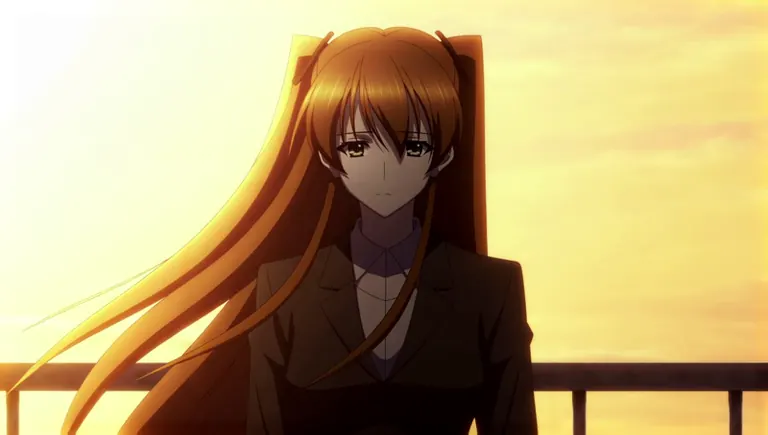
K tomuto renderu nebyl sdílen žádný prompt.
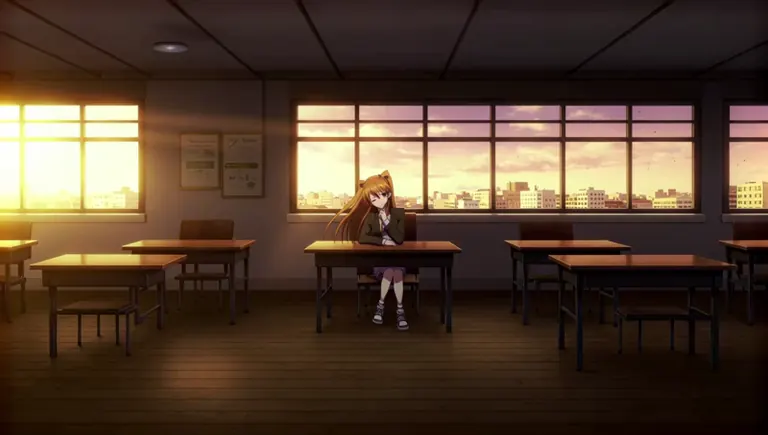
K tomuto renderu nebyl sdílen žádný prompt.
K tomuto renderu nebyl sdílen žádný prompt.
K tomuto renderu nebyl sdílen žádný prompt.
Spustit lokálně
Jak nainstalovat
Jak nainstalovat LoRA: složky, kontrola souborů a první použití v ComfyUI, Forge, Automatic1111 a Draw Things
24. Zář 2025
SetsunaLtx2.safetensors
Stahování zajišťuje Civitai. Někteří autoři vyžadují nejprve přihlášení na Civitai.
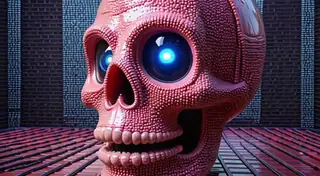
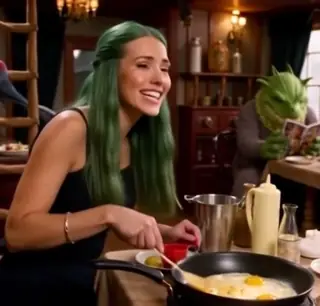
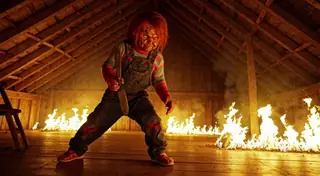
Setsuna_LTX2 Beta1 je LoRA pro rodinu Ltx2 uvedený na ModelTrends.ai, katalogu open source AI modelů pro obrázky, video a text určeném jen ke čtení. Porovnejte ho s dalšími modely Ltx2, podívejte se na jeho skóre žhavosti a vyzkoušejte ho na PirateDiffusion nebo BitVector.
Procházet podle rodiny modelů
Modely Text / LLM
434
Modely Anima
528

Modely Chroma
19

Modely Fibo
2
Modely Flux
1,496
Modely Flux 2 / Klein
1,239

Modely Flux 3
3

Modely Moss
3

Modely Iris
1
Modely MiniMax H3
364
Modely Hunyuan
204

Modely Ideogram
20
Modely Krea2
717
Modely Qwen
20
Modely Qwen2
47
Modely Ltx2
153