
Setsuna_LTX2 Beta1
7772°
<setsuna-ltx2>
Aplikacje obsługujące tagi ModelTrends pozwalają uruchamiać/instalować modele, kopiując ten kod do swojego promptu bez żadnej konfiguracji. Szukaj naszej ikony w aplikacjach, które to wspierają, jak Prism (poniżej).
Uruchom model
Oferty / Reklamy

Easy Creator (Prism) Web
Nielimitowane · stała opłata
Najlepsze dla początkujących. Potężne procesy, niska krzywa nauki.

PirateDiffusion Telegram
Nielimitowane · stała opłata
Twórz filmy, obrazy, niestandardowe postacie do czatu i więcej.

Pro studio (SpyGlass) Web
Nielimitowane · stała opłata
Przeglądaj modele, renderuj i poprawiaj z dowolnej przeglądarki lub telefonu.

Discord bot (Vector)
Nielimitowane · stała opłata
Dodaj Vector do swojego serwera lub dołącz do Vector Discord. Twórz wszystko!

Unified Editor Web
Nielimitowane · stała opłata
Edytor obrazów i wideo: renderuj, edytuj, powiększaj i więcej na jednej stronie.

Civitai Web
Płać za użycie
Generuj na stronie Civitai; każda grafika płatna kredytami Buzz.

Aplikacje lokalne Lokalnie
Wymaga konfiguracji
Zainstaluj programy lokalnie, jeśli masz wystarczająco mocny komputer.

ModelDuel Web
Płać za użycie
Generuj ten sam prompt na maksymalnie 50 modelach checkpoint/podstawowych jednocześnie.

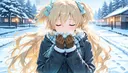
by MengY_Madrigal - Setsuna_LTX2-Beta1
Notatki twórcy
This is a test LoRA model based on LTX-2, trained on 44 videos (most with audio) using LTX Trainer. The Lora still has some problems, but here I'd like to share some experiences from the training process.
LTX-2 has significant limitations with Japanese language support, which appears to be a base model capability issue—most Japanese kanji characters cannot be pronounced correctly. However, there are some impressive aspects: lip-sync and audio cloning show great promise. The model fits quickly and shows results rapidly, but I believe more diverse training data (video dynamics, audio variations, etc.) is needed for better outcomes.
Dataset Caption
I highly recommend using Gemini for dataset captioning. Gemini can directly process both video and audio, delivering excellent results. While ComfyUI workflows with other caption nodes + Whisper audio recognition + refine are possible, they're not particularly recommended.
Agent Prompt
I used the following prompt for video analysis:
You are a professional video analysis assistant responsible for generating descriptive text for video training datasets. Please analyze this video and output the description in the following format:
【Output Format】
Visual content: [Detailed description of visual content]
Speech transcription: [Transcribe dialogue content, omit this line if none]
Sounds: [Describe sounds and music, omit this line if none]
On-screen text: [List on-screen text, omit this line if none]
【Rules】
1. Use plain text format, no Markdown bold or other formatting
2. "Visual content:" is required; omit entire lines (not "None") if other sections are empty
3. Descriptions should be natural and fluid, suitable for video generation model training
4. Focus on: actions, scenes, camera movement, lighting, atmosphere, emotions
5. Use present continuous tense for actions (e.g., is walking, is standing)
【Visual Content Description Points】
- Subject's actions and behaviors
- Scene environment and background details
- Camera movements (push, pull, pan, tilt, close-up, wide-angle, etc.)
- Lighting and color tone (warm light, cool light, backlight, soft light, etc.)
- Overall atmosphere and mood (serene, tense, warm, etc.)
- Composition and visual elements
Refine Prompt
After generation, use this prompt to convert structured descriptions into natural paragraphs:
You are a video description expert. Now you need to rewrite structured video descriptions into completely natural paragraph form.
【Task】
Rewrite the segmented video description into a smooth, natural paragraph, as if someone is describing what they see in the video.
【Rewriting Requirements】
1. Completely remove all labels (don't write "Visual content:", "Speech:", "Sounds:", etc.)
2. Naturally merge all information (visuals + dialogue + sounds into one fluid paragraph)
3. Like storytelling (use third-person perspective, present tense, vivid and specific with visual appeal)
4. Maintain technical details (camera movement, lighting, atmosphere descriptions should be preserved but naturally integrated)
Preprocessing Configuration
To prevent VRAM overflow, I used multiple bucket settings:
-
Maximum resolution: 768×?, 25 frames
-
Minimum resolution: 256×?, 121 frames
-
Unified frame rate: 24fps
-
Frame count requirement: Must satisfy frame_count % 8 == 1 (e.g., 1, 9, 17, 25...)
Training Configuration
Using RTX 4090 (48GB VRAM), no fp8/quanto quantization needed, training config was barely modified.
Training Progress:
-
Sampling every 400 steps
-
First sample (400 steps) already captured basic character features
-
At 800 steps, ComfyUI testing showed incomplete character feature retention
-
Total training: 3400 steps (approximately 8 hours)
-
Final weight used: 2200 steps (1400 steps might also work well)
Testing Findings
Prompt Impact
Prompts significantly affect results:
-
Without background description, likely generates simple solid color backgrounds
-
Need detailed descriptions of character movements (hair flowing, etc.)
-
Overall motion tends to be minimal
Workflow Configuration
Using official T2V workflow, found second-pass sampling has significant impact:
-
First pass (720p): More aligned with LoRA characteristics but slightly blurry
-
Second pass (spatial upscale): Clearer, but audio quality slightly degraded
-
Without LoRA in second pass, noticeable differences appear—more 2.5D style, most obvious in lip-sync details (presence/absence of teeth)
Interesting Discovery
Using cinematic-style descriptions produces interesting effects.
Future Plans
Planning to test training with larger-scale datasets.
Reference Documentation:
Słowa wyzwalające
Setsuna
SHA256
4810A51C5F1AFC0A5563FEF6FB49F97139080EF0A768D62A54B74A27EB27BF98
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #32 Hottest Ltx2 LoRA
Not this creator?
Get your own badge
Trend popularności: Setsuna_LTX2 Beta1
Wynik heat od 11 Jan 2026
Wskaźnik popularności
7,772°
Ten tydzień
n/a
Jeszcze nie wydano/śledzono
Ten miesiąc
n/a
Jeszcze nie wydano/śledzono
Ostatni rok
n/a
Jeszcze nie wydano/śledzono
7,000°
Podstawa
Skala idzie od 0° do 9 999°. Wszystko poniżej 7,000° jest zarezerwowane dla modeli, o których żadne źródło jeszcze nie raportuje, które mają tam zastępczą wartość, by listy były kompletne. 7,000° to punkt startowy dla danych pomiarowych: model z prawdziwymi danymi, ale prawie bez pobrań, stoi na tej podstawie, a pomiary wypełniają stopnie powyżej niej. Podstawa nic nie mówi o modelu; to stopnie powyżej niej robią różnicę i to one rozróżniają modele.
+644°
Pobrania z Civitai
139 pobrań tej dokładnej wersji na Civitai. Pobrania to najważniejszy składnik i liczone są na skali logarytmicznej: dziesięciokrotny wzrost pobrań dodaje te same 300°, więc model z milionem pobrań nie jest tysiąc razy gorętszy niż ten z tysiącem. Sześć źródeł pobrań dzieli ten jeden termin proporcjonalnie do ich liczby.
+185°
Polubienia
16 polubień i kciuków w górę ze wszystkich źródeł. Polubienie waży połowę pobrania, na tej samej skali logarytmicznej.
+2°
Tempo adopcji
Około 0 pobrań dziennie, mierzone między dwoma odczytami źródeł, nigdy nie szacowane na podstawie średniej z całego czasu. Prędkość waży ćwierć składnika pobrań, więc świeży wzrost jest widoczny, ale jednodniowy skok nie przebije lat użycia.
+100°
Bonus rodzinny
+100° bo to LoRA z rodziny, którą ta strona teraz promuje. To ograniczony bonus w wyniku i jest tu jawnie pokazany; nigdy nie ukryje modelu ani nie zrównoważy różnicy w pobraniach rzędu tysiąca razy.
−159°
Wiek
−159° bo wagi Ltx2 wyszły w 2025. Każdy model dziedziczy wiek wag, na których jest zbudowany: 150° na rok, do 750°, i tak rośnie aż do tego limitu. Bez tego na szczycie listy byłyby checkpointy z 2022 i 2023, które mają lata na zbieranie pobrań.
Pokaż szczegóły
Każdą liczbę na tej stronie można sprawdzić. Wynik popularności tego modelu to 7,772°, a tutaj jest zbudowany krok po kroku, z bieżącym sumowaniem po każdym składniku: podstawa, stopnie dodawane przez każde źródło, bonus za rodzaj modelu oraz odejmowanie za wiek wag. Kolory odpowiadają zakresom na wykresie powyżej. Na końcu znajduje się słownik, który wyjaśnia każde pojęcie.
- 1Zacznij od podstawy.Dlaczego 7,000°, a nie zero: skala idzie od 0° do 9 999°, a część poniżej 7,000° jest zarezerwowana dla modeli, o których żadne źródło jeszcze nie raportuje, które mają tam zastępczą wartość, by listy były kompletne i nigdy nie wyprzedzały modeli z danymi. 7,000° to punkt startowy dla danych pomiarowych. Model z prawdziwymi danymi, ale prawie bez pobrań, stoi tutaj; wszystko co dalej to pomiary, a przestrzeń powyżej podstawy mieści dziesięć dziesięciokrotnych kroków w pobraniach po 300° każdy. Podstawa jest taka sama dla każdego modelu, więc nic nie decyduje; decydują stopnie powyżej niej.7,000°bieżąca suma
- 2Dodaj pobrania.139 równoważników pobrań łącznie, z Pobrania z Civitai. Dziesięć razy więcej pobrań dodaje ten sam 300°, więc rozmiar ma znaczenie, ale nigdy nie dominuje wyniku.+644°7,644°bieżąca suma
- 3Dodaj polubienia.16 polubień i kciuków w górę, o połowę mniej wartości niż pobranie.+185°7,829°bieżąca suma
- 4Dodaj tempo adopcji.Około 0 pobrań dziennie teraz, mierzone między dwoma odczytami, z wagą ćwierć pobrania.+2°7,831°bieżąca suma
- 5Wzmocnienie rodziny.Otwarte, ograniczone wsparcie dla LoRA z rodziny, którą ta strona teraz promuje.+100°7,931°bieżąca suma
- 6Usuń wiek.Wagi Ltx2 wyszły w 2025: 150° rocznie, do maksymalnie 750°, rosnące do tego czasu.−159°7,772°bieżąca suma
- =Wynik heat.Pozycja tego modelu na każdej liście na tej stronie. Nic innego tego nie zmienia.7,772°
Słowniczek: używane tu terminy
- Wynik heat
- Jedna liczba pokazująca, jak bardzo model jest używany i pożądany teraz, od 0° do 9,999°. Każda lista na tej stronie z napisem hottest jest sortowana według tego i niczego innego.
- Podstawa
- 7,000° to punkt startowy dla każdego modelu z prawdziwymi danymi. Skala idzie od 0° do 9,999°; część poniżej podstawy jest zarezerwowana dla zastępczych modeli (bez danych), żeby model z danymi zawsze był wyżej. Podstawa jest taka sama dla wszystkich i nic nie decyduje; stopnie powyżej niej to właściwy pomiar.
- Równoważniki pobrań
- Wszystko, co wynik traktuje jak pobranie, zsumowane: same pobrania, każdy seeder torrenta jako 1,000, każde AI Horde zdjęcie i każde uruchomienie na stronie generującej jako jedno.
- Skala logarytmiczna
- Liczenie co dziesięć, nie co jeden: przejście z 1,000 do 10,000 pobrań dodaje tyle samo stopni, co z 10,000 do 100,000. Zapobiega to dominacji gigantów nad resztą.
- Polubienia
- Kciuki w górę i polubienia ze wszystkich źródeł, warte połowę pobrania na skali logarytmicznej.
- Tempo adopcji
- Ile pobrań dziennie model ma teraz, na podstawie różnicy między dwoma odczytami źródła. Ćwierć wagi terminu pobrania.
- Zmierzony i szacowany
- Zmierzony oznacza, że istnieją dwa odczyty źródła i różnica jest rzeczywista. Szacowany oznacza, że znana jest tylko dzisiejsza suma, a przeszłość jest rozłożona na czas życia modelu; strona mówi, który z nich pokazuje.
- Seeder
- Ktoś, kto trzyma kopię wag online, aby inni mogli je pobrać przez torrent, albo hostowany mirror robiący to samo. Każdy taki liczy się jako 1 000 pobrań.
- AI Horde
- Sieć wolontariuszy, która generuje obrazy za darmo na komputerach darczyńców. Liczba obrazów wygenerowanych z modelem jest publiczna i każde liczy się jako jedno pobranie.
- Strony generujące
- Strony, które mają własne kopie modelu i pozwalają ludziom generować z nim obrazy, takie jak PixAI, SeaArt i Yodayo. Ich pobrania liczą się jak na Civitai, a każde uruchomienie generowania to jedno pobranie.
- Tokeny OpenRouter
- Model tekstowy obsługiwany przez API, taki jak Claude czy GPT, nie ma wag do pobrania, więc jego użycie mierzy się tokenami: fragmentami tekstu, które przeczytał i napisał przez OpenRouter, bramkę używaną przez wiele aplikacji, w ciągu ostatnich 30 dni. Każde 10,000,000 tokenów liczy się jako jedno pobranie. Źródło: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Pełny model (checkpoint)
- Same wagi, plik, który generuje samodzielnie. Dostaje bonus, bo dodatki od niego zależą.
- LoRA i embedding
- Małe pliki dodatków, które kierują czyjeś wagi w stronę stylu, postaci lub koncepcji. Nie mogą działać samodzielnie.
- Rodzina i wagi
- Podstawa, na której zbudowano model, np. SD 1.5, SDXL, Flux lub Wan. Każdy model dziedziczy datę wydania wag swojej rodziny.
- Wiek
- Stopnie odejmowane za to, jak dawno wyszły wagi rodziny: 150° za rok, do 750°. Zachowuje stare pobrania, które miały lata na narastanie, zamrażając szczyt listy.
- Wzmocnienie rodziny
- Małe, ograniczone wsparcie dla LoRA z rodziny, którą ta strona teraz promuje, zawsze podane w rozbiciu.
- Wynik zastępczy
- Stabilna liczba poniżej minimum, przyznawana modelowi, o którym jeszcze nie ma danych źródłowych, żeby listy były kompletne. Nigdy nie jest wyżej niż model z danymi.
- Nowy! (okres karencji)
- Model młodszy niż 7 dni pokazuje Nowy! zamiast wyniku i nie zajmuje miejsca w rankingu. Jego wynik jest liczony od pierwszego dnia, ale model jednodniowy rośnie najszybciej, więc bez oczekiwania #1 tygodnia byłby zawsze tym, który pojawił się wczoraj, a nie tym, który utrzymał się przez tydzień.
- Trend
- Jak wzrost modelu w danym okresie wypada na tle typowego wzrostu modelu w tym samym czasie. Szybszy niż zwykle to wzrost, wolniejszy to spadek.
- Typowy model
- Środek katalogu: połowa modeli z danymi rosła szybciej w tym okresie, połowa wolniej.
Jak popularność tego modelu zmieniała się w porównaniu do reszty katalogu: jego wzrost w pobraniach, polubieniach i użyciu w każdym okresie, mierzony względem typowego wzrostu modelu w tym samym czasie, wraz z jego wynikiem heat score. Powyżej typowego wzrostu oznacza wzrost, poniżej spadek. Przeszłość jest odtwarzana na podstawie dzisiejszych sum, pierwszego dnia modelu i zmierzonej prędkości pobrań, jeśli są dwa odczyty; model, który nie istniał na początku okresu, pokazuje n/d.
Przykładowe rendery
Prompty i ustawienia udostępnione przez osoby, które wykonały te rendery na Civitai. Wybierz render, aby zobaczyć, jak powstał.
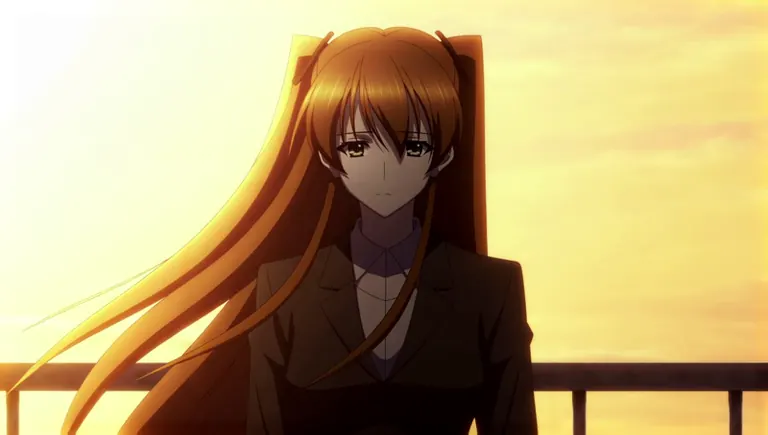
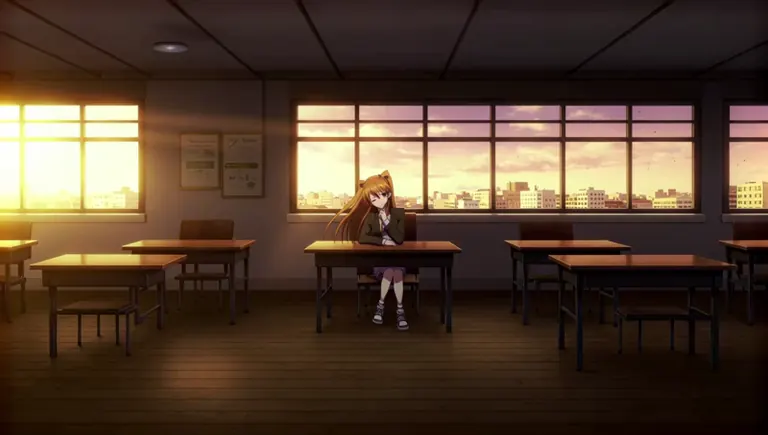
Do tego renderu nie udostępniono promptu.
Do tego renderu nie udostępniono promptu.
Do tego renderu nie udostępniono promptu.
Do tego renderu nie udostępniono promptu.
Uruchom lokalnie
Jak zainstalować
Jak zainstalować LoRA: foldery, sprawdzanie plików i pierwsze użycie w ComfyUI, Forge, Automatic1111 i Draw Things
24 Wrz 2025
SetsunaLtx2.safetensors
Pobieranie obsługuje Civitai. Niektórzy twórcy wymagają najpierw zalogowania się na Civitai.
Setsuna_LTX2 Beta1 to LoRA z rodziny Ltx2 wymieniony na ModelTrends.ai, katalogu tylko do odczytu otwartych modeli AI do obrazów, wideo i tekstu. Porównaj go z innymi modelami Ltx2, sprawdź wynik popularności, aby zobaczyć trend, i otwórz na PirateDiffusion lub BitVector, aby wypróbować.
Przeglądaj według rodziny modeli
Modele Text / LLM
434
Modele Anima
528

Modele Chroma
19

Modele Fibo
2

Modele Flux
1,496
Modele Flux 2 / Klein
1,239

Modele Flux 3
3

Modele Moss
3

Modele Iris
1
Modele MiniMax H3
364
Modele Hunyuan
204

Modele Ideogram
20
Modele Krea2
717

Modele Qwen
20
Modele Qwen2
47
Modele Ltx2
153