
Setsuna_LTX2 Beta1
7772°
<setsuna-ltx2>
Les applications qui supportent les tags ModelTrends vous permettent d'exécuter/installer des modèles en copiant ce code dans votre prompt sans aucune configuration. Cherchez notre icône dans les applications qui le supportent, comme Prism (ci-dessous).
Lancer ce modèle
Offres / Pub

Easy Creator (Prism) Web
Illimité · forfait fixe
Idéal pour les débutants. Flux de travail puissants, courbe d'apprentissage faible.

PirateDiffusion Telegram
Illimité · forfait fixe
Créez des vidéos, images, personnages de chat personnalisés, et plus encore.

Pro studio (SpyGlass) Web
Illimité · forfait fixe
Parcourez les modèles, générez et affinez depuis n'importe quel navigateur ou téléphone.

Discord bot (Vector)
Illimité · forfait fixe
Ajoutez Vector à votre serveur ou rejoignez le Discord de Vector. Créez tout ce que vous voulez !

Unified Editor Web
Illimité · forfait fixe
Éditeur pour images et vidéos : générez, modifiez, améliorez et plus encore sur une seule page.

Civitai Web
Paiement à l'usage
Générez sur le site de Civitai ; chaque image est payée avec des crédits Buzz.

Applications locales
Nécessite une configuration
Installe des programmes locaux si ton ordinateur est assez puissant.

ModelDuel Web
Paiement à l'usage
Génère la même invite sur jusqu'à 50 modèles checkpoint/base en même temps.

by MengY_Madrigal - Setsuna_LTX2-Beta1
Notes du créateur
This is a test LoRA model based on LTX-2, trained on 44 videos (most with audio) using LTX Trainer. The Lora still has some problems, but here I'd like to share some experiences from the training process.
LTX-2 has significant limitations with Japanese language support, which appears to be a base model capability issue—most Japanese kanji characters cannot be pronounced correctly. However, there are some impressive aspects: lip-sync and audio cloning show great promise. The model fits quickly and shows results rapidly, but I believe more diverse training data (video dynamics, audio variations, etc.) is needed for better outcomes.
Dataset Caption
I highly recommend using Gemini for dataset captioning. Gemini can directly process both video and audio, delivering excellent results. While ComfyUI workflows with other caption nodes + Whisper audio recognition + refine are possible, they're not particularly recommended.
Agent Prompt
I used the following prompt for video analysis:
You are a professional video analysis assistant responsible for generating descriptive text for video training datasets. Please analyze this video and output the description in the following format:
【Output Format】
Visual content: [Detailed description of visual content]
Speech transcription: [Transcribe dialogue content, omit this line if none]
Sounds: [Describe sounds and music, omit this line if none]
On-screen text: [List on-screen text, omit this line if none]
【Rules】
1. Use plain text format, no Markdown bold or other formatting
2. "Visual content:" is required; omit entire lines (not "None") if other sections are empty
3. Descriptions should be natural and fluid, suitable for video generation model training
4. Focus on: actions, scenes, camera movement, lighting, atmosphere, emotions
5. Use present continuous tense for actions (e.g., is walking, is standing)
【Visual Content Description Points】
- Subject's actions and behaviors
- Scene environment and background details
- Camera movements (push, pull, pan, tilt, close-up, wide-angle, etc.)
- Lighting and color tone (warm light, cool light, backlight, soft light, etc.)
- Overall atmosphere and mood (serene, tense, warm, etc.)
- Composition and visual elements
Refine Prompt
After generation, use this prompt to convert structured descriptions into natural paragraphs:
You are a video description expert. Now you need to rewrite structured video descriptions into completely natural paragraph form.
【Task】
Rewrite the segmented video description into a smooth, natural paragraph, as if someone is describing what they see in the video.
【Rewriting Requirements】
1. Completely remove all labels (don't write "Visual content:", "Speech:", "Sounds:", etc.)
2. Naturally merge all information (visuals + dialogue + sounds into one fluid paragraph)
3. Like storytelling (use third-person perspective, present tense, vivid and specific with visual appeal)
4. Maintain technical details (camera movement, lighting, atmosphere descriptions should be preserved but naturally integrated)
Preprocessing Configuration
To prevent VRAM overflow, I used multiple bucket settings:
-
Maximum resolution: 768×?, 25 frames
-
Minimum resolution: 256×?, 121 frames
-
Unified frame rate: 24fps
-
Frame count requirement: Must satisfy frame_count % 8 == 1 (e.g., 1, 9, 17, 25...)
Training Configuration
Using RTX 4090 (48GB VRAM), no fp8/quanto quantization needed, training config was barely modified.
Training Progress:
-
Sampling every 400 steps
-
First sample (400 steps) already captured basic character features
-
At 800 steps, ComfyUI testing showed incomplete character feature retention
-
Total training: 3400 steps (approximately 8 hours)
-
Final weight used: 2200 steps (1400 steps might also work well)
Testing Findings
Prompt Impact
Prompts significantly affect results:
-
Without background description, likely generates simple solid color backgrounds
-
Need detailed descriptions of character movements (hair flowing, etc.)
-
Overall motion tends to be minimal
Workflow Configuration
Using official T2V workflow, found second-pass sampling has significant impact:
-
First pass (720p): More aligned with LoRA characteristics but slightly blurry
-
Second pass (spatial upscale): Clearer, but audio quality slightly degraded
-
Without LoRA in second pass, noticeable differences appear—more 2.5D style, most obvious in lip-sync details (presence/absence of teeth)
Interesting Discovery
Using cinematic-style descriptions produces interesting effects.
Future Plans
Planning to test training with larger-scale datasets.
Reference Documentation:
Mots déclencheurs
Setsuna
SHA256
4810A51C5F1AFC0A5563FEF6FB49F97139080EF0A768D62A54B74A27EB27BF98
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #32 Hottest Ltx2 LoRA
Not this creator?
Get your own badge
Tendance de popularité de Setsuna_LTX2 Beta1
Score de chaleur depuis 11 Jan 2026
Score de popularité
7,772°
Cette semaine
n/a
Pas encore publié/suivi
Ce mois-ci
n/a
Pas encore publié/suivi
L'année passée
n/a
Pas encore publié/suivi
7,000°
Plancher
L’échelle va de 0° à 9 999°. Tout ce qui est en dessous de 7,000° est réservé aux modèles dont aucune source ne rapporte encore de données, ils portent un nombre de remplacement pour que les listes restent complètes. 7,000° est le point où les données mesurées commencent : un modèle avec de vraies données mais presque aucun téléchargement est au plancher, et les mesures remplissent les degrés au-dessus. Le plancher ne dit rien sur le modèle ; seuls les degrés au-dessus le font, et ce sont eux qui différencient un modèle d’un autre.
+644°
Téléchargements Civitai
139 téléchargements de cette version exacte sur Civitai. Les téléchargements sont l'ingrédient le plus lourd et sont comptés sur une échelle logarithmique : multiplier par dix les téléchargements ajoute 300° au score, donc un modèle avec un million de téléchargements n'est pas mille fois plus chaud qu'un avec mille. Les six sources de téléchargements partagent ce terme, réparti proportionnellement à leurs comptes.
+185°
Likes
16 likes et pouces levés sur toutes les sources. Un like vaut la moitié d’un téléchargement, sur la même échelle logarithmique.
+2°
Taux d’adoption
Environ 0 téléchargements par jour, mesurés entre deux relevés des sources, jamais estimés à partir d’une moyenne sur la durée. La vitesse compte pour un quart du terme téléchargement, donc une poussée récente apparaît sans qu’un pic d’un jour dépasse des années d’usage.
+100°
Bonus famille
+100° parce que c’est un LoRA d’une famille que ce site pousse en ce moment. C’est une petite poussée limitée dans le score et affichée ici ouvertement ; elle ne peut jamais cacher un modèle ni compenser une différence de mille fois en téléchargements.
−159°
Âge
−159° parce que les poids Ltx2 sont sortis en 2025. Chaque modèle hérite de l’âge des poids sur lesquels il est construit : 150° par an, jusqu’à 750°, et ça continue de grandir jusqu’à ce seuil. Sans ça, le haut de la liste serait occupé par des checkpoints de 2022 et 2023 grâce aux téléchargements accumulés sur des années.
Afficher le détail
Chaque chiffre sur ce site peut être vérifié. Le score de popularité de ce modèle est de 7,772°, et voici comment il est construit, ingrédient par ingrédient, avec le total cumulé après chaque étape : le plancher, les degrés ajoutés par chaque source, le bonus pour le type de modèle et ce que l’âge de ses poids enlève. Les couleurs correspondent aux bandes du graphique ci-dessus. Le glossaire à la fin définit chaque terme.
- 1Commence au plancher.Pourquoi 7,000° et pas zéro : l’échelle va de 0° à 9 999°, et la partie en dessous de 7,000° est réservée aux modèles dont aucune source ne rapporte encore de données, qui portent un nombre de remplacement pour que les listes restent complètes et ne dépassent jamais un modèle avec données. 7,000° est le point où les données mesurées commencent. Un modèle avec de vraies données mais presque aucun téléchargement est ici ; tout ce qui suit est une mesure, et l’espace au-dessus du plancher contient dix paliers de dix fois plus de téléchargements à 300° chacun. Le plancher est le même pour tous les modèles, donc il ne décide rien ; ce sont les degrés au-dessus qui le font.7,000°total en cours
- 2Ajoute les téléchargements.139 équivalents de téléchargement au total, venant de Téléchargements Civitai. Multiplier les téléchargements par dix ajoute le même 300°, donc la taille compte mais ne domine jamais le score.+644°7,644°total en cours
- 3Ajoute les likes.16 likes et pouces levés, à moitié du poids d’un téléchargement.+185°7,829°total en cours
- 4Ajoute le taux d’adoption.Environ 0 téléchargements par jour en ce moment, mesurés entre deux relevés, à un quart du poids.+2°7,831°total en cours
- 5Boost familial.Une petite poussée ouverte et limitée pour les LoRAs d’une famille que ce site met en avant en ce moment.+100°7,931°total en cours
- 6Enlève l’âge.Les poids Ltx2 sont sortis en 2025 : 150° par an, jusqu’à 750°, qui augmente jusqu’à ce moment.−159°7,772°total en cours
- =Le score de chaleur.La place de ce modèle dans chaque liste de ce site. Rien d’autre ne le modifie.7,772°
Glossaire : les termes utilisés ici
- Score de chaleur
- Un seul chiffre pour montrer à quel point un modèle est utilisé et recherché en ce moment, de 0° à 9 999°. Chaque liste sur ce site qui dit « les plus chauds » est triée selon ce score et rien d’autre.
- Plancher
- Les 7 000° que chaque modèle avec des données réelles commence avec. L’échelle va de 0° à 9 999° ; la partie sous le plancher est réservée aux remplaçants (modèles sans données), pour qu’un modèle avec données soit toujours mieux classé qu’un sans. Le plancher est le même pour tous et ne décide rien ; les degrés au-dessus sont la mesure.
- Équivalents de téléchargement
- Tout ce que le score considère comme un téléchargement, additionné : les téléchargements eux-mêmes, chaque seeder torrent comme 1 000, chaque image AI Horde et chaque exécution sur un site de génération comme un.
- Échelle logarithmique
- On compte par dizaines, pas par unités : passer de 1 000 à 10 000 téléchargements ajoute autant de degrés que passer de 10 000 à 100 000. Ça évite que les géants écrasent tout le reste.
- Likes
- Les pouces levés et likes de toutes sources, valant chacun la moitié d’un téléchargement sur l’échelle logarithmique.
- Taux d’adoption
- Combien de téléchargements par jour un modèle obtient en ce moment, calculé à partir de la différence entre deux relevés d’une source. Un quart du poids du terme téléchargement.
- Mesuré et estimé
- Mesuré signifie qu'il existe deux relevés d'une source et que la différence est réelle. Estimé signifie que seul le total d'aujourd'hui est connu et que le passé est réparti sur la durée de vie du modèle ; le site indique lequel est affiché.
- Seeder
- Quelqu'un qui garde une copie des poids en ligne pour que d'autres puissent les télécharger via un torrent, ou un miroir hébergé qui fait la même chose. Chacun compte comme 1 000 téléchargements.
- AI Horde
- Un réseau de bénévoles qui génère des images gratuitement sur des ordinateurs donnés. Le nombre d'images créées avec un modèle est public, et chacune compte comme un téléchargement.
- Sites de génération
- Sites qui hébergent leurs propres copies d'un modèle et permettent aux gens de générer avec, comme PixAI, SeaArt et Yodayo. Leurs téléchargements comptent comme ceux de Civitai et chaque génération compte comme un téléchargement.
- Tokens OpenRouter
- Un modèle texte servi via une API, comme Claude ou GPT, n'a pas de poids à télécharger, son usage est donc mesuré en tokens : les morceaux de texte lus et écrits via OpenRouter, une passerelle utilisée par de nombreuses applications, sur les 30 derniers jours. Chaque 10,000,000 tokens compte comme un téléchargement. Source : OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Modèle complet (checkpoint)
- Les poids eux-mêmes, le fichier qui génère tout seul. Il reçoit un bonus parce que les add-ons en dépendent.
- LoRA et embedding
- Petits fichiers add-on qui orientent les poids de quelqu'un d'autre vers un style, un personnage ou un concept. Ils ne peuvent pas fonctionner seuls.
- Famille et poids
- La base sur laquelle un modèle est construit, comme SD 1.5, SDXL, Flux ou Wan. Chaque modèle hérite de la date de sortie des poids de sa famille.
- Âge
- Degrés retirés selon l'ancienneté des poids de la famille : 150° par an, jusqu'à 750°. Cela garde les anciens téléchargements qui ont eu des années pour s'accumuler en haut de la liste.
- Boost de la famille
- Une petite poussée limitée pour les LoRA d'une famille que ce site met en avant en ce moment, toujours listée dans la répartition.
- Score de remplacement
- Un nombre stable en dessous du minimum donné à un modèle dont aucune source ne rapporte encore, pour que les listes restent complètes. Il ne dépasse jamais un modèle avec des données.
- Nouveau ! (période de grâce)
- Un modèle âgé de moins de 7 jours affiche Nouveau ! au lieu d'un score et ne figure pas dans le classement. Son score est calculé dès le premier jour, mais un modèle d'un jour grandit plus vite que tout, donc sans attente le #1 de la semaine serait toujours celui sorti hier plutôt que celui qui tient depuis une semaine.
- Tendance
- Comment la croissance d'un modèle sur une période se compare à la croissance typique d'un modèle sur la même période. Plus rapide que la moyenne signifie une hausse, plus lente une baisse.
- Modèle typique
- Le milieu du catalogue : la moitié des modèles avec un chiffre ont grandi plus vite sur la période, l'autre moitié plus lentement.
Voici comment la popularité de ce modèle a évolué par rapport au reste du catalogue : sa croissance en téléchargements, likes et utilisation à chaque période, comparée à la croissance typique des modèles sur la même période, avec son score de chaleur à ce moment-là. Au-dessus de la croissance typique, c’est une hausse, en dessous, une baisse. Le passé est reconstitué à partir des totaux d’aujourd’hui, du premier jour du modèle et de sa vitesse de téléchargement mesurée quand il y a deux relevés ; un modèle qui n’existait pas au début d’une période affiche n/a.
Rendus d'exemple
Prompts et réglages partagés par les personnes qui ont réalisé ces rendus sur Civitai. Choisissez un rendu pour voir comment il a été fait.
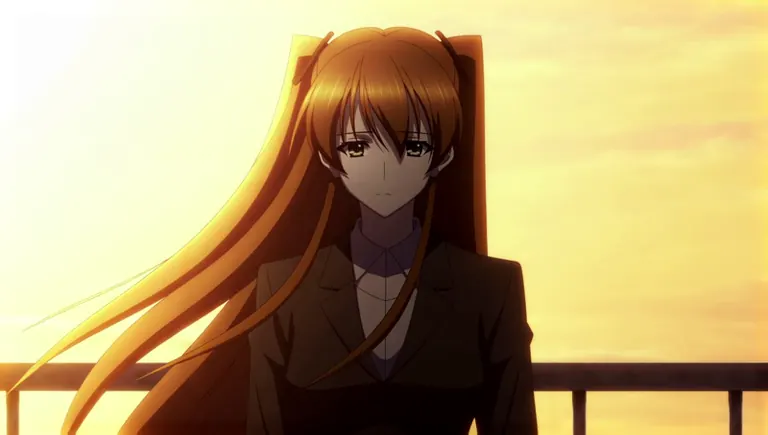
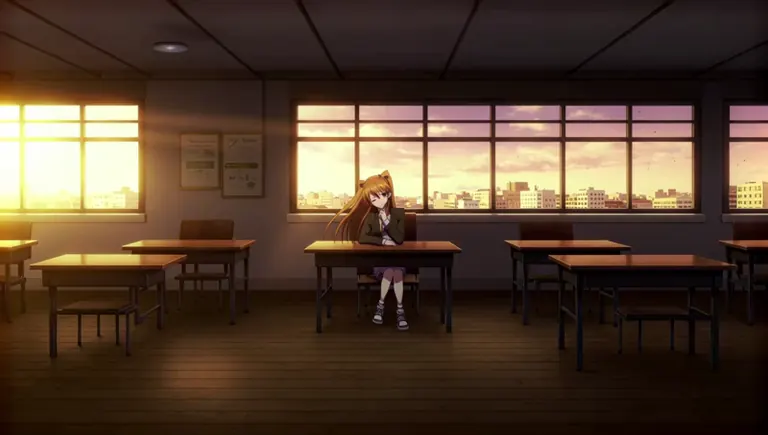
Aucun prompt n'a été partagé avec ce rendu.
Aucun prompt n'a été partagé avec ce rendu.
Aucun prompt n'a été partagé avec ce rendu.
Aucun prompt n'a été partagé avec ce rendu.
Exécuter en local
Comment installer
Comment installer un LoRA : dossiers, vérifications de fichiers et première utilisation dans ComfyUI, Forge, Automatic1111 et Draw Things
24 Sept 2025
SetsunaLtx2.safetensors
Les téléchargements sont servis par Civitai. Certains créateurs demandent d'abord une connexion à Civitai.
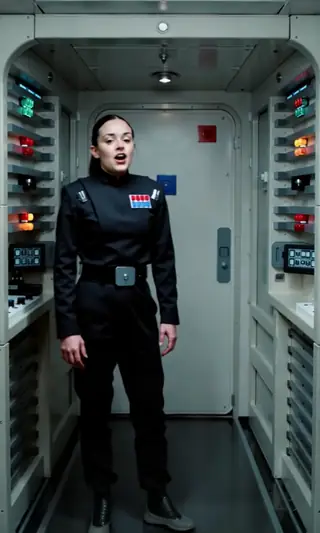
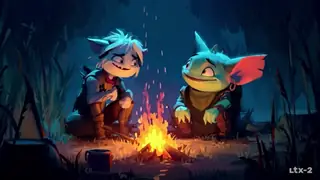
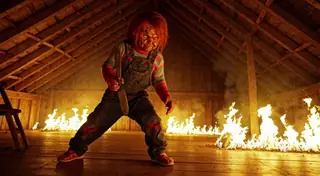
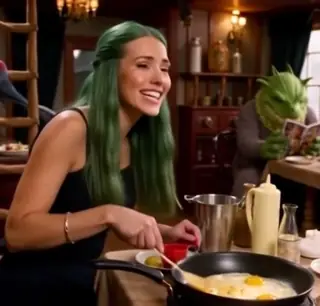
Setsuna_LTX2 Beta1 est un LoRA pour la famille Ltx2, référencé sur ModelTrends.ai, un catalogue en lecture seule de modèles d'IA open source pour l'image, la vidéo et le texte. Comparez-le aux autres modèles Ltx2, consultez son score de chaleur pour suivre sa tendance et ouvrez-le sur PirateDiffusion ou BitVector pour l'essayer.
Parcourir par famille de modèles
Modèles Text / LLM
434
Modèles Anima
528

Modèles Chroma
19

Modèles Fibo
2
Modèles Flux
1,496
Modèles Flux 2 / Klein
1,239

Modèles Flux 3
3

Modèles Moss
3

Modèles Iris
1
Modèles MiniMax H3
364
Modèles Hunyuan
204

Modèles Ideogram
20
Modèles Krea2
717
Modèles Qwen
20
Modèles Qwen2
47
Modèles Ltx2
153