
Setsuna_LTX2 Beta1
7772°
<setsuna-ltx2>
Apps, die ModelTrends-Tags unterstützen, ermöglichen es dir, Modelle auszuführen/zu installieren, indem du diesen Code einfach in deinen Prompt kopierst – ganz ohne Einrichtung. Achte auf unser Symbol in unterstützten Apps wie Prism (siehe unten).
Modell ausführen
Angebote / Werbung

Easy Creator (Prism) Web
Unbegrenzt · Pauschalpreis
Am besten für Anfänger. Leistungsstarke Workflows, geringe Lernkurve.

PirateDiffusion Telegram
Unbegrenzt · Pauschalpreis
Erstelle Videos, Bilder, individuelle Chat-Personas und mehr.

Pro studio (SpyGlass) Web
Unbegrenzt · Pauschalpreis
Durchsuche Modelle, rendere und verfeinere von jedem Browser oder Handy aus.

Discord bot (Vector)
Unbegrenzt · Pauschalpreis
Füge Vector zu deinem Server hinzu oder tritt dem Vector Discord bei. Erschaffe alles!

Unified Editor Web
Unbegrenzt · Pauschalpreis
Editor für Bilder und Videos: rendern, bearbeiten, hochskalieren und mehr auf einer Seite.

Civitai Web
Bezahlen pro Nutzung
Direkt auf Civitai erzeugen; jedes Bild wird mit Buzz-Credits bezahlt.

Lokale Apps
Einrichtung erforderlich
Richte lokale Programme ein, wenn dein Computer leistungsstark genug ist.

ModelDuel Web
Bezahlen pro Nutzung
Erzeuge denselben Prompt gleichzeitig auf bis zu 50 Checkpoint-/Basismodellen.

by MengY_Madrigal - Setsuna_LTX2-Beta1
Notizen des Erstellers
This is a test LoRA model based on LTX-2, trained on 44 videos (most with audio) using LTX Trainer. The Lora still has some problems, but here I'd like to share some experiences from the training process.
LTX-2 has significant limitations with Japanese language support, which appears to be a base model capability issue—most Japanese kanji characters cannot be pronounced correctly. However, there are some impressive aspects: lip-sync and audio cloning show great promise. The model fits quickly and shows results rapidly, but I believe more diverse training data (video dynamics, audio variations, etc.) is needed for better outcomes.
Dataset Caption
I highly recommend using Gemini for dataset captioning. Gemini can directly process both video and audio, delivering excellent results. While ComfyUI workflows with other caption nodes + Whisper audio recognition + refine are possible, they're not particularly recommended.
Agent Prompt
I used the following prompt for video analysis:
You are a professional video analysis assistant responsible for generating descriptive text for video training datasets. Please analyze this video and output the description in the following format:
【Output Format】
Visual content: [Detailed description of visual content]
Speech transcription: [Transcribe dialogue content, omit this line if none]
Sounds: [Describe sounds and music, omit this line if none]
On-screen text: [List on-screen text, omit this line if none]
【Rules】
1. Use plain text format, no Markdown bold or other formatting
2. "Visual content:" is required; omit entire lines (not "None") if other sections are empty
3. Descriptions should be natural and fluid, suitable for video generation model training
4. Focus on: actions, scenes, camera movement, lighting, atmosphere, emotions
5. Use present continuous tense for actions (e.g., is walking, is standing)
【Visual Content Description Points】
- Subject's actions and behaviors
- Scene environment and background details
- Camera movements (push, pull, pan, tilt, close-up, wide-angle, etc.)
- Lighting and color tone (warm light, cool light, backlight, soft light, etc.)
- Overall atmosphere and mood (serene, tense, warm, etc.)
- Composition and visual elements
Refine Prompt
After generation, use this prompt to convert structured descriptions into natural paragraphs:
You are a video description expert. Now you need to rewrite structured video descriptions into completely natural paragraph form.
【Task】
Rewrite the segmented video description into a smooth, natural paragraph, as if someone is describing what they see in the video.
【Rewriting Requirements】
1. Completely remove all labels (don't write "Visual content:", "Speech:", "Sounds:", etc.)
2. Naturally merge all information (visuals + dialogue + sounds into one fluid paragraph)
3. Like storytelling (use third-person perspective, present tense, vivid and specific with visual appeal)
4. Maintain technical details (camera movement, lighting, atmosphere descriptions should be preserved but naturally integrated)
Preprocessing Configuration
To prevent VRAM overflow, I used multiple bucket settings:
-
Maximum resolution: 768×?, 25 frames
-
Minimum resolution: 256×?, 121 frames
-
Unified frame rate: 24fps
-
Frame count requirement: Must satisfy frame_count % 8 == 1 (e.g., 1, 9, 17, 25...)
Training Configuration
Using RTX 4090 (48GB VRAM), no fp8/quanto quantization needed, training config was barely modified.
Training Progress:
-
Sampling every 400 steps
-
First sample (400 steps) already captured basic character features
-
At 800 steps, ComfyUI testing showed incomplete character feature retention
-
Total training: 3400 steps (approximately 8 hours)
-
Final weight used: 2200 steps (1400 steps might also work well)
Testing Findings
Prompt Impact
Prompts significantly affect results:
-
Without background description, likely generates simple solid color backgrounds
-
Need detailed descriptions of character movements (hair flowing, etc.)
-
Overall motion tends to be minimal
Workflow Configuration
Using official T2V workflow, found second-pass sampling has significant impact:
-
First pass (720p): More aligned with LoRA characteristics but slightly blurry
-
Second pass (spatial upscale): Clearer, but audio quality slightly degraded
-
Without LoRA in second pass, noticeable differences appear—more 2.5D style, most obvious in lip-sync details (presence/absence of teeth)
Interesting Discovery
Using cinematic-style descriptions produces interesting effects.
Future Plans
Planning to test training with larger-scale datasets.
Reference Documentation:
Triggerwörter
Setsuna
SHA256
4810A51C5F1AFC0A5563FEF6FB49F97139080EF0A768D62A54B74A27EB27BF98
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #32 Hottest Ltx2 LoRA
Not this creator?
Get your own badge
Beliebtheitstrend von Setsuna_LTX2 Beta1
Heat-Score seit 11 Jan 2026
Heat-Score
7,772°
Diese Woche
n/a
Noch nicht veröffentlicht/erfasst
Diesen Monat
n/a
Noch nicht veröffentlicht/erfasst
Vergangenes Jahr
n/a
Noch nicht veröffentlicht/erfasst
7,000°
Grundwert
Die Skala reicht von 0° bis 9.999°. Alles unterhalb von 7,000° ist für Modelle reserviert, über die noch keine Quelle berichtet hat. Diese tragen dort eine Platzhalterzahl, damit die Listen vollständig bleiben. 7,000° ist der Punkt, an dem gemessene Daten beginnen: Ein Modell mit echten Daten, aber fast keinen Downloads, sitzt auf dem Grundwert, und die Messungen füllen die Grade darüber. Der Grundwert sagt nichts über das Modell aus; nur die Grade darüber tun das und trennen ein Modell vom anderen.
+644°
Civitai-Downloads
139 Downloads dieser genauen Version auf Civitai. Downloads sind die wichtigste Zutat und werden auf einer Log-Skala gezählt: Zehnmal so viele Downloads erhöhen den Wert um 300°, sodass ein Modell mit einer Million Downloads nicht tausendmal heißer ist als eines mit tausend. Die sechs Download-Quellen teilen sich diesen Wert anteilig entsprechend ihrer Anzahl.
+185°
Likes
16 Likes und Daumen hoch über die Quellen hinweg. Ein Like zählt halb so viel wie ein Download, auf derselben logarithmischen Skala.
+2°
Verbreitungsrate
Etwa 0 Downloads pro Tag, gemessen zwischen zwei Abfragen der Quellen, nie geschätzt aus einem Durchschnitt über die gesamte Lebenszeit. Die Geschwindigkeit zählt ein Viertel des Download-Werts, sodass ein frischer Anstieg sichtbar wird, ohne dass ein eintägiger Spitzenwert jahrelange Nutzung übertrumpft.
+100°
Familien-Bonus
+100°, weil dies eine LoRA einer Familie ist, die diese Seite gerade besonders fördert. Das ist eine begrenzte Unterstützung innerhalb des Scores und wird hier offen gezeigt; sie kann ein Modell nie verbergen oder einen tausendfachen Unterschied bei den Downloads ausgleichen.
−159°
Alter
−159°, weil die Ltx2-Gewichte im 2025 erschienen sind. Jedes Modell übernimmt das Alter der Gewichte, auf denen es basiert: 150° pro Jahr, bis zu 750°, und es wächst bis dahin weiter. Ohne das wären die Spitzenplätze der Liste Checkpoints aus 2022 und 2023, die durch jahrelange Downloads so hoch gestiegen sind.
Detaillierte Aufschlüsselung anzeigen
Jede Zahl auf dieser Seite kann überprüft werden. Der Heat-Score dieses Modells beträgt 7,772°, und hier wird er Schritt für Schritt aufgebaut, mit dem laufenden Gesamtwert nach jedem Schritt: der Grundwert, die Grad, die jede Quelle hinzufügt, der Bonus für die Art des Modells und was das Alter seiner Gewichte abzieht. Die Farben entsprechen den Bereichen der obigen Grafik. Das Glossar am Ende erklärt jeden Begriff.
- 1Starte beim Grundwert.Warum 7,000° und nicht null: Die Skala reicht von 0° bis 9.999°, und der Bereich unter 7,000° ist für Modelle reserviert, über die noch keine Quelle berichtet hat. Diese tragen dort eine Platzhalterzahl, damit die Listen vollständig bleiben und niemals über einem Modell mit Daten stehen. 7,000° ist der Punkt, an dem gemessene Daten beginnen. Ein Modell mit echten Daten, aber fast keinen Downloads, sitzt hier; alles, was folgt, ist Messung, und der Bereich über dem Grundwert enthält zehn zehnfache Schritte bei Downloads zu je 300°. Der Grundwert ist für jedes Modell gleich, er entscheidet also nichts; die Grade darüber tun das.7,000°laufende Summe
- 2Füge die Downloads hinzu.139 Download-Äquivalente insgesamt, von Civitai-Downloads. Zehnmal die Downloads ergeben denselben 300°, also zählt die Größe, aber sie dominiert die Bewertung nie.+644°7,644°laufende Summe
- 3Füge die Likes hinzu.16 Likes und Daumen hoch, mit der halben Gewichtung eines Downloads.+185°7,829°laufende Summe
- 4Füge die Verbreitungsrate hinzu.Momentan etwa 0 Downloads pro Tag, gemessen zwischen zwei Messungen, mit einem Viertel der Gewichtung.+2°7,831°laufende Summe
- 5Familien-Bonus.Ein offener, begrenzter Schub für LoRAs einer Familie, die diese Seite gerade fördert.+100°7,931°laufende Summe
- 6Nimm das Alter weg.Die Ltx2-Gewichte kamen im 2025 heraus: 150° pro Jahr, bis zu 750°, steigend bis dahin.−159°7,772°laufende Summe
- =Der Heat-Score.Wo dieses Modell auf jeder Liste dieser Seite steht. Nichts anderes beeinflusst ihn.7,772°
Glossar: die hier verwendeten Begriffe
- Heat-Score
- Eine Zahl dafür, wie viel ein Modell gerade genutzt und gewollt wird, von 0° bis 9.999°. Jede Liste auf dieser Seite, die „heißeste“ sagt, ist danach sortiert und nach nichts anderem.
- Grundwert
- Die 7.000°, mit denen jedes Modell mit echten Daten startet. Die Skala reicht von 0° bis 9.999°; der Bereich unter dem Grundwert ist für Platzhalter reserviert (Modelle ohne Daten), damit ein Modell mit Daten immer über einem ohne steht. Der Grundwert ist für alle gleich und entscheidet nichts; die Grade darüber sind die Messung.
- Download-Äquivalente
- Alles, was der Score als Download zählt, zusammengefasst: Downloads selbst, jeder Torrent-Seeder als 1.000, jedes AI Horde-Bild und jeder Lauf auf einer Generierungsseite als eins.
- Logarithmische Skala
- Gezählt in Zehnerschritten, nicht einzeln: Der Sprung von 1.000 auf 10.000 Downloads bringt genauso viele Grade wie von 10.000 auf 100.000. So verdrängen Riesen nicht alles andere.
- Likes
- Daumen hoch und Likes von allen Quellen, jeweils halb so viel wert wie ein Download auf der Log-Skala.
- Verbreitungsrate
- Wie viele Downloads ein Modell gerade pro Tag bekommt, aus dem Unterschied zwischen zwei Messungen einer Quelle. Ein Viertel der Gewichtung des Download-Begriffs.
- Gemessen und geschätzt
- Gemessen bedeutet, dass es zwei Messwerte einer Quelle gibt und der Unterschied echt ist. Geschätzt heißt, es ist nur die heutige Gesamtsumme bekannt und die Vergangenheit wird über die Lebensdauer des Modells verteilt; die Seite sagt, welche Variante angezeigt wird.
- Seeder
- Jemand, der eine Kopie der Gewichte online hält, damit andere sie über einen Torrent herunterladen können, oder ein gehosteter Spiegel, der dasselbe macht. Jeder davon zählt als 1.000 Downloads.
- AI Horde
- Ein Freiwilligennetzwerk, das kostenlos Bilder auf gespendeten Computern generiert. Die Anzahl der Bilder, die es mit einem Modell erstellt hat, ist öffentlich und jedes zählt als ein Download.
- Generierungsseiten
- Seiten, die eigene Kopien eines Modells hosten und Leute damit generieren lassen, wie PixAI, SeaArt und Yodayo. Ihre Downloads zählen wie bei Civitai und jeder Generierungslauf als ein Download.
- OpenRouter Tokens
- Ein Textmodell, das über eine API bereitgestellt wird, wie Claude oder GPT, hat keine Gewichte zum Herunterladen, daher wird seine Nutzung in Tokens gemessen: die Textstücke, die es über OpenRouter gelesen und geschrieben hat, einem Gateway, das viele Apps nutzen, in den letzten 30 Tagen. Je 10,000,000 Tokens zählen als ein Download. Quelle: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Vollständiges Modell (Checkpoint)
- Die Gewichte selbst, die Datei, die eigenständig generiert. Sie bekommt einen Bonus, weil Add-ons davon abhängen.
- LoRA und Embedding
- Kleine Zusatzdateien, die die Gewichte von jemand anderem in Richtung eines Stils, Charakters oder Konzepts lenken. Sie können nicht alleine laufen.
- Familie und Gewichte
- Die Basis, auf der ein Modell aufgebaut ist, wie SD 1.5, SDXL, Flux oder Wan. Jedes Modell erbt das Veröffentlichungsdatum der Gewichte seiner Familie.
- Alter
- Abzüge je nachdem, wie lange die Gewichte der Familie schon draußen sind: 150° pro Jahr, bis zu 750°. Alte Downloads, die Jahre zum Ansammeln hatten, bleiben oben in der Liste eingefroren.
- Familien-Boost
- Ein kleiner, begrenzter Schub für LoRAs einer Familie, die diese Seite gerade vorantreibt, immer in der Aufschlüsselung aufgeführt.
- Stand-in-Wert
- Eine stabile Zahl unter der Mindestgrenze, die einem Modell gegeben wird, über das noch keine Quelle berichtet hat, damit die Listen vollständig bleiben. Sie rangiert nie über einem Modell mit Daten.
- Neu! (Schonfrist)
- Ein Modell, das weniger als 7 Tage alt ist, zeigt Neu! statt einer Punktzahl und nimmt keinen Platz in den Rankings ein. Seine Punktzahl wird ab dem ersten Tag berechnet, aber ein Modell, das einen Tag alt ist, wächst schneller als alles andere, daher wäre ohne die Wartezeit das #1 Modell der Woche immer das, das gestern herauskam, statt das, das sich eine Woche gehalten hat.
- Trend
- Wie das Wachstum eines Modells über einen Zeitraum im Vergleich zum typischen Wachstum eines Modells im gleichen Zeitraum ist. Schneller als üblich bedeutet Anstieg, langsamer bedeutet Rückgang.
- Typisches Modell
- Die Mitte des Katalogs: Die Hälfte der Modelle mit einer Zahl wuchs schneller im Zeitraum, die andere Hälfte langsamer.
Wie sich die Beliebtheit dieses Modells im Vergleich zum Rest des Katalogs entwickelt hat: sein Wachstum bei Downloads, Likes und Nutzung in jedem Zeitraum, gemessen am typischen Wachstum eines Modells im gleichen Zeitraum, mit dem Heat-Score zu diesem Zeitpunkt. Über dem typischen Wachstum bedeutet ein Anstieg, darunter ein Rückgang. Die Vergangenheit wird aus den heutigen Gesamtzahlen, dem ersten Tag des Modells und seiner gemessenen Download-Geschwindigkeit rekonstruiert, wenn zwei Messungen vorliegen; ein Modell, das zu Beginn eines Zeitraums nicht existierte, zeigt n/a an.
Beispielbilder
Prompts und Einstellungen, geteilt von den Leuten, die diese Bilder auf Civitai erstellt haben. Wähle ein Bild, um zu sehen, wie es entstanden ist.
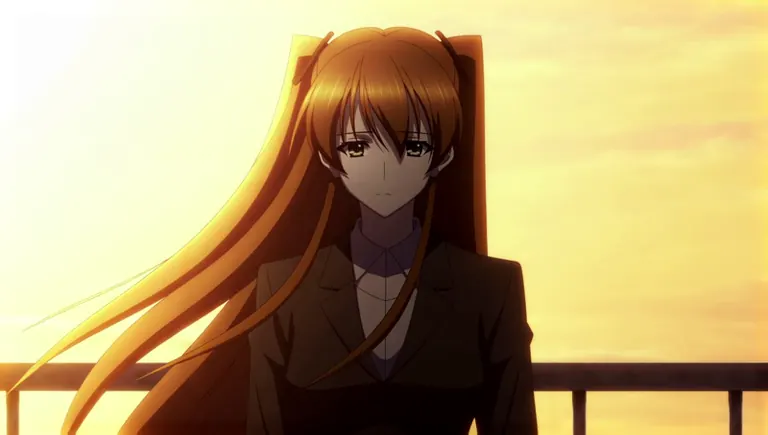
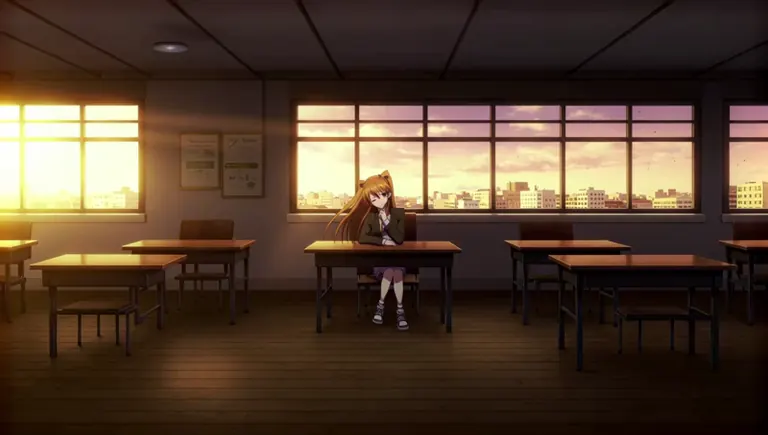
Zu diesem Bild wurde kein Prompt geteilt.
Zu diesem Bild wurde kein Prompt geteilt.
Zu diesem Bild wurde kein Prompt geteilt.
Zu diesem Bild wurde kein Prompt geteilt.
Lokal ausführen
Wie man installiert
Wie man eine LoRA installiert: Ordner, Dateiprüfung und erste Nutzung in ComfyUI, Forge, Automatic1111 und Draw Things
24. Sep 2025
SetsunaLtx2.safetensors
Downloads werden von Civitai bereitgestellt. Manche Ersteller verlangen zuerst eine Anmeldung bei Civitai.
Setsuna_LTX2 Beta1 ist ein LoRA für die Familie Ltx2 und wird auf ModelTrends.ai gelistet, einem reinen Lesekatalog für Open-Source-KI-Modelle für Bild, Video und Text. Vergleiche es mit anderen Ltx2-Modellen, prüfe den Hitzewert, um den Trend zu sehen, und öffne es auf PirateDiffusion oder BitVector, um es auszuprobieren.
Nach Modellfamilie stöbern
Text / LLM-Modelle
434
Anima-Modelle
528

Chroma-Modelle
19

Fibo-Modelle
2
Flux-Modelle
1,496
Flux 2 / Klein-Modelle
1,239

Flux 3-Modelle
3

Moss-Modelle
3

Iris-Modelle
1
MiniMax H3-Modelle
364
Hunyuan-Modelle
204

Ideogram-Modelle
20
Krea2-Modelle
717

Qwen-Modelle
20
Qwen2-Modelle
47
Ltx2-Modelle
153