
Deze pagina is nog niet vertaald en wordt daarom in het Engels getoond.
Modellen
One Obsession 17 RED: warme, vriendelijke anime illustratie
De 17 RED release van One Obsession is favoriet voor gezellige, warme anime scènes. Leer de template, instellingen en ideeën voor vrolijke karakterillustraties.

Modellen
Absolute Reality 1.8.1: realistische mensen, fantasy en sci-fi op SD 1.5
Lykon's Absolute Reality 1.8.1 kan realistische mensen en bredere fantasy- en sci-fi-prompts aan. Leer de tips van de maker over gezichtsconditionering, instellingen, ISO-ruis truc en creatieve ideeën.
Modellen
FaeTastic Details voor Flux: fantasiedetails en glans
Faeia's FaeTastic Details LoRA voegt fijne fantasiedetails, textuur en een vleugje magie toe aan FLUX.1 Dev-afbeeldingen. Leer over gewicht, instellingen en creatieve ideeën voor betoverde portretten en scènes.
Modellen
Lenovo UltraReal voor Flux.2 Klein 9B: filmrealiteit op de nieuwste Flux
Danrisi's Lenovo UltraReal build voor Flux.2 Klein 9B Base voegt echte camera textuur, korrel en kleur toe aan Klein renders. Leer over gewichten, de l3n0v0 trigger, instellingen en ideeën voor portretten en avant-garde mode.
Modellen
96YOTTEA stijl LoRA voor Illustrious: schilderachtige kleur en sfeer
wwHEY's 96YOTTEA stijl LoRA bootst de schilderachtige, kleurrijke stijl van de kunstenaar 96YOTTEA na op Illustrious. Leer de instellingen van de maker, gewicht 1.0, benodigde hires fix en ideeën voor schilderachtige portretten.
Modellen
Esthetische Amateurfoto Krea V4: alledaagse telefoonfoto-realiteit
powerpuff's Esthetische Amateurfoto LoRA zorgt ervoor dat Krea 2-afbeeldingen aanvoelen als echte smartphone- en socialmediafoto's: scherpere details, fellere kleuren, informele composities. Leer over gewicht, prompts en ideeën.
Modellen
YiffyMix v64 (NoobXL): anthro- en wilde karakters met e621-tags
YiffyMix van chilon249 is de langlopende furry checkpoint, nu op NoobAI XL. Leer hoe je e621-tags gebruikt (zonder underscores), de exacte SDXL-instellingen van de maker, ControlNet-tips en ideeën voor anthro-karakterkunst.
Modellen
Elusarca's Krea 2 Detail Enhancer (Edit LoRA): verscherp een bestaande afbeelding
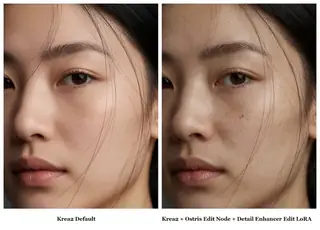
reverentelusarca's experimentele edit LoRA gebruikt Ostris's Krea 2 bewerkingsmethode om details in een bestaande afbeelding te verbeteren. Leer de trigger 'enhance this image', de aanbevolen prompt, beperkingen en ideeën kennen.
Modellen
TrendCraft Style Detailer v2.4 voor Illustrious en NoobAI: community-getunede afwerking
janxd's TrendCraft is een style detailer LoRA getraind op topbeoordeelde community-afbeeldingen om Illustrious en NoobAI renders er klaar voor te laten uitzien. Leer over gewicht, promptcombinaties en ideeën.
Modellen
Helderheidsschuifregelaar voor Krea 2: belichting als een getal
De Helderheidsschuifregelaar van Loraholic verschuift de belichting van het hele beeld in Krea 2, donkerder bij positieve waarden. Leer het bereik van -5 tot 5, hoe het verschilt van de Licht-schuifregelaar en wanneer je beter kunt prompten.
Modellen
Haarlengte-slider voor Krea 2: langer of korter haar met één getal
Loraholic's Haarlengte-slider verandert de haarlengte in Krea 2 en Z-Image Turbo. Leer het stabiele bereik van -2,5 tot 2,5 op Krea 2, de waarschuwing dat ook andere dingen langer kunnen worden, en ideeën voor verschillende kapsels.
Modellen
Anima: licht, snel, een beetje eigenwijs
Een anime-, manga- en illustratiemodel dat het tegendeel is van Z-Image Turbo: 2 miljard parameters, 4 GB, snel op bescheiden GPU’s, natuurlijke taal en Danbooru-tags in dezelfde prompt, en op zijn best als je het creatieve ruimte geeft. Door Chris Green van Diffusion Doodles.

Prompten
Prompting MiniMax H3: tekst naar video, afbeelding naar video, referentievideo en audio
Hoe je MiniMax H3 aanstuurt vanuit een chatcommando: het WHO + WHERE + ACTION + CAMERA + SOUND recept voor tekst naar video, een stilstaand beeld animeren met afbeelding naar video, elke referentieafbeelding een taak geven in referentiemodus, en duidelijke dialogen krijgen in plaats van gemompel. Met kopieer-en-probeer prompts en de PDF van de auteur.

Modellen
Civitai-alternatieven: waar je AI-modellen kunt vinden en downloaden in 2026
Civitai is nog steeds de plek waar de meeste LoRA's ontstaan, en het is ook een enkel bedrijf dat hele categorieën modellen heeft verwijderd, de betalingsregels heeft veranderd en dagenlang offline ging onder druk van betalingsverwerkers. Als je workflow afhankelijk is van een bestand dat alleen op Civitai staat, heb je een probleem dat nog moet komen. Een overzichtskaart van waar de open-weight wereld in 2026 zijn modellen bewaart: Hugging Face, de model-pagina spiegels, torrents en The Hugging Bay, AI Horde, community archieven, de eigen kanalen van makers, en hoe je deze site gebruikt om hetzelfde model op meerdere plekken tegelijk te vinden. Plus hoe je een lokale archief opbouwt zodat een verwijdering je werk nooit stopt.

Videomodellen
MiniMax H3 video prompts: de officiële structuur
Hoe MiniMax wil dat een H3-prompt wordt geschreven: de uitlijningsregel voor beeld-gebonden video's, de drie kernvelden, shots en cuts, camerabewegingen, spreker-ID's en dialooglabels, het geluid en de muziek. Samengevat uit de officiële prompt schrijfhandleiding.
Clouddiensten
Een GPU kopen versus AI-generatie in de cloud in Egypte en het Midden-Oosten (2026)
Invoerrechten, een zwakke pond, hete zomers en limieten op kaarten veranderen de rekensom van het draaien van Flux, SDXL, Qwen of Wan thuis in Caïro, Alexandrië, Riyad of Dubai. Een eenvoudige vergelijking van een lokale grafische kaart tegenover een vast tarief en pay-per-use cloud, met de terugverdientijd en wat je in je eigen markt moet checken voordat je iets koopt.

Fouten en oplossingen
Hoeveel VRAM heb ik eigenlijk nodig voor lokale AI?
Het eerlijke antwoord, per model in plaats van per budget: 8 GB draait 8B chatmodellen en SDXL, 12 tot 16 GB draait 14B modellen, Flux fp8 en korte video, 24 GB is het ideale punt voor 30B-class LLM's en FLUX.2 of Qwen Image, 48 GB en meer is 70B-terrein, en 64 GB systeem-RAM is geen 64 GB GPU. Met de rekensom voor gewichten, context en ruimte, een geheugentabel van 8 GB tot 512 GB, en Kai's video over alle manieren om 128 GB VRAM te bereiken.

Clouddiensten
Een GPU kopen versus AI-generatie in de cloud in de Verenigde Staten en Canada (2026)
Lanceringsprijzen boven de lijstprijs, invoerrechten, een 1.000 W voeding, de energierekening in de zomer en de laptop die je al hebt veranderen de rekensom voor het draaien van Flux, SDXL, Qwen of Wan thuis in de Verenigde Staten en Canada. Een simpele vergelijking tussen het kopen van een grafische kaart en een vast bedrag of betalen per gebruik in de cloud, met de terugverdientijd en waar je op moet letten voordat je iets koopt.

Fouten en oplossingen
Wat is een GGUF-bestand? Uitleg over gekwantiseerde modellen (Q4, Q8, fp8, NF4)
De helft van de bestanden op een modelpagina eindigt op .gguf of heeft tags zoals Q4_K_M, fp8 en NF4, en de enige vraag is welke je moet downloaden. GGUF is een enkel bestand dat gekwantiseerde gewichten bevat en werkt met llama.cpp, Ollama, LM Studio en ComfyUI; de letters erachter geven aan naar hoeveel bits elk gewicht is geperst. Deze gids legt uit wat kwantisatie behoudt en weglaat, decodeert elke veelvoorkomende achtervoegsel, geeft een vuistregel voor de grootte per miljard parameters, en vertelt je welke kwantisatie je moet kiezen voor chatmodellen, Flux, Qwen Image en Wan op 8, 12, 16 en 24 GB.
Fouten en oplossingen
Hoe Flux draaien op 8 GB VRAM: GGUF, fp8, NF4 en offloading
FLUX.1 [dev] is een model met 12 miljard parameters waarvan het volledige precisiebestand 23 GB is, en FLUX.2 [dev] is nog groter. Geen van beide past op een 8 GB kaart zoals ze geleverd worden, maar ze draaien allebei op zo'n kaart zodra je het juiste bestand kiest: een GGUF Q4 of Q5 transformer, een fp8 of NF4 checkpoint, een tekstencoder die op de CPU draait, en een front-end die offloadet. De volgorde van stappen, welke bestanden je precies moet downloaden, wat elk kost qua kwaliteit en snelheid, en de ene instelling die het swappen naar RAM stopt.
Modellen
Hoe train je een LoRA thuis (en wanneer huur je beter een GPU)
Een LoRA is een paar honderd megabytes die een basismodel één nieuw ding leren: een gezicht, een product, een tekenstijl, een camera-look. Thuis trainen kost 15 tot 40 foto’s, een uur of twee, en een kaart met 8 GB (SDXL, Z-Image) tot 24 GB (FLUX.2, Qwen Image). Dit is het hele proces in de juiste volgorde: kies het basismodel, maak de dataset, geef bijschriften, stel de paar belangrijke getallen in, train, test, en weet wanneer het goedkoper is om een 48 GB kaart voor een uur te huren dan een nacht te wachten op je eigen machine.
Modellen
Open weights vs open source vs alleen API: wat je eigenlijk mag doen
"Open" is het meest misbruikte woord in AI. Een model kan open weights zijn (je kunt het downloaden en draaien), open source (je krijgt ook de trainingscode en een licentie die je alles laat doen), of alleen API (je krijgt een URL en een rekening). Het verschil bepaalt of je het offline kunt draaien, kunt fine-tunen, kunt verkopen wat het maakt, of het kunt blijven gebruiken als het bedrijf van gedachten verandert. Deze gids verdeelt de modellen in onze catalogus in die drie categorieën, leest de belangrijke licenties (Apache 2.0, FLUX dev non-commercial, Llama community, Stability community) in gewone taal, en legt uit waarom ModelTrends.ai standaard open weights hoger rangschikt.