
Ta strona nie została jeszcze przetłumaczona, dlatego jest wyświetlana po angielsku.
Modele
One Obsession 17 RED: ciepła, przyjazna ilustracja anime
Wydanie 17 RED z serii One Obsession to ulubieniec do przytulnych, ciepłych scen anime. Poznaj jego szablon, ustawienia i pomysły na radosne ilustracje postaci.

Modele
Absolute Reality 1.8.1: realistyczni ludzie, fantasy i sci-fi na SD 1.5
Absolute Reality 1.8.1 od Lykona radzi sobie z realistycznymi ludźmi oraz szerszymi tematami fantasy i sci-fi. Poznaj rady twórcy dotyczące warunkowania twarzy, ustawienia, trik z szumem ISO i kreatywne pomysły.
Modele
FaeTastic Details dla Flux: fantastyczne detale i blask
LoRA FaeTastic Details od Faeia dodaje skomplikowane fantastyczne detale, teksturę i odrobinę magii do obrazów FLUX.1 Dev. Dowiedz się o wadze, ustawieniach i pomysłach na zaczarowane portrety i sceny.
Modele
Lenovo UltraReal dla Flux.2 Klein 9B: realizm filmowy na najnowszym Flux
Build Lenovo UltraReal od Danrisi dla Flux.2 Klein 9B Base dodaje teksturę, ziarno i kolory jak z prawdziwej kamery do renderów Klein. Poznaj wagi, trigger l3n0v0, ustawienia i pomysły na portrety i awangardową modę.
Modele
LoRA stylu 96YOTTEA dla Illustrious: malarski kolor i nastrój
LoRA stylu 96YOTTEA od wwHEY odtwarza malarski, bogaty w kolory styl artysty 96YOTTEA na Illustrious. Poznaj ustawienia autora, wagę 1.0, potrzebę hires fix i pomysły na malarskie portrety.
Modele
Estetyczne amatorskie zdjęcie Krea V4: codzienny realizm zdjęć z telefonu
LoRA Aesthetic Amateur Photo od powerpuff sprawia, że obrazy Krea 2 wyglądają jak prawdziwe zdjęcia ze smartfona i mediów społecznościowych: ostrzejsze detale, jaśniejsze kolory, swobodne kadrowanie. Dowiedz się o wadze, promptach i pomysłach.
Modele
YiffyMix v64 (NoobXL): postacie anthro i dzikie z tagami e621
YiffyMix od chilon249 to długo działający checkpoint furry, teraz na NoobAI XL. Dowiedz się, jak działa promptowanie tagami e621 (bez podkreśleń), poznaj dokładne ustawienia SDXL autora, porady dotyczące ControlNet i pomysły na sztukę postaci anthro.
Modele
Elusarca's Krea 2 Detail Enhancer (Edit LoRA): wyostrzenie istniejącego obrazu
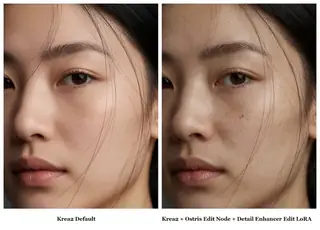
Eksperymentalny edit LoRA reverentelusarca korzysta z metody edycji Krea 2 Ostrisa, aby poprawić szczegóły na istniejącym obrazie. Dowiedz się, jak działa trigger enhance this image, jaki jest zalecany prompt, jakie są ograniczenia i pomysły.
Modele
TrendCraft Style Detailer v2.4 dla Illustrious i NoobAI: dopracowanie przez społeczność
TrendCraft od janxd to LoRA do stylizacji, wytrenowana na najlepszych obrazach ze społeczności, żeby rendery z Illustrious i NoobAI wyglądały jak gotowe do publikacji. Dowiedz się o wadze, łączeniu z promptem i pomysłach.
Modele
Suwak jasności dla Krea 2: ekspozycja jako liczba
Suwak jasności Loraholic przesuwa ekspozycję całego obrazu w Krea 2, przy wartościach dodatnich robi go ciemniejszym. Poznaj zakres od -5 do 5, różnice względem suwaka Light i kiedy lepiej używać prompta.
Modele
Suwak długości włosów dla Krea 2: dłuższe lub krótsze włosy jednym numerem
Suwak długości włosów Loraholic zmienia długość włosów w Krea 2 i Z-Image Turbo. Poznaj stabilny zakres od -2.5 do 2.5 w Krea 2, ostrzeżenie o innych elementach, które się wydłużają, oraz pomysły na różne fryzury.
Modele
Anima: lekka, szybka, trochę niesforna
Model do anime, mangi i ilustracji będący przeciwieństwem Z-Image Turbo: 2 miliardy parametrów, 4 GB, szybki na skromnych GPU, język naturalny i tagi Danbooru w jednym prompcie, najlepszy, gdy zostawić mu twórczą swobodę. Autor: Chris Green z Diffusion Doodles.

Promptowanie
Promptowanie MiniMax H3: tekst na wideo, obraz na wideo, wideo referencyjne i audio
Jak kierować MiniMax H3 za pomocą komendy w czacie: przepis WHO + WHERE + ACTION + CAMERA + SOUND dla tekstu na wideo, animowanie statycznego obrazu w obraz na wideo, przypisywanie każdemu obrazowi referencyjnemu zadania w trybie referencyjnym oraz uzyskiwanie czystego dialogu zamiast mamrotania. Z gotowymi promptami do kopiowania i testowania oraz PDF-em autora.

Modele
Alternatywy dla Civitai: gdzie znaleźć i pobrać modele AI w 2026
Civitai to wciąż miejsce, gdzie powstaje większość LoRAs, ale to też jedna firma, która usunęła całe kategorie modeli, zmieniła zasady płatności i na kilka dni zniknęła pod presją procesorów płatności. Jeśli twój workflow zależy od pliku dostępnego tylko na Civitai, masz problem, który prędzej czy później się pojawi. Mapa kapitana pokazująca, gdzie jeszcze świat otwartych wag trzyma swoje modele w 2026: Hugging Face, lustrzane strony modeli, torrenty i The Hugging Bay, AI Horde, archiwa społeczności, kanały twórców i jak używać tej strony, by znaleźć ten sam model w kilku miejscach naraz. Plus jak zrobić lokalne archiwum, żeby żadna blokada nie zatrzymała twojej pracy.

Modele wideo
MiniMax H3 video prompts: oficjalna struktura
Jak MiniMax chce, żeby pisać prompt H3: linia wyrównania dla wideo osadzonego na obrazie, trzy główne pola, ujęcia i cięcia, ruchy kamery, ID mówców i tagi dialogowe, dźwięk i muzyka. Skrócone z oficjalnego przewodnika po pisaniu promptów.
Usługi w chmurze
Kupno GPU kontra generowanie AI w chmurze w Egipcie i na Bliskim Wschodzie (2026)
Cła importowe, słaby funt, gorące lata i limity kart zmieniają rachunki przy uruchamianiu Flux, SDXL, Qwen czy Wan w domu w Kairze, Aleksandrii, Rijadzie czy Dubaju. Proste porównanie lokalnej karty graficznej z abonamentem i płatnością za użycie w chmurze, z sumą zwrotu i tym, co sprawdzić na swoim rynku przed wydaniem pieniędzy.

Błędy i rozwiązania
Ile VRAM naprawdę potrzebuję do lokalnej AI?
Szczera odpowiedź, według modelu, a nie budżetu: 8 GB obsłuży modele czatowe 8B i SDXL, 12 do 16 GB wystarczy na modele 14B, Flux fp8 i krótkie wideo, 24 GB to optymalny wybór dla modeli klasy 30B oraz FLUX.2 lub Qwen Image, 48 GB i więcej to teren modeli 70B, a 64 GB RAM systemowy to nie to samo co 64 GB GPU. Z arytmetyką dla wag, kontekstu i zapasu, tabelą poziomów pamięci od 8 GB do 512 GB oraz filmem Kaia o wszystkich sposobach na osiągnięcie 128 GB VRAM.

Usługi w chmurze
Kupno GPU vs generowanie AI w chmurze w USA i Kanadzie (2026)
Ceny startowe powyżej ceny katalogowej, cła, zasilacz 1 000 W, rachunek za prąd latem i laptop, który już masz, zmieniają rachunki przy uruchamianiu Flux, SDXL, Qwen czy Wan w domu w USA i Kanadzie. Proste porównanie kupna karty graficznej z abonamentem i płatnością za użycie w chmurze, z sumą zwrotu i tym, co sprawdzić przed wydaniem pieniędzy.

Błędy i rozwiązania
Co to jest plik GGUF? Wyjaśnienie modeli kwantyzowanych (Q4, Q8, fp8, NF4)
Połowa plików na stronie modelu kończy się na .gguf lub ma tagi takie jak Q4_K_M, fp8 i NF4, a jedyne pytanie to, który pobrać. GGUF to pojedynczy plik z kwantyzowanymi wagami, działający na llama.cpp, Ollama, LM Studio i ComfyUI; litery po nim mówią, na ile bitów skompresowano każdą wagę. Ten przewodnik wyjaśnia, co kwantyzacja zachowuje, a co traci, rozkodowuje każdy popularny sufiks, podaje regułę rozmiaru na miliard parametrów i mówi, który quant wybrać dla modeli czatu, Flux, Qwen Image i Wan na 8, 12, 16 i 24 GB.
Błędy i rozwiązania
Jak uruchomić Flux na 8 GB VRAM: GGUF, fp8, NF4 i offloading
FLUX.1 [dev] to model z 12 miliardami parametrów, którego plik w pełnej precyzji zajmuje 23 GB, a FLUX.2 [dev] jest jeszcze większy. Żaden z nich nie mieści się na karcie 8 GB w standardowej wersji, ale oba działają na niej, jeśli wybierzesz odpowiedni plik: transformator GGUF Q4 lub Q5, checkpoint fp8 lub NF4, enkoder tekstu działający na CPU oraz front-end z offloadingiem. Kolejność działań kapitana, dokładne pliki do pobrania, co kosztuje jakość i szybkość oraz jedno ustawienie, które zatrzymuje powolne przenoszenie do RAM.
Modele
Jak trenować LoRA w domu (i kiedy lepiej wynająć GPU)
LoRA to kilka set megabajtów, które uczą bazowy model jednej nowej rzeczy: twarzy, produktu, stylu rysunku, wyglądu kamery. Trenowanie jej w domu wymaga 15 do 40 zdjęć, godziny lub dwóch oraz karty z 8 GB (SDXL, Z-Image) do 24 GB (FLUX.2, Qwen Image). Oto cały proces krok po kroku: wybierz bazę, zbuduj zbiór danych, podpisz zdjęcia, ustaw kilka ważnych parametrów, trenuj, testuj i wiedz, kiedy taniej jest wynająć kartę 48 GB na godzinę niż czekać całą noc na swoim sprzęcie.
Modele
Otwarte wagi vs otwarte źródła vs tylko API: co naprawdę możesz robić
"Otwarte" to słowo najczęściej nadużywane w AI. Model może mieć otwarte wagi (możesz go pobrać i uruchomić), otwarte źródła (dostajesz też kod treningowy i licencję, która pozwala na wszystko) albo być tylko przez API (dostajesz URL i rachunek). Ta różnica decyduje, czy możesz go używać offline, dostrajać, sprzedawać efekty albo korzystać po zmianie decyzji firmy. Ten przewodnik dzieli modele z naszego katalogu na te trzy kategorie, tłumaczy licencje, które mają znaczenie (Apache 2.0, FLUX dev non-commercial, Llama community, Stability community) prostym językiem i wyjaśnia, dlaczego ModelTrends.ai domyślnie ocenia otwarte wagi.