
Diese Seite ist noch nicht übersetzt und wird deshalb auf Englisch angezeigt.
Modelle
One Obsession 17 RED: warme, freundliche Anime-Illustration
Die 17 RED-Version von One Obsession ist beliebt für gemütliche, warmtonige Anime-Szenen. Lerne die Vorlage, Einstellungen und Ideen für fröhliche Charakterillustrationen kennen.

Modelle
Absolute Reality 1.8.1: realistische Menschen, Fantasy und Sci-Fi auf SD 1.5
Lykons Absolute Reality 1.8.1 kann realistische Menschen und breitere Fantasy- und Sci-Fi-Prompts verarbeiten. Erfahre die Tipps des Erstellers zur Gesichtsbedingung, Einstellungen, ISO-Rausch-Trick und kreative Ideen.
Modelle
FaeTastic Details für Flux: Fantasy-Details und Schimmer
Faeias FaeTastic Details LoRA fügt FLUX.1 Dev-Bildern feine Fantasy-Details, Textur und einen Hauch Magie hinzu. Erfahre Gewicht, Einstellungen und kreative Ideen für verzauberte Porträts und Szenen.
Modelle
Lenovo UltraReal für Flux.2 Klein 9B: Filmrealismus auf dem neuesten Flux
Danrisis Lenovo UltraReal Build für Flux.2 Klein 9B Base fügt Klein-Renderings echte Kamera-Textur, Körnung und Farbe hinzu. Erfahre mehr über die Gewichte, den l3n0v0 Trigger, Einstellungen und Ideen für Porträts und avantgardistische Mode.
Modelle
96YOTTEA Stil LoRA für Illustrious: malerische Farben und Stimmung
wwHEYs 96YOTTEA Stil LoRA reproduziert den malerischen, farbenreichen Stil des Künstlers 96YOTTEA auf Illustrious. Erfahre die Einstellungen des Autors, Gewicht 1.0, notwendige Hires-Fixes und Ideen für malerische Porträts.
Modelle
Ästhetisches Amateurfoto Krea V4: alltäglicher Handyfoto-Realismus
powerpuffs Ästhetisches Amateurfoto LoRA lässt Krea 2 Bilder wie echte Smartphone- und Social-Media-Fotos wirken: schärfere Details, hellere Farben, lockere Bildgestaltung. Erfahre mehr über Gewicht, Prompts und Ideen.
Modelle
YiffyMix v64 (NoobXL): Anthro- und Feral-Charaktere mit e621-Tags
YiffyMix von chilon249 ist der langjährige Furry-Checkpoint, jetzt auf NoobAI XL. Lerne, wie man e621-Tags ohne Unterstriche verwendet, die genauen SDXL-Einstellungen des Autors, ControlNet-Tipps und Ideen für Anthro-Charakterkunst.
Modelle
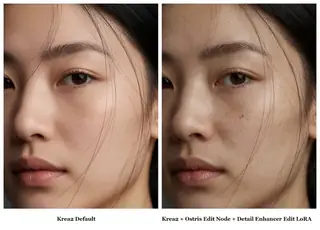
Elusarca's Krea 2 Detail Enhancer (Edit LoRA): ein bestehendes Bild schärfen
Der experimentelle Edit-LoRA von reverentelusarca nutzt Ostris' Krea 2 Edit-Methode, um Details in einem bestehenden Bild zu verbessern. Erfahre hier den 'enhance this image'-Trigger, den empfohlenen Prompt, Einschränkungen und Ideen.
Modelle
TrendCraft Style Detailer v2.4 für Illustrious und NoobAI: community-optimierter Feinschliff
janxds TrendCraft ist ein Style Detailer LoRA, trainiert auf top-bewerteten Community-Bildern, um Illustrious- und NoobAI-Renderings postbereit aussehen zu lassen. Erfahre Gewicht, Prompt-Kombination und Ideen.
Modelle
Helligkeitsregler für Krea 2: Belichtung als Zahl
Loraholics Helligkeitsregler verschiebt die Belichtung des gesamten Bildes in Krea 2, bei positiven Werten wird es dunkler. Lerne den Bereich von -5 bis 5 kennen, wie er sich vom Lichtregler unterscheidet und wann du besser mit Prompting arbeitest.
Modelle
Haarlängen-Regler für Krea 2: längeres oder kürzeres Haar mit einer Zahl
Loraholics Haarlängen-Regler ändert die Haarlänge in Krea 2 und Z-Image Turbo. Erfahre den stabilen Bereich von -2,5 bis 2,5 bei Krea 2, die Warnung, dass auch andere Dinge länger werden können, und Ideen für Frisurenvariationen.
Modelle
Anima: leicht, schnell, ein wenig eigenwillig
Ein Anime-, Manga- und Illustrationsmodell, das das Gegenteil von Z-Image Turbo ist: 2 Milliarden Parameter, 4 GB, schnell auf bescheidenen GPUs, natürliche Sprache und Danbooru-Tags im selben Prompt, und am besten, wenn man ihm kreativen Spielraum lässt. Von Chris Green, Diffusion Doodles.

Prompting
MiniMax H3 ansteuern: Text zu Video, Bild zu Video, Referenzvideo und Audio
Wie du MiniMax H3 per Chatbefehl steuerst: das WHO + WHERE + ACTION + CAMERA + SOUND Rezept für Text zu Video, eine Standaufnahme mit Bild zu Video animieren, jedem Referenzbild eine Aufgabe im Referenzmodus geben und sauberen Dialog statt Gemurmel bekommen. Mit Kopier- und Ausprobier-Prompts und dem PDF des Autors.

Modelle
Civitai-Alternativen: Wo du 2026 KI-Modelle findest und herunterlädst
Civitai ist immer noch der Ort, an dem die meisten LoRAs entstehen. Es ist aber auch eine einzige Firma, die ganze Kategorien von Modellen entfernt hat, ihre Zahlungsregeln geändert hat und unter Druck von Zahlungsanbietern tagelang offline war. Wenn dein Workflow von einer Datei abhängt, die nur Civitai hostet, hast du ein Problem, das bald kommt. Die Karte des Kapitäns zeigt, wo sonst die Open-Weight-Welt 2026 ihre Modelle aufbewahrt: Hugging Face, Spiegelseiten der Modellseiten, Torrents und The Hugging Bay, AI Horde, Community-Archive, die eigenen Kanäle der Ersteller und wie du diese Seite nutzt, um dasselbe Modell an mehreren Orten gleichzeitig zu finden. Plus wie du ein lokales Archiv anlegst, damit kein Takedown deine Arbeit stoppt.

Videomodelle
MiniMax H3 Video-Prompts: die offizielle Struktur
Wie MiniMax einen H3-Prompt geschrieben haben will: die Ausrichtungszeile für bildverankerte Videos, die drei Kernfelder, Einstellungen und Schnitte, Kamerabewegungen, Sprecher-IDs und Dialog-Tags, die Klangkulisse und die Musik. Komprimiert aus dem offiziellen Prompt-Schreibleitfaden.
Cloud-Dienste
GPU kaufen vs. Cloud-AI-Generierung in Ägypten und dem Nahen Osten (2026)
Importzölle, ein schwaches Pfund, heiße Sommer und Kartenlimits verändern die Rechnung, wenn du Flux, SDXL, Qwen oder Wan zu Hause in Kairo, Alexandria, Riad oder Dubai laufen lassen willst. Ein einfacher Vergleich zwischen einer lokalen Grafikkarte und Flatrate- sowie nutzungsabhängigen Cloud-Angeboten, mit der Amortisationszeit und was du vor dem Kauf auf deinem Markt prüfen solltest.

Fehler & Lösungen
Wie viel VRAM brauche ich eigentlich für lokale KI?
Die ehrliche Antwort, nach Modell und nicht nach Budget: 8 GB reichen für 8B-Chatmodelle und SDXL, 12 bis 16 GB für 14B-Modelle, Flux fp8 und kurze Videos, 24 GB sind der Sweet Spot für 30B-Klassen-LLMs und FLUX.2 oder Qwen Image, 48 GB und mehr sind 70B-Territorium, und 64 GB System-RAM sind nicht dasselbe wie eine 64 GB GPU. Mit der Rechnung für Gewichte, Kontext und Puffer, einer Speicherebenentabelle von 8 GB bis 512 GB und Kais Video über alle Wege, 128 GB VRAM zu erreichen.

Cloud-Dienste
GPU kaufen vs. Cloud-AI-Generierung in den USA und Kanada (2026)
Startpreise über dem Listenpreis, Zölle, ein 1.000-W-Netzteil, die Stromrechnung im Sommer und der Laptop, den du schon hast, verändern die Rechnung, wenn du Flux, SDXL, Qwen oder Wan zu Hause in den USA und Kanada betreibst. Ein einfacher Vergleich zwischen dem Kauf einer Grafikkarte und Flatrate- sowie nutzungsabhängigen Cloud-Angeboten, mit der Amortisationsdauer und was du vor dem Kauf prüfen solltest.

Fehler & Lösungen
Was ist eine GGUF-Datei? Quantisierte Modelle erklärt (Q4, Q8, fp8, NF4)
Die Hälfte der Dateien auf einer Modellseite endet auf .gguf oder trägt Tags wie Q4_K_M, fp8 und NF4, und die einzige Frage ist, welche man herunterladen soll. GGUF ist ein Einzel-Datei-Container für quantisierte Gewichte, der auf llama.cpp, Ollama, LM Studio und ComfyUI läuft; die Buchstaben dahinter sagen, auf wie viele Bits jedes Gewicht komprimiert wurde. Diese Anleitung erklärt, was Quantisierung bewahrt und was verloren geht, entschlüsselt alle gängigen Endungen, gibt die Faustregel zur Größe pro Milliarde Parameter und sagt dir, welchen Quant du für Chat-Modelle, Flux, Qwen Image und Wan auf 8, 12, 16 und 24 GB wählen solltest.
Fehler & Lösungen
Wie man Flux mit 8 GB VRAM betreibt: GGUF, fp8, NF4 und Auslagerung
FLUX.1 [dev] ist ein Modell mit 12 Milliarden Parametern, dessen Datei in voller Präzision 23 GB groß ist, und FLUX.2 [dev] ist noch größer. Keines passt so wie es ist auf eine 8-GB-Karte, aber beide laufen trotzdem auf einer, wenn du die richtige Datei wählst: einen GGUF Q4- oder Q5-Transformer, einen fp8- oder NF4-Checkpoint, einen Textencoder, der auf der CPU läuft, und ein Frontend, das auslagert. Die Reihenfolge der Schritte, die genauen Dateien zum Download, was sie an Qualität und Geschwindigkeit kosten, und die eine Einstellung, die das langsame Auslagern in den RAM stoppt.
Modelle
Wie man zu Hause eine LoRA trainiert (und wann man stattdessen eine GPU mieten sollte)
Eine LoRA ist ein paar hundert Megabyte, die einem Basismodell eine neue Sache beibringen: ein Gesicht, ein Produkt, einen Zeichenstil, einen Kamera-Look. Das Training zu Hause braucht 15 bis 40 Bilder, ein bis zwei Stunden und eine Karte mit 8 GB (SDXL, Z-Image) bis 24 GB (FLUX.2, Qwen Image). Hier ist der ganze Ablauf in Kapitänsreihenfolge: Basis wählen, Datensatz erstellen, beschriften, die wichtigen Zahlen einstellen, trainieren, testen und wissen, wann es günstiger ist, eine 48-GB-Karte für eine Stunde zu mieten, als eine Nacht zu warten.
Modelle
Offene Gewichte vs. Open Source vs. Nur API: Was du wirklich darfst
"Offen" ist das am meisten missbrauchte Wort in der KI. Ein Modell kann offene Gewichte haben (du kannst es herunterladen und laufen lassen), Open Source sein (du bekommst auch den Trainingscode und eine Lizenz, die dir alles erlaubt) oder nur per API verfügbar sein (du bekommst eine URL und eine Rechnung). Der Unterschied entscheidet, ob du es offline laufen lassen, feinjustieren, verkaufen oder weiter nutzen kannst, wenn die Firma ihre Meinung ändert. Diese Anleitung sortiert die Modelle in unserem Katalog in diese drei Kategorien, erklärt die wichtigen Lizenzen (Apache 2.0, FLUX dev nicht-kommerziell, Llama Community, Stability Community) in einfachen Worten und zeigt, warum ModelTrends.ai offene Gewichte standardmäßig höher bewertet.