
このページはまだ翻訳されていないため、英語で表示しています。
モデル
One Obsession 17 RED:暖かくて親しみやすいアニメイラスト
One Obsessionの17 REDリリースは、居心地の良い暖色系のアニメシーンにぴったりです。テンプレートや設定、明るいキャラクターイラストのアイデアを学びましょう。

モデル
Absolute Reality 1.8.1: SD 1.5でリアルな人、ファンタジーとSF
LykonのAbsolute Reality 1.8.1はリアルな人間と幅広いファンタジーやSFのプロンプトに対応します。作者の顔の条件付けのコツ、設定、ISOノイズの使い方やクリエイティブなアイデアを学ぼう。
モデル
Flux用FaeTasticディテール:ファンタジーの細部と輝き
FaeiaのFaeTastic Details LoRAは、FLUX.1 Dev画像に複雑なファンタジーの細部、質感、そして魔法のような輝きを加えます。重みや設定、魔法のようなポートレートやシーンのクリエイティブなアイデアを紹介します。
モデル
Lenovo UltraReal for Flux.2 Klein 9B: 最新Fluxでのフィルムリアリズム
DanrisiのLenovo UltraRealビルドはFlux.2 Klein 9B Base用で、Kleinのレンダリングにリアルなカメラの質感、粒子、色を加えます。重み、l3n0v0トリガー、設定、ポートレートやアバンギャルドファッションのアイデアを学びましょう。
モデル
Illustrious用96YOTTEAスタイルLoRA:絵画的な色彩と雰囲気
wwHEYの96YOTTEAスタイルLoRAは、Illustrious上でアーティスト96YOTTEAの絵画的で色彩豊かなスタイルを再現します。作者の設定、重み1.0、hires fixの必要性、絵画的なポートレートのアイデアを学びましょう。
モデル
Aesthetic Amateur Photo Krea V4: 日常のスマホ写真のリアリズム
powerpuffのAesthetic Amateur Photo LoRAは、Krea 2の画像を本物のスマホやSNS写真のように見せます。細部がシャープで色が明るく、自然な構図です。重みやプロンプト、アイデアを学べます。
モデル
YiffyMix v64 (NoobXL): e621タグ付きのアンスロ&野生キャラ
chilon249のYiffyMixは長く使われているファーリーチェックポイントで、今はNoobAI XLで動いてるよ。e621タグの使い方(アンダースコアなし)、作者のSDXL設定、ControlNetのコツ、アンスロキャラのアイデアを紹介するね。
モデル
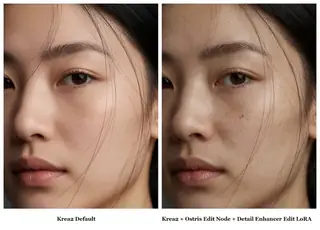
ElusarcaのKrea 2ディテール強化(編集LoRA):既存の画像をシャープにする
reverentelusarcaの実験的な編集LoRAは、OstrisのKrea 2編集手法を使って既存の画像のディテールを強化します。この「enhance this image」トリガー、推奨プロンプト、制限やアイデアを学ぼう。
モデル
Illustrious と NoobAI 用 TrendCraft スタイルディテイラー v2.4:コミュニティ調整の仕上げ
janxd の TrendCraft は、Illustrious と NoobAI のレンダリングを投稿準備済みに見せるために、コミュニティで評価の高い画像を使ってトレーニングされたスタイルディテイラー LoRA です。重みの使い方、プロンプトとの組み合わせ、アイデアを学ぼう。
モデル
Krea 2の明るさスライダー:露出を数値で調整
Loraholicの明るさスライダーはKrea 2で画像全体の露出を調整します。正の値で暗くなります。-5から5の範囲、Lightスライダーとの違い、どんな時にプロンプトで調整するのがいいかを説明します。
モデル
Krea 2用ヘアレングススライダー:数字ひとつで髪の長さを長くしたり短くしたり
LoraholicのヘアレングススライダーはKrea 2とZ-Image Turboで髪の長さを変えられます。Krea 2で安定する-2.5から2.5の範囲、他の部分も長くなる注意点、髪型のバリエーションのアイデアを紹介します。
モデル
Anima:軽く、速く、少し気まぐれ
Z-Image Turbo の対極にあるアニメ・マンガ・イラスト向けモデル。20 億パラメータ、4 GB、控えめな GPU でも高速、同じプロンプトに自然言語と Danbooru タグを混在でき、創作の余地を与えたときに最も力を発揮します。著者:Diffusion Doodles の Chris Green。

プロンプト
MiniMax H3のプロンプト:テキストから動画、画像から動画、参照動画と音声
MiniMax H3をチャットコマンドで操作する方法:テキストから動画へのWHO + WHERE + ACTION + CAMERA + SOUNDのレシピ、画像から動画で静止画を動かす方法、参照モードで各参照画像に役割を与える方法、そしてもごもごした話し方ではなくクリアな対話を得る方法。コピーして試せるプロンプトと著者のPDF付き。

モデル
Civitaiの代替サイト:2026年にAIモデルを見つけてダウンロードする場所
Civitaiは今でも多くのLoRAが生まれる場所であり、同時に支払い処理業者からの圧力でモデルのカテゴリ全体を削除したり、支払いルールを変更したり、数日間サービスが停止したりした唯一の会社でもあります。もしあなたの作業がCivitaiだけがホストしているファイルに依存しているなら、問題が起きるのは時間の問題です。2026年にオープンウェイトの世界がモデルを保管している他の場所を示すキャプテンの地図:Hugging Face、モデルページのミラー、トレントとThe Hugging Bay、AI Horde、コミュニティのアーカイブ、クリエイター自身のチャンネル、そしてこのサイトを使って同じモデルを複数の場所で一度に見つける方法。さらに、ローカルアーカイブを作って削除に負けずに作業を続ける方法も紹介します。

動画モデル
MiniMax H3ビデオプロンプト:公式構造
MiniMaxが求めるH3プロンプトの書き方:画像に基づく動画のための整列行、3つのコアフィールド、ショットとカット、カメラ移動、話者IDとセリフタグ、サウンドスケープと音楽。公式プロンプト作成ガイドからの要約です。
クラウドサービス
エジプトと中東でのGPU購入とクラウドAI生成の比較(2026年)
輸入関税、弱い通貨、暑い夏、カード利用制限が、カイロ、アレクサンドリア、リヤド、ドバイでFlux、SDXL、Qwen、Wanを自宅で動かす計算を変えます。現地のグラフィックカードと定額制・従量制クラウドの単純比較、回収期間の計算、購入前に自分の市場で確認すべきことをまとめました。

エラーと対処法
ローカルAIに実際どれくらいのVRAMが必要?
正直な答えは、予算ではなくモデル別です。8 GBあれば8BチャットモデルやSDXLが動き、12~16 GBで14Bモデル、Flux fp8や短い動画が動きます。24 GBは30BクラスのLLMやFLUX.2、Qwen Imageに最適な容量で、48 GB以上は70Bモデル向けです。64 GBのシステムRAMは64 GBのGPUとは違います。重み、コンテキスト、余裕の計算、8 GBから512 GBまでのメモリ階層表、そしてKaiの128 GB VRAMを実現するあらゆる方法の動画も紹介します。

クラウドサービス
アメリカとカナダでのGPU購入とクラウドAI生成の比較(2026年)
発売価格が定価を上回ること、関税、1000Wの電源、夏の電気代、そしてすでに持っているノートパソコンが、アメリカとカナダでFlux、SDXL、Qwen、Wanを自宅で動かす計算を変えます。グラフィックカード購入と定額制・従量制クラウドの単純比較、回収期間と購入前に確認すべきことをまとめました。

エラーと対処法
GGUFファイルとは?量子化モデルの解説(Q4、Q8、fp8、NF4)
モデルページの半分のファイルは .gguf で終わったり、Q4_K_M、fp8、NF4のようなタグが付いていて、みんなが知りたいのはどれをダウンロードすればいいかだけです。GGUFは量子化された重みを一つのファイルにまとめたもので、llama.cpp、Ollama、LM Studio、ComfyUIで動きます。後ろの文字は各重みが何ビットに圧縮されているかを示しています。このガイドでは量子化で何が残り何が失われるかを説明し、よくある接尾辞を解読し、パラメータ10億あたりのサイズの目安を示し、チャットモデルやFlux、Qwen Image、Wanを8、12、16、24GBの環境で使うときにどの量子化を選ぶべきか教えます。
エラーと対処法
8 GBのVRAMでFluxを動かす方法:GGUF、fp8、NF4、オフローディング
FLUX.1 [dev]は120億パラメータのモデルで、フル精度ファイルは23 GBあります。FLUX.2 [dev]はさらに大きいです。どちらもそのままでは8 GBのカードには収まらず、適切なファイルを選べば1枚のカードで動かせます。GGUFのQ4かQ5トランスフォーマー、fp8かNF4のチェックポイント、CPU上にあるテキストエンコーダー、そしてオフロードするフロントエンドです。操作手順、ダウンロードすべきファイル、品質と速度のコスト、スワップによる遅延を防ぐ唯一の設定を紹介します。
モデル
自宅でLoRAをトレーニングする方法(GPUをレンタルしたほうがいい時も)
LoRAは数百メガバイトのデータで、ベースモデルに新しいことを一つ教えます:顔、商品、描画スタイル、カメラの見た目など。自宅でトレーニングするには15~40枚の写真、1~2時間、そして8GB(SDXL、Z-Image)から24GB(FLUX.2、Qwen Image)のGPUが必要です。ここに全体の流れをまとめました:ベースを選び、データセットを作り、キャプションをつけ、重要な数値を設定し、トレーニングしてテストし、自分で一晩待つより1時間48GBカードをレンタルしたほうが安いタイミングを知ること。
モデル
オープンウェイト、オープンソース、API専用:実際に何ができるのか
「オープン」はAIで最も誤用されている言葉です。モデルにはオープンウェイト(ダウンロードして実行できる)、オープンソース(トレーニングコードと何でもできるライセンスも付く)、API専用(URLと請求書が届く)の3種類があります。この違いで、オフラインで使えるか、ファインチューニングできるか、生成物を販売できるか、会社が方針を変えた後も使い続けられるかが決まります。このガイドではカタログのモデルを3つに分類し、重要なライセンス(Apache 2.0、FLUX dev非商用、Llamaコミュニティ、Stabilityコミュニティ)をわかりやすく解説し、なぜModelTrends.aiがデフォルトでオープンウェイトを優先するのか説明します。